字节笔记本
2026年10月7日 · 约 7 分钟读完
浏览器原生语音合成:做一个会发音的儿童拼音卡片页
想给家里上大班的小朋友做一个拼音练习页,第一反应往往是找个 App,或者录一套字母音频。其实还有一条轻得多的路:浏览器自己就会说话。Web Speech API 是各家浏览器内置的语音合成能力,不引第三方库、不录音频文件、不起后端服务,一份 HTML 就能做出点击发音的拼音卡片页,存进手机桌面随时能玩。整页二十七张卡片,点哪张哪张出声,小朋友自己就能上手。顺带一提,需求里写的是「WAP 页」,这个上世纪的词今天泛指的就是普通移动网页,不必纠结。本文复盘一次完整的三轮迭代:方案怎么选、卡片怎么生成、发音怎么触发、给儿童做界面要做哪些减法,以及真正的坑都埋在哪里。
三条路线,先选对再动手
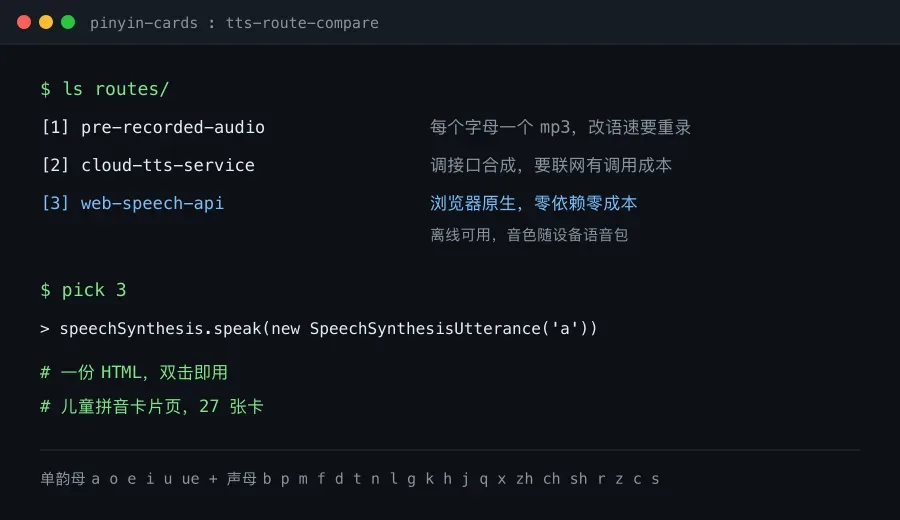
给网页里的拼音配音,常见三条路。第一条是预录音频:每个字母一个 mp3,用 Audio 对象播放,音质最可控,但二十七个字母就是二十七个文件,想改语速、换音色都得重录,打包体积也跟着涨。第二条是云端 TTS 服务:调接口返回语音,声音自然、音色丰富,但要联网、有调用成本,给孩子在地铁上、飞机上用的离线场景反而不友好。第三条是 Web Speech API:speechSynthesis 是浏览器内建的语音合成入口,把文本交给操作系统自带的 TTS 引擎发声,零依赖、零成本、离线可用,代价是音色取决于设备装了什么语音包。
给一个玩具级的教育页面,第三条几乎没有悬念:整个工程就是一份 HTML,双击就跑,拷给谁都能开。当然它也有明显的边界:音色不可控、情感表达有限,做品牌宣传、有声书这类对声音要求高的产品,仍然该走预录或云端合成。而语音数据全程不出本机,反而是它一个容易被忽略的优点——给孩子用的东西,少一次数据上云就少一分顾虑。
数据驱动:一个数组就是整套卡片
最终落地的字母表是六个单韵母(a、o、e、i、u、ü)加二十一个声母(b p m f d t n l、g k h j q x、zh ch sh r、z c s),y 和 w 未列入,一共二十七张卡片。这个顺序其实就是《汉语拼音方案》里声母表的排列,韵母打头,声母从双唇音一路排到舌尖音,顺着点下来正好是由易到难。
组织方式是典型的数据驱动渲染:一个数组存下全部字母,forEach 生成卡片 DOM,增删改都只碰数组。初版每项是 { letter, pinyin } 这样的对象,后来信息做减法,干脆退化成纯字符串数组,代码反而更短。小改动只碰数组,想补上 y、w 或者往后加复韵母,往里追加就行,页面其余部分一行不动。
布局从初版的 flex-wrap 换成了 CSS Grid:
grid-template-columns: repeat(auto-fill, minmax(80px, 1fr));一行媒体查询都不用写,窄屏两三列、宽屏五六列自动排,卡片再用 aspect-ratio 属性锁成正方形。顺带说个细节:auto-fill 和 auto-fit 长得很像,前者保留空轨道、卡片老实排队,后者把空轨道折叠、让卡片拉伸占满整行,卡片数量固定时两个都能用,想保持严格等宽就该选 auto-fill。另外给儿童做触屏界面,80px 起步的点击目标比精确到像素的视觉稿重要得多。
发音只要三行
核心代码短得出奇:
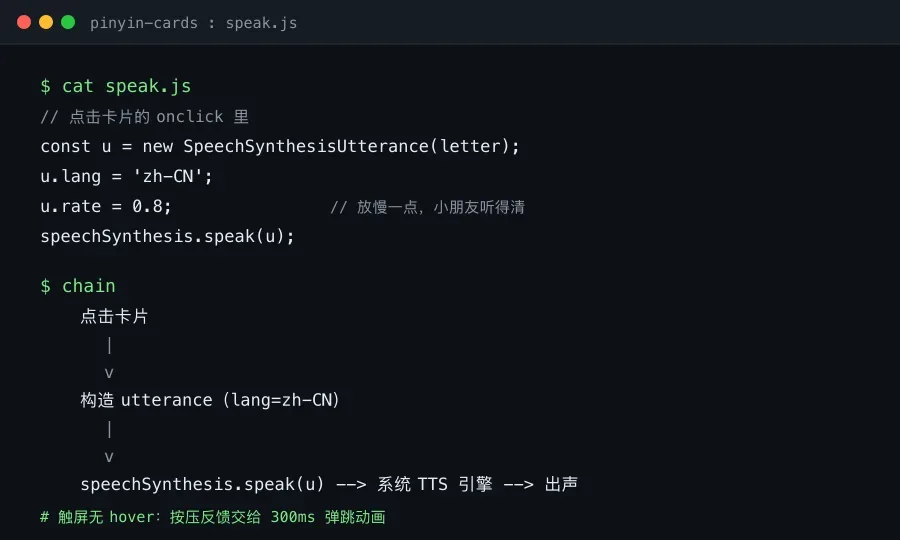
const u = new SpeechSynthesisUtterance(letter);
u.lang = 'zh-CN';
speechSynthesis.speak(u);
点击卡片时构造一个 utterance,标上中文语言标签,交给 speak() 就出声。为了让「点了有反应」不只是声音,卡片还配了弹跳或缩放动画:按下瞬间缩到 0.9,三百毫秒弹回。触屏上没有 hover,按压反馈全靠动画补。这类微交互成本极低,却是页面「好玩」的直接来源。
utterance 上还有不少可调的旋钮:rate 控制语速,给小朋友可以放到 0.8 左右;pitch 控制音调,调高一点更活泼;从 voices 列表里挑一个中文音色赋给 voice 属性,发音会更纯正。再讲究些,可以监听 onend 事件,让动画跟着语音结束一起收尾,而不是写死三百毫秒。
三轮迭代做的都是减法
这个页面前后改了三版,最有意思的不是加了什么,而是去掉了什么。第一版卡片上是「拼音字母 + 注音符号」;第二版嫌不够儿童风格,换了更鲜艳的配色和更圆润的字体,又把国际音标也堆上去,一张卡三种文字;第三版把这些全部清掉,只留拼音字母本身。理由很朴素:注音和音标是大人查字典用的,目标用户是刚认字的小朋友,信息密度一高,卡片就不好玩了。最终版还把方形卡片改成圆形,用 nth-child 选择器让黄、绿、蓝三色循环铺满,看起来像一盒彩色糖豆而不是课程表,阴影也调得很淡,只留一点悬浮感。
给儿童做界面的通用经验在这里全部应验:大色块、大圆角、大字、少字,反馈宁夸张不克制。信息越多越像教材,越少越像玩具,而孩子只会为玩具停留。
真正的坑在兼容性
上面的代码只提了一句「发音依赖设备支持」,实际落地这几件事必须处理。voices 是异步加载的:getVoices() 首次调用常常返回空数组,要监听 voiceschanged 事件等语音包就绪,再做中文音色的筛选。音频必须由用户手势触发:浏览器的自动播放策略拦着,所以发音挂在 click 事件里是对的;iOS Safari 上有时还要先「空读」一次静音的 utterance 来预热引擎。中文语音包不一定存在:没有 zh-CN 音色的设备会把拼音丢给英文引擎,读出来莫名其妙,启动时最好检测一下并给出提示。还有 zh、ch、sh 这类多字母声母,部分引擎会逐字母拼读成 z-h,稳妥的做法是读完整音节或例词,而不是字母串。
真机验证也不能省:桌面浏览器和手机的语音包是两套体系,桌面调试通过不代表手机上效果一致,最终一定以真机为准;iOS 上媒体音量和铃声走两条通道,静音键拨下去页面就哑了,别急着误判成代码 bug。
延伸一步
同一套骨架换个数组就是识字卡、英语字母卡、口算题卡;把内容抽成一份老师可编辑的 JSON,一份模板就能 serve 整个学期的卡片。再往前可以给韵母加四声各读一遍,配上例词和插图,套一个 manifest 文件就成了可离线安装的 PWA。AI 负责把想法变成整页代码,浏览器负责剩下的一切——几十行代码就能交付一个小玩具,这正是前端最好玩的地方,也是「用现成能力代替重复造轮子」最划算的一次实践。