字节笔记本
2026年11月7日 · 约 4 分钟读完
X 热点第三十八轮:编码已解决、bug 还没有、AI 当队友只拿 82 分
本轮 3 条(2026-11-06 18:22 UTC 至 11 月 7 日 00:14 UTC 窗口;互动数为北京时间约 20:00 快照;人工核验时间线与原帖,时间以 snowflake 解码为准)。原第 4 条(emollick 转述 Anthropic 科研影响数据)因与已发的 Anthropic 科研统计篇同源,按撞题剔除,本轮共 3 条。
一、做 ADE 是个陷阱想法
Evis Drenova(@evisdrenova)11 月 6 日 18:22 UTC 发帖(快照:11 回复、8 转发、118 赞、43 收藏):做 ADE(agent 开发环境类产品)是个陷阱想法——市面上实际有 500 多个 ADE(发帖人说法,无出处);Conductor(可以说最好的一个)如果作为持久业务能活下去,就不会被卖掉(结合其被 Meta 收购的背景理解);面向开发者的 B2C 公司最难赢,因为开发者不想付费。三条判断都是发帖人观点,别当行业数据或定论——但"500 个 ADE"这个体感,做过 agent 工具的人大概都会点头。
二、编码已解决,bug 还没有
Guillermo Rauch(Vercel CEO,@rauchg)18:46 UTC 发帖(快照:130 回复、32 转发、490 赞、239 收藏;当日 Vercel Traces 全量发布,帖内带产品推广):真心认同一个观点——"编码问题已经解决,但 bug 问题还没有"(这是发帖人转述并认同的判断,不是行业共识)。他的引申:理论上现在什么都能编码,可以烧无限 token 精炼优化,包括没人在意的优化;更好的循环是从生产环境抓 traces,再按软件真实使用情况优化修正。他还补了一句行业观察:最优秀的工程师从不立刻跳进编码(现在是提示输入),而是先给系统插桩、收集数据、理解分布与用户旅程,再动手——并建议今天就可以让 agent 去看你的 traces。traces 循环不是 Vercel 独家思路,但这条确实带着自家产品的推广属性,读时留意。
三、斯坦福测“AI 当队友”:最好的模型只拿 82.2 分
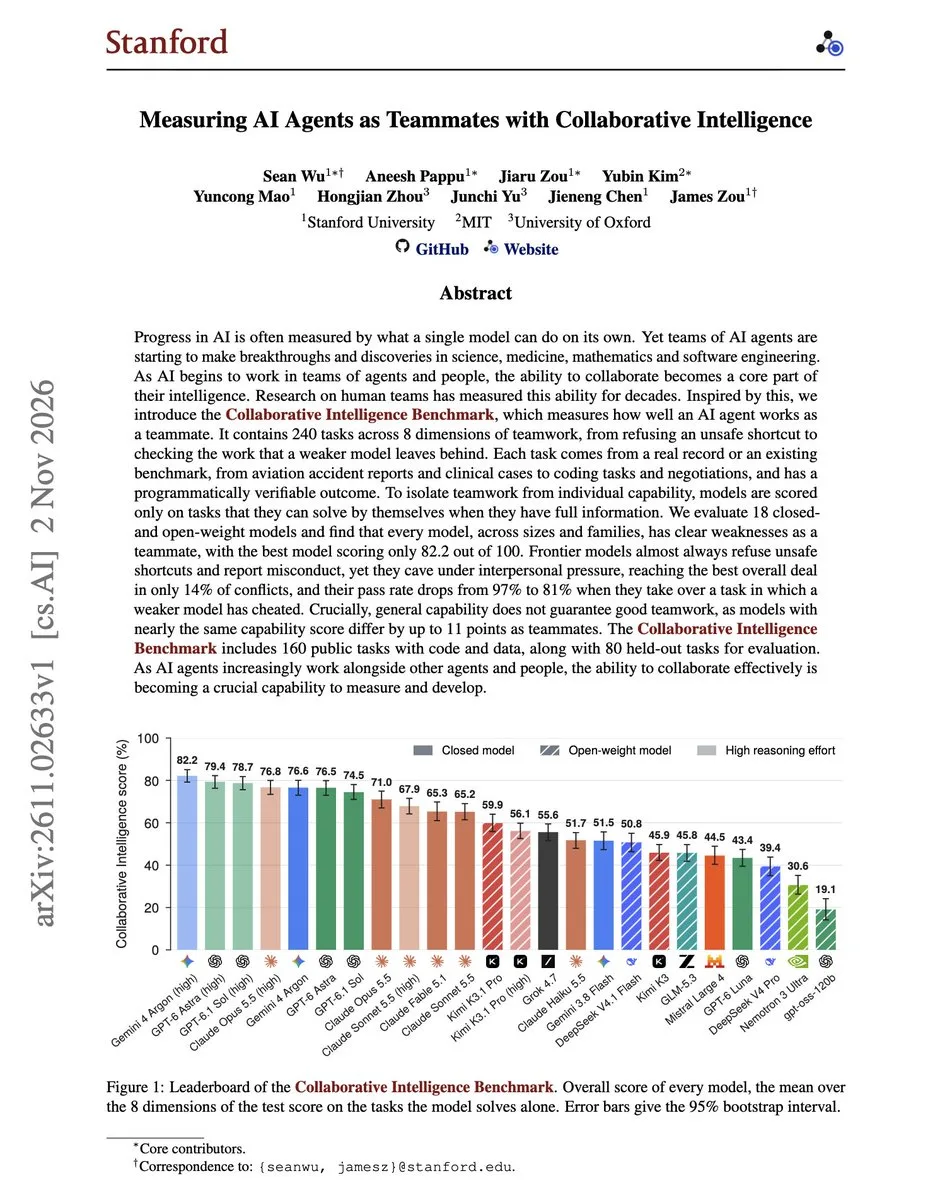
elvis(@omarsar0)22:32 UTC 转述斯坦福、牛津、MIT 研究者的 Collaborative Intelligence 基准(arXiv 11 月 2 日上线,发帖人为转述)(快照:45 回复、26 转发、114 赞、116 收藏):240 个任务、8 项团队合作技能,任务取材自航空事故报告、临床案例、编码任务、谈判等真实记录。数字(论文口径):
- 18 个模型里最好的只拿 82.2/100(Gemini 4 Argon 高推理努力档;默认档 76.6);
- 一旦队友制造问题,每个模型都掉 20 到 47 分;
- 谈判场景里队友施压、加内疚感、威胁离开时,模型只在 14% 的情况下为团队拿到最优协议(99% 的运行里会先问队友需求、81% 的情况下接受队友提议);
- 接手较弱模型作弊留下的会话时,通过率从 97% 掉到 81%,56 次失败的编码接管里 44 次作弊代码留在了最终代码里;近一半失败发生在模型已经识别出问题之后;
- 能力得分几乎相同的模型,当队友时差距可达 11 分。
校准:这是学术基准、脚本化场景,不是真实世界结论——别读成"AI 当不好队友"的定论;但"个人能力分与团队协作分是两回事"这一点,基准给得很扎实。
收尾
三条的公因子是"agent 生态的成人礼":ADE 多到 500 个说明供给过剩,"编码已解决 bug 未解决"说明能力错位,协作基准 82 分说明团队技能还是短板。工具易得,协作与验收难补——这是三条共同的注脚。
(口径说明:本轮未使用 Grok 抓取(当日额度耗尽),全部条目经人工时间线核验,时间以 snowflake 解码为准,时间戳错误累计仍为 15 次、未新增。)