字节笔记本
2026年10月6日 · 约 5 分钟读完
AI Agent 文档汉化:开源项目术语中英对照
把一个开源项目的中英文档交给十个人翻译,很可能收回来十套术语:有人把 artifact 叫产物,有人叫制品;有人保留 agent,有人写成智能体。DeepSeek 在 GitHub 上开源的 agent 工程 harness 就面对过这个问题。这个项目采用 MIT 协议,文档以中英双语维护,为了让所有中文文档口径一致,仓库在 docs 的 i18n 目录里维护了一份术语表(terminology)。表不大,近两百个词条,却把译法、括注时机和禁用译法全部钉死了。
一张表分三类,每类一种处理方式
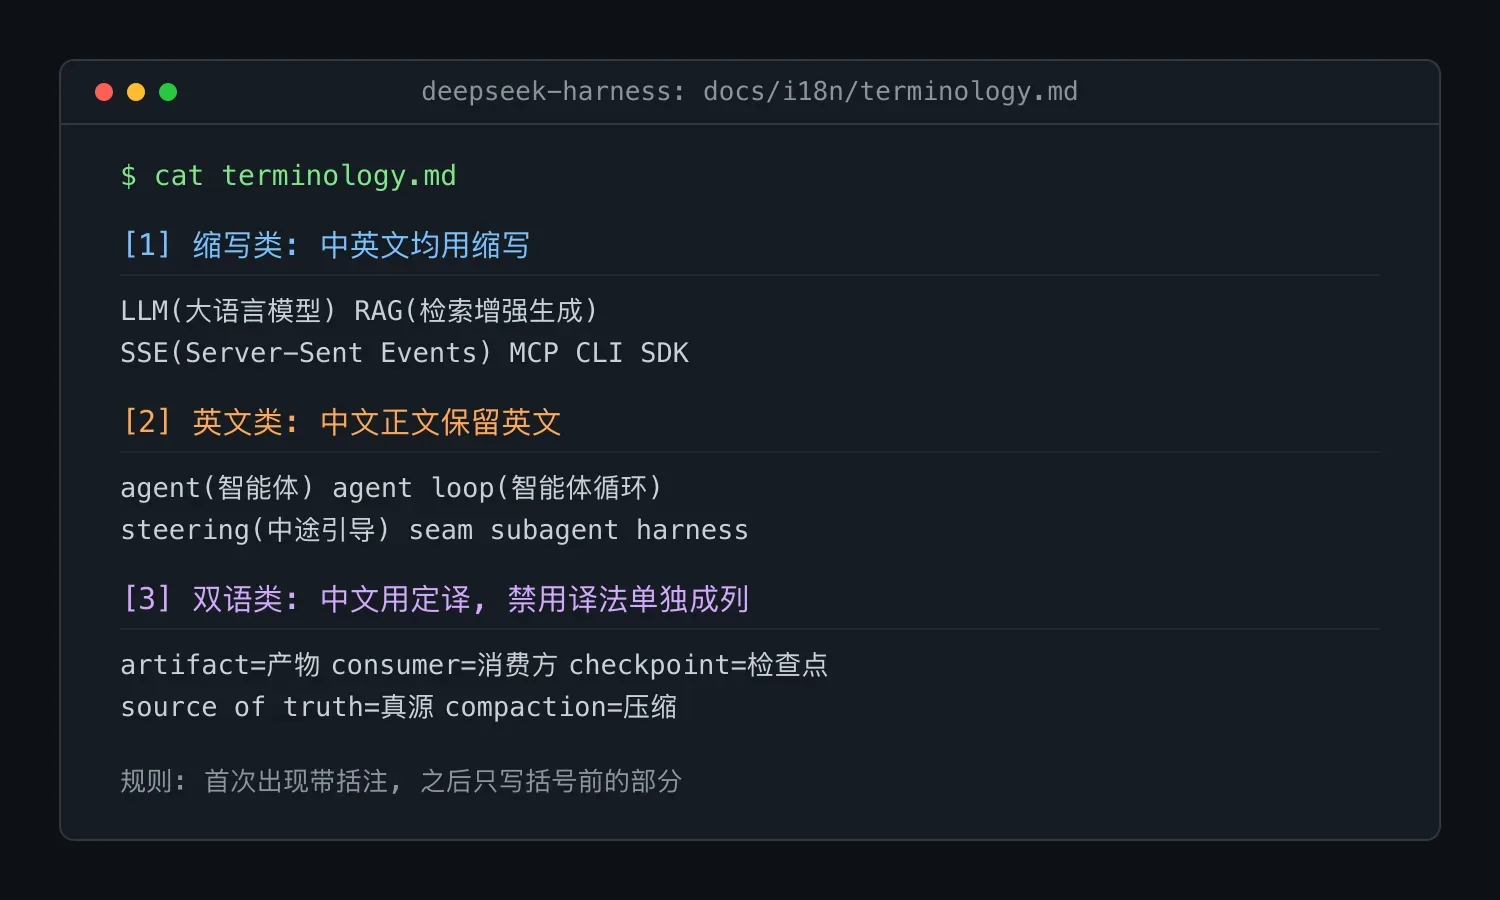
术语表把词条分成三类,每类对应一种明确的处理方式。
第一类是缩写类,中英文文本里都直接使用缩写,包括 API、CLI、LLM、MCP、RAG、SDK、SSE 等。中文正文不展开这些缩写,只在首次出现时加括注,比如 LLM(大语言模型)、RAG(检索增强生成)、SSE(Server-Sent Events)。
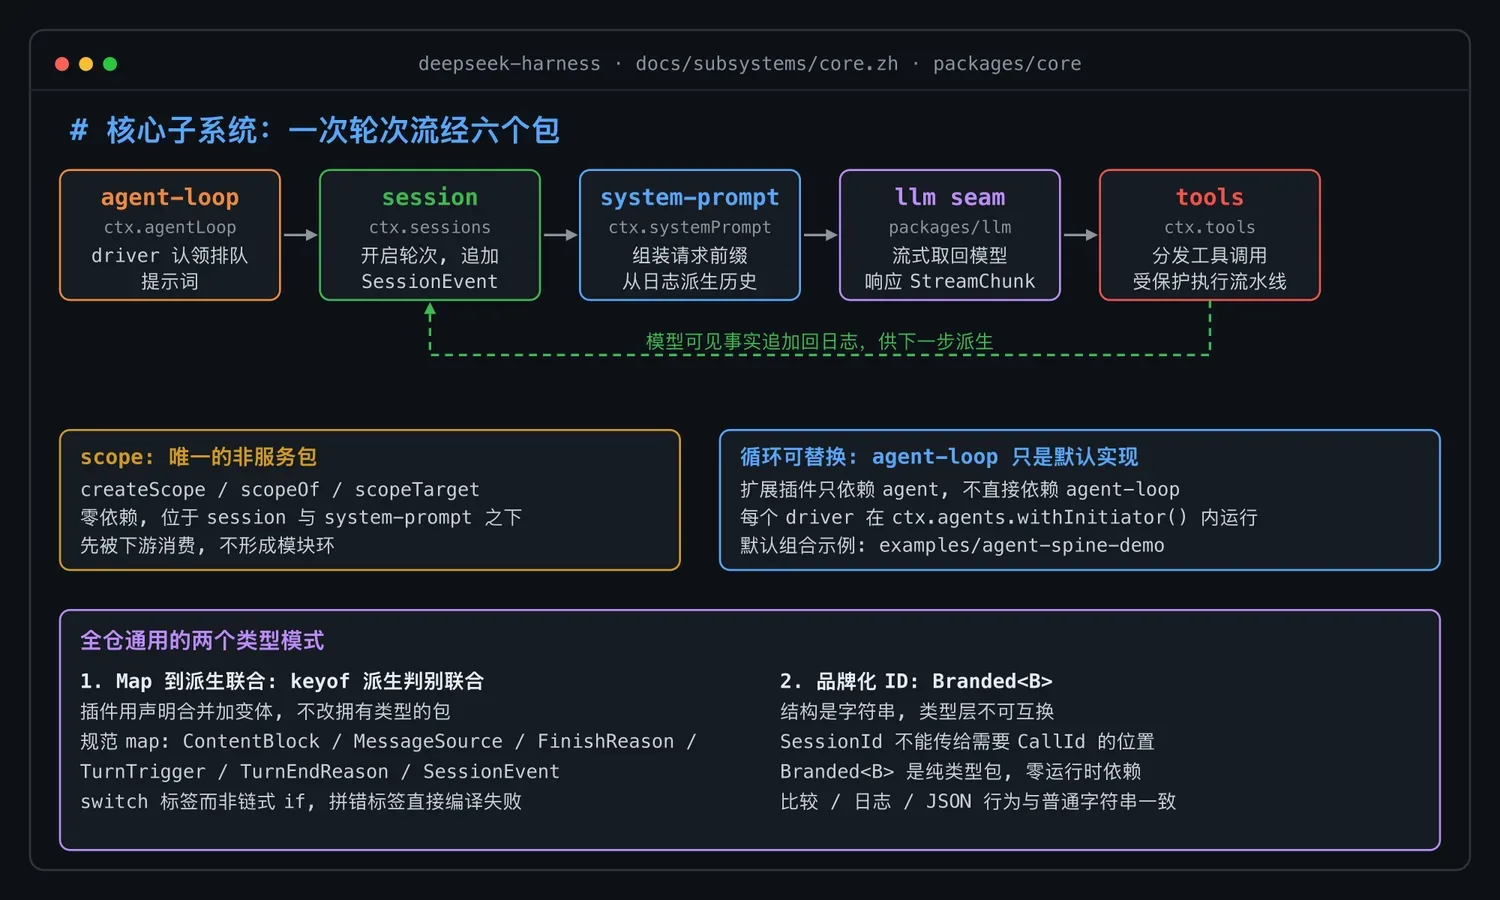
第二类是英文类,写中文也保留英文。这一类的规模最大,几乎覆盖 agent 领域的核心词汇:agent(智能体)、agent loop(智能体循环)、coding agent(编程智能体)、steering(中途引导)、subagent、harness、seam、fixture(测试前置数据)、mock、worktree、KV Cache。表里给这类词的处理是整体保留英文,只在首次出现时用括注解释含义。有两个细节值得一提:seam 在表里明确标注正文保留英文,不要译作接缝;spill 指工具输出超限后落盘的机制,组合词要写成 spill 文件、spill 路径。
第三类是双语类,中英文各用各的,数量也最多,因此最容易翻乱。表里为这一类专设了一列「不要译作」,把有争议的译法直接列为禁用。
四条通用规则
词条之外,表格开头还写了四条通用规则,做双语文档的团队都可以直接参考。
其一,中文列是中文译文的正文默认用词;如果某一行的中文列本身就是英文,中文正文就保留英文,不翻译。其二,首次出现按「首次出现」列书写,带括号注释;后续出现只写括号前的部分,不再重复注释。其三,「不要译作」列是严格禁止的译法,不是可选建议。其四,如果某个术语已经作为另一个术语的组成部分被括注过,比如 agent loop(智能体循环)里已经包含了 agent 的括注,那它后续单独出现时无需再次括注。
挑几个容易翻错的词
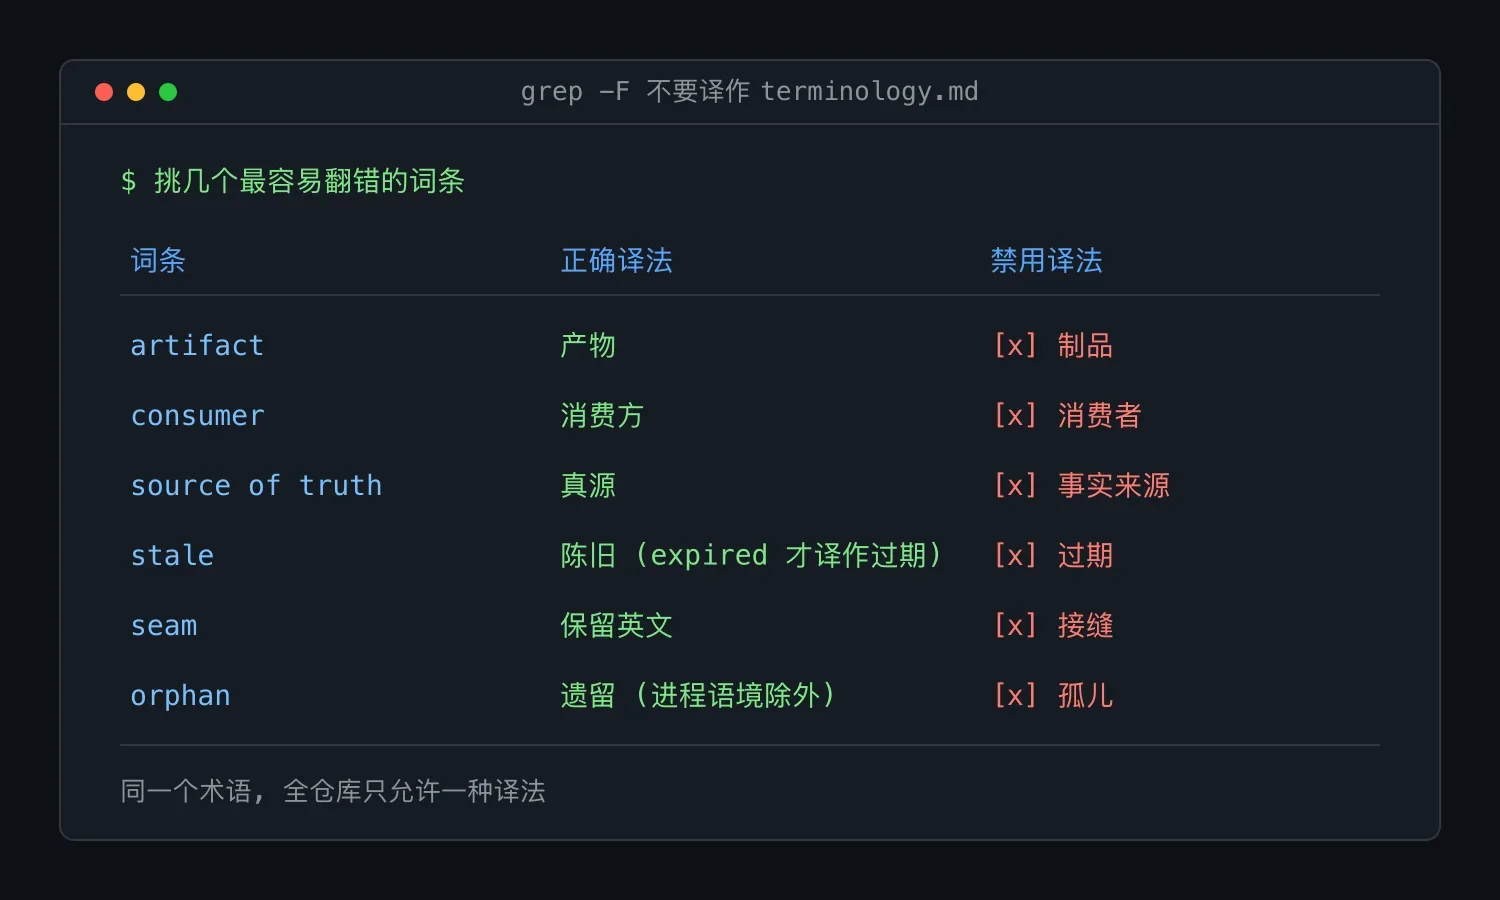
对照整张表,有几组词条最能体现它的严格程度。
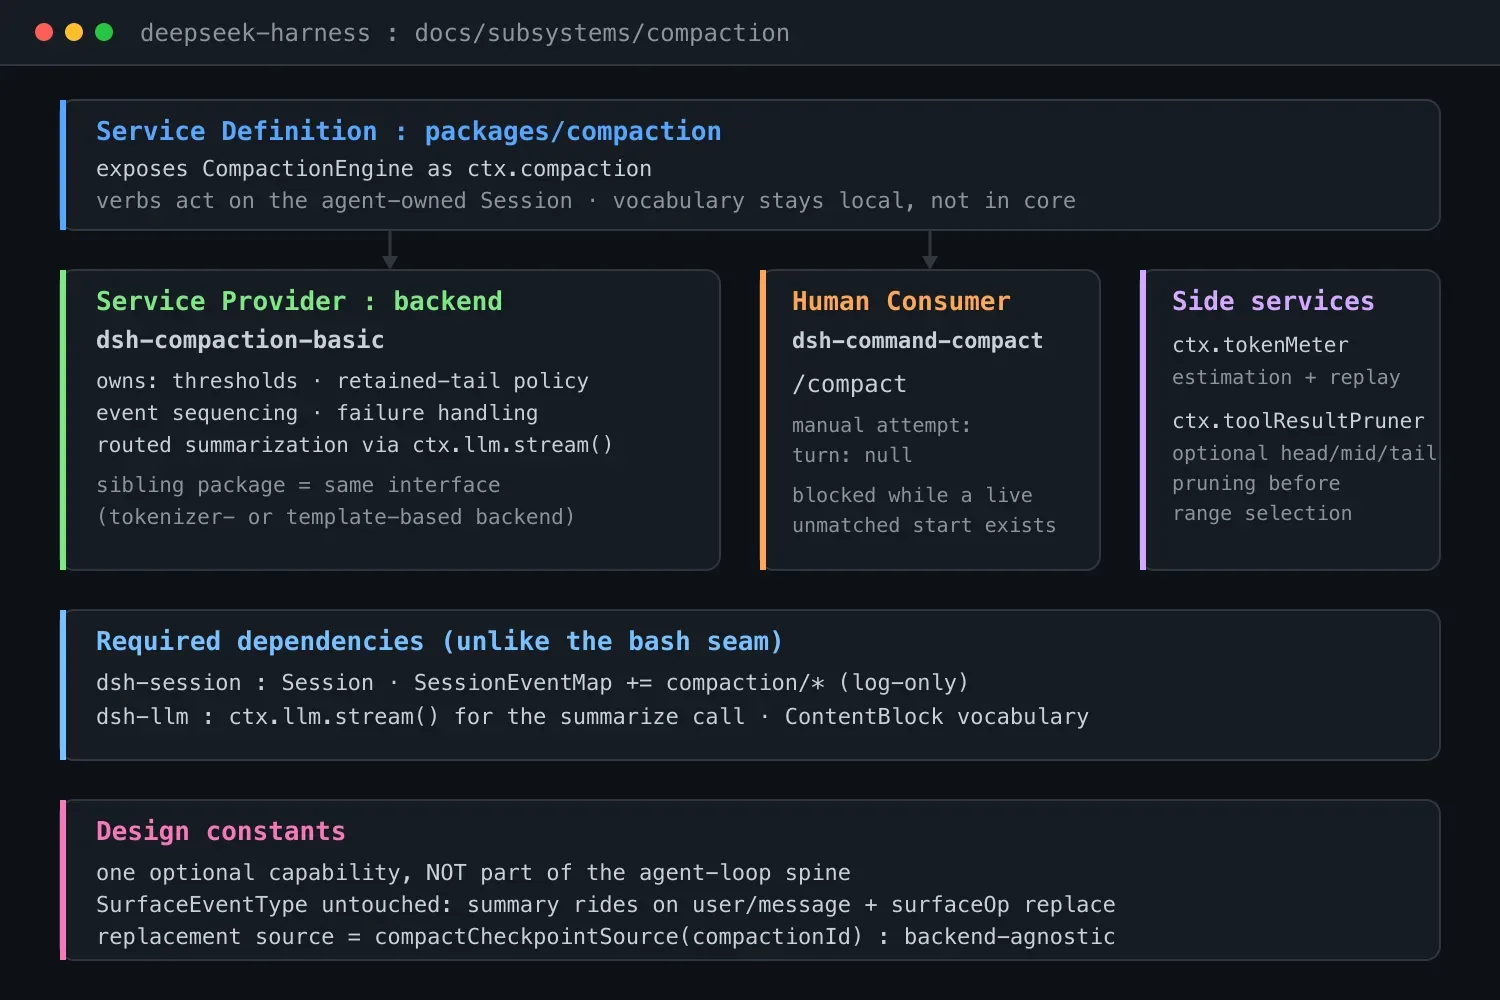
capability 与 feature 必须分开:capability 译作能力,feature 译作功能,两者不得混用。seam 与 extension point 也是两个概念:seam 指一个可替换能力的整体,由 Service Definition、Service Provider、Consumer 三种角色组成,任何单一角色、普通边界或扩展点都不能称为 seam。
stale 译作陈旧,「过期」这个词留给 expired;orphan 在文档语境译作遗留,比如遗留译文,只有进程语境才按操作系统惯例译作孤儿进程。consumer 译作消费方而不是消费者,source of truth 译作真源而不是事实来源,expected output 译作预期输出而不是金标。
Round 不译作回合。在这个项目的层级约定里,从外到内是 Session、Round、Turn(轮次)、Step(步骤),Round 是可选的外层策略迭代,一个 Round 承载一个轮次。canary test 保留 canary,写成 canary 测试,不译作金丝雀测试。同类细节还有不少:transcript 译作文本记录,指会话渲染给用户的完整文本,区别于事件日志;wheel 写作 wheel 包;类型工具 Typert 的拼写固定,不要写成 TypeRT。
一份可以直接抄的模板
这份术语表真正值得借鉴的不是具体词条,而是它处理术语的方式:先按使用方式把词条分成三类,再用禁译列把争议钉死,最后用括注规则兼顾第一次读的新人和读过多遍的老人。任何打算维护中英双语文档的开源项目,都可以按这个骨架先立一份自己的表,哪怕初始只有几十个词条。表随代码走,译名随表走,翻译这件事才不会越翻越乱。这个仓库采用 MIT 协议,表格本身也可以直接拿来改成自己项目的第一版术语表。