字节笔记本
2026年10月8日 · 约 2 分钟读完
报错能扛,假数据防不住:agent 的安静故障
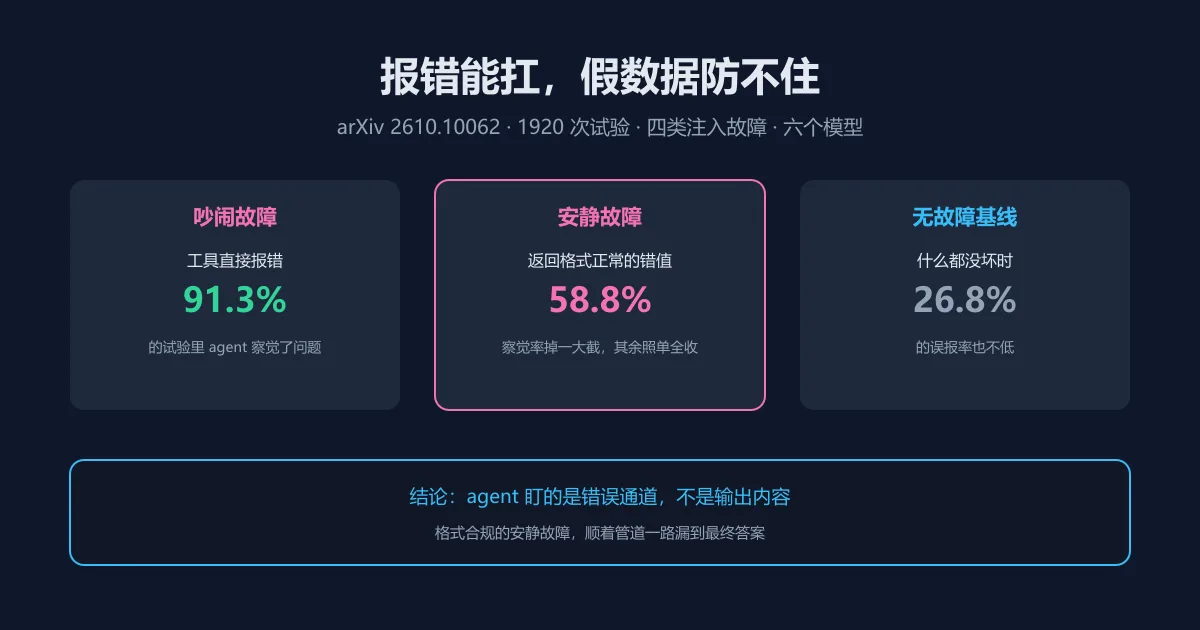
agent 的工具坏掉时会怎样?直觉答案是它会发现并重试。10 月 7 日放榜的故障注入研究(arXiv 2610.10062,作者 Obada Kraishan)把这个问题放到受控环境里测了个透:在一个成熟函数调用基准的可执行环境外面包了一层故障注入器,在轨迹的受控位置注入四类故障之一(工具缺失、超时、模式漂移、结果损坏),让三个家族的六个模型跑 1920 次试验、24 个多步任务,全程追踪它们是否察觉、是否换计划、是否恢复、是否原地打转。
吵闹与安静的鸿沟
核心数字一排就清楚:工具返回显式错误时,91.3% 的试验里 agent 举了旗;工具返回看起来合理但数值错误的结果时,察觉率掉到 58.8%;而什么都没坏时,误报率也有 26.8%。三个数合起来给 agent 的故障感知画了像:它盯的是错误通道而不是输出内容,报错通道一响就反应,格式合规的坏数据则顺着管道一路漏进最终答案。四成以上的安静故障无人认领,这才是生产环境里最贵的那类风险。
三个反直觉发现
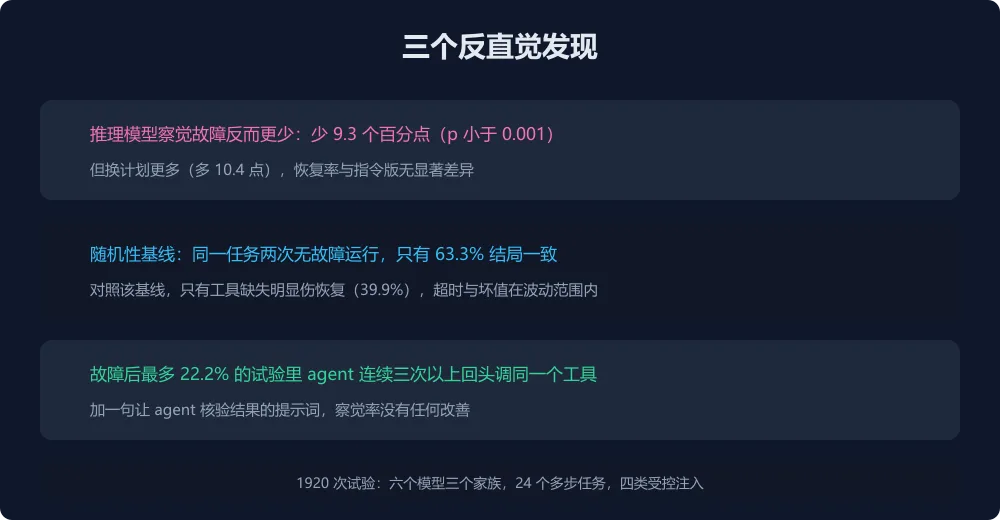
第一个反直觉:推理模型察觉故障反而比指令版少 9.3 个百分点(统计显著),换计划的次数倒多 10.4 个点,最终恢复率却没差别。推理能力买来了更勤快的转向,没买到更亮的眼睛。第二个:随机性基线。同一任务两次无故障运行,只有 63.3% 的概率得到相同结局,agent 的结局本身就在掷骰子;对照这条基线,四类故障里只有工具缺失明确伤了恢复率(39.9%),超时、模式漂移与坏值的影响都淹没在运行间波动里,很多故障分析在没有随机性基线时容易夸大。第三个:故障之后,最多 22.2% 的试验里 agent 连续三次以上回头调同一个工具,原地打转是常见应激反应;而给提示词加一句要求核验每个结果,察觉率毫无改善,靠嘴嘱咐是不管用的。
工程启示
三条可落地的结论:其一,故障检测不能指望 agent 自觉,得在工具层加独立校验,比如对关键返回值做范围检查或交叉验证,把安静故障变回吵闹故障;其二,评测 agent 要先测随机性基线,否则分不清是真退步还是天然波动,两次运行的结局差异本身就是必须量化的指标;其三,别迷信推理模型的故障感知,选型时把察觉率单列一栏。这篇与 WebFovea 互为表里:那边证明故障常在管道层,这边证明即便到了 agent 眼前,安静的那类也多半看不见。论文未附代码,方法论(四类故障注入加随机性基线)可以照搬进内部验收。