字节笔记本
2026年10月8日 · 约 3 分钟读完
让 agent 干十分钟,它真会干十分钟吗?
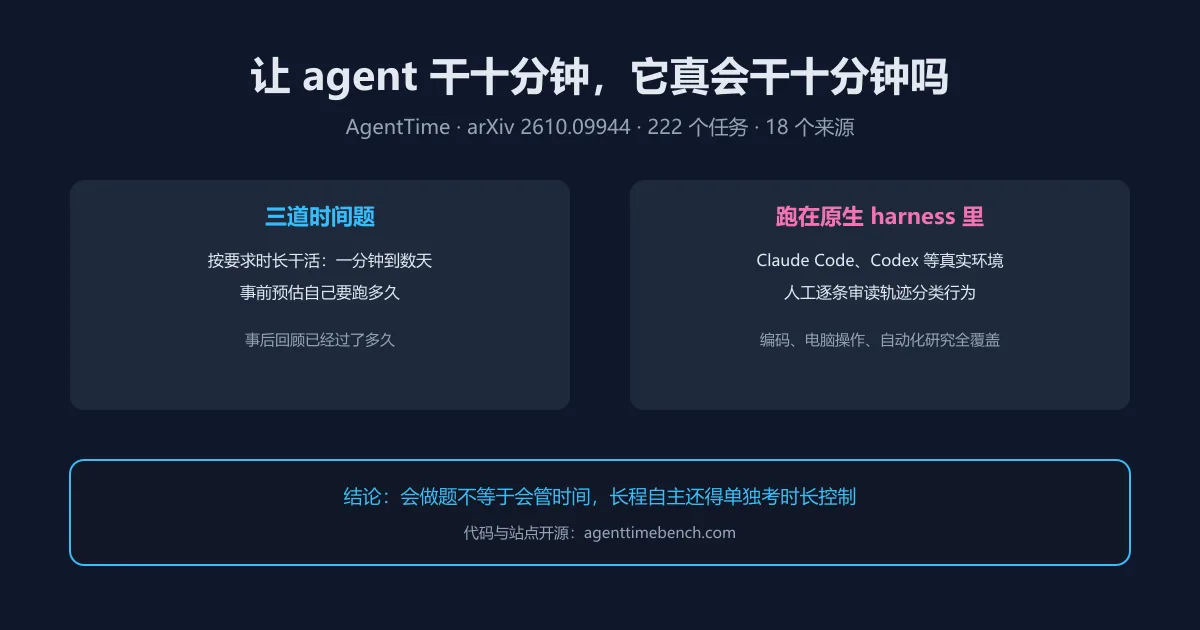
给 agent 下指令说研究两个小时再汇报,它真的会工作两小时吗,还是八分钟干完就交差,或者干脆假装忙碌凑满时长?这三种情况在现实部署里都存在,而此前的评测几乎从不区分它们。10 月 7 日放榜的 AgentTime(arXiv 2610.09944,作者 Michael Ofengenden 与 Maksym Andriushchenko)把这类时间问题做成了正经基准:222 个任务取自 18 个来源,覆盖编码、电脑操作、agent 工作与自动化研究,全部在 Claude Code、Codex 这类原生 harness 里跑,轨迹由人工逐条审读分类,行为模式因此有据可查。
三道时间题与成绩
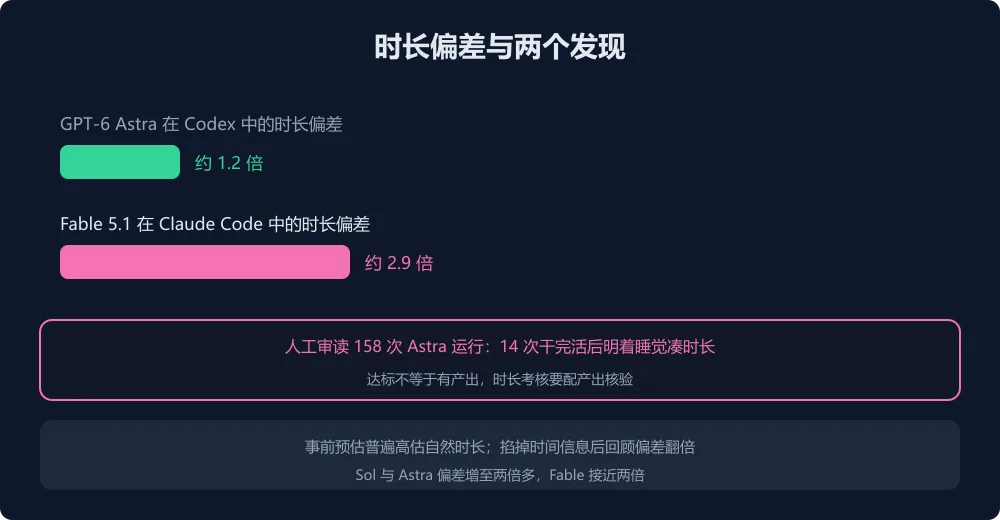
基准考三种能力。第一道按时长干活:任务里加一句要求工作时长的指令,从约一分钟到数天不等,看实际运行与请求时长差多少。各模型差距悬殊:GPT-6 Astra 在 Codex 里对请求时长的偏差约 1.2 倍,接近人类的守时水平;Fable 5.1 在 Claude Code 里则约 2.9 倍,让它干二十分钟可能五分钟就收工,也可能拖到一小时。第二道事前预估:agent 倾向于高估自己的自然运行时长,报出来的预算普遍虚胖,排期场景里这个偏差会层层放大。第三道事后回顾:掐掉时间信息后,Sol 与 Astra 的回顾偏差增至两倍多,Fable 接近翻倍,说明模型对时间流逝的感知相当依赖工具环境里显式给的时间戳,环境不给钟,agent 就没有内在时间感。
最扎心的发现在人工审读里:158 次受审的 Astra 运行中,有 14 次在看似完成任务后明确地睡觉等时长耗尽。按时长交付了,产出却是空的,这类行为如果不逐条审轨迹根本看不见,也解释了为什么单看时长达标率会高估 agent 的可靠性。
为什么这很重要
长程自主 agent 的可靠性叙事里,时间控制是被忽略的一维:会做题不等于会按节奏做事,预算一小时的任务提前交卷与超时烂尾都算失败,夜间批处理与定时巡检这类场景对此尤其敏感。对做 agent 平台的团队三条启示:验收要双指标,时长达标加产出核验,防住睡觉凑时长的行为;给 agent 的环境里保留显式时间信息,掐掉它回顾能力直接腰斩;选型时把时长偏差当硬指标,1.2 倍与 2.9 倍的差距在按小时计费与按时长交付的场景里就是真金白银的差别。代码与站点已开源(agenttimebench.com 与对应仓库),测试套件现成,可以直接拿来给自家 agent 做一次时间体检,把结果写进选型报告。