字节笔记本
2026年10月8日 · 约 2 分钟读完
没有标准答案的科学题,agent 能考过人类模型吗?
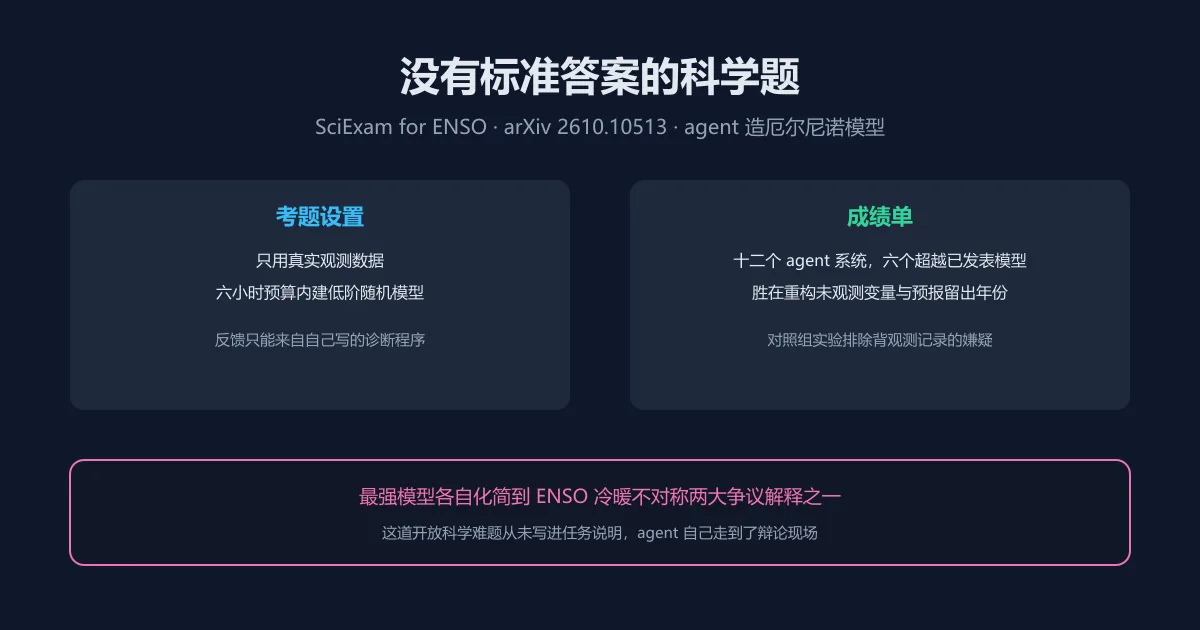
评测 agent 的题目几乎都有已知答案,模型可能只是背过。10 月 7 日放榜的 SciExam for ENSO(arXiv 2610.10513,作者 Yinling Zhang、Mengdi Wang 等)造了一道没有标准答案的题:让 LLM agent 用真实观测数据建厄尔尼诺-南方涛动(ENSO)的低阶随机模型。ENSO 是年际气候变率的主导模态,其完整机制至今没有定论,考的就是真刀真枪的开放式科学。
考题与流程
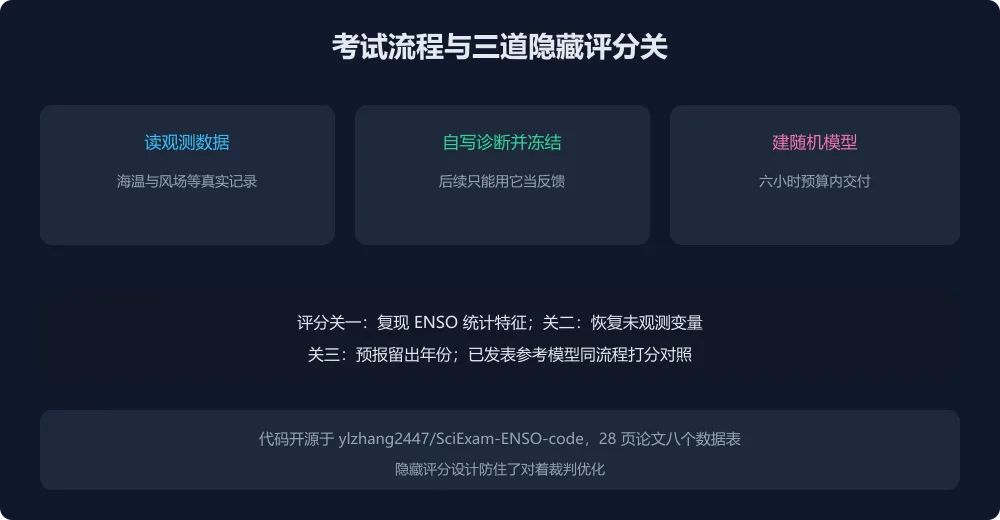
约束设计得很硬:六小时预算内,agent 先读观测数据并亲手写自己的诊断程序,写完即冻结;随后建模阶段只能拿这些自己写的诊断当反馈,不能调用任何现成评估器,等于逼它先学会给自己造尺子再量东西。交付的模型要过三道隐藏评分关:复现 ENSO 的统计特征、恢复未观测变量、预报留出的年份;一篇已发表的参考模型用同一流程打分作对照,胜负一目了然。评分对 agent 不可见,对着裁判优化这条路被堵死。
成绩单与意外发现
十二个受测 agent 系统里,六个建出了总分超过已发表参考模型的模型,优势主要来自更好的变量重构与年度预报,这个通过率本身就很说明问题。更有意思的是科学侧的意外:表现最强的那些模型,各自化简后的形式恰好落在 ENSO 冷暖不对称的两大对立解释之一的框架内,而这场学术争鸣从头到尾没写进任务说明。也就是说,agent 不是复读教科书,而是被数据推到了当前该领域辩论的分岔口,两条理论路线各自都有 agent 走通。作者还做了对照实验:把最强系统在打乱或替换的观测数据上重跑,确认它不是在背诵历史观测记录,输入信息确实在影响模型构建。作弊通道逐一关死之后,成绩才立得住。
怎么读这份工作
方法论上的可迁移点有三条:其一,自写诊断再冻结,是防止 agent 借助现成工具藏拙的好机制,内部评测可以直接抄;其二,隐藏评分加已发表参照物,给没有标准答案的任务提供了可比较的锚点;其三,对照实验排除记忆作弊的流程,值得写进任何 agent 科研评估的检查清单。代码开源于 ylzhang2447/SciExam-ENSO-code,二十八页论文带八个数据表,细节充分。留一分清醒:六个胜过参考模型,意味着另外六个没赢,开放式科学里 agent 的通过率还远谈不上稳定,这份基准的价值恰恰是把这条能力线第一次清晰地画了出来,后续每一个模型都能来此对表。