字节笔记本
2026年10月8日 · 约 2 分钟读完
记忆错在检索之前:agent 个人记忆的三种坏法
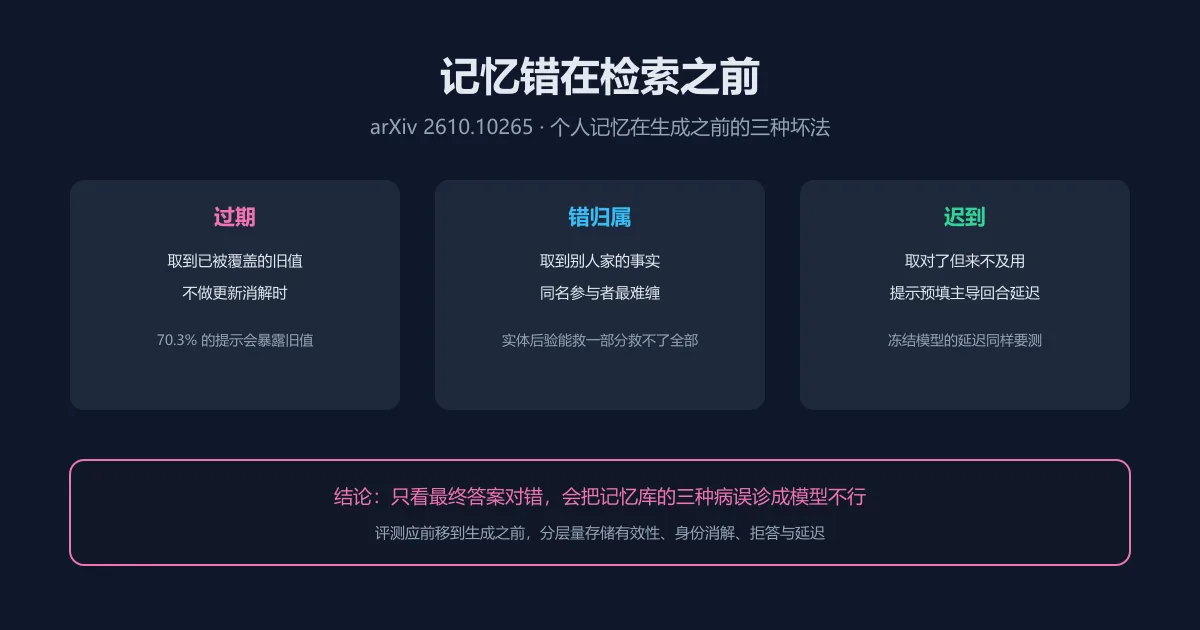
带记忆的 agent 答错了,锅该谁背?常见做法是看最终答案对不对,错了就怪模型或怪记忆库,但答案错误可能只是症状。10 月 7 日放榜的论文(arXiv 2610.10265,作者 Haonan Deng 与 Park Sinchaisri)把测量点前移到生成之前,给个人记忆系统画了张精确的病理图:错误在检索发生之前就已经埋下了。
三种坏法
第一类是过期:检索到已被覆盖的旧值。不做更新消解时,70.3% 的提示会暴露一个被取代的旧事实;而只服务正确键位上的活跃值,过期暴露可以清零。第二类是错归属:取到关于别人的事实,同名参与者最难缠。实体后验过滤在受控数据上能压下同名错归属,但在 LoCoMo 这种同姓名说话人共存的语料里无能为力,身份消解没有银弹。第三类是迟到:取对了但服务太慢,提示预填主导回合延迟,连冻结模型的延迟都要纳入评测。
瓶颈定位
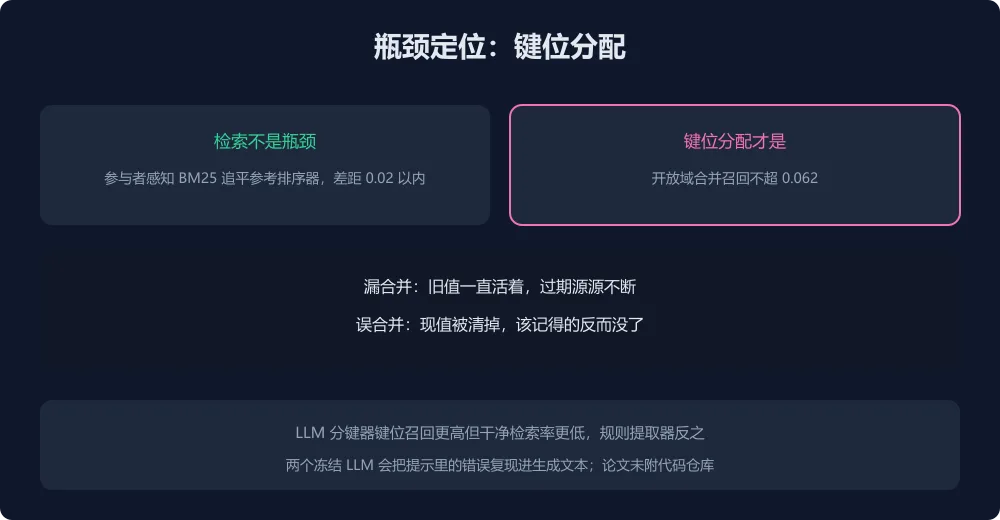
方法上,论文用个人事实记忆(PFM)当参照层,在受控修订基准、LongMemEval 与 LoCoMo 三处测试。结论对工程最有价值的一条是瓶颈定位:检索不是问题,参与者感知的 BM25 与参考排序器的差距在预设的 0.02 以内;键位分配才是真瓶颈,开放域合并召回在 LongMemEval 上从不超过 0.062。漏合并让旧值一直活着,过期源源不断;误合并把现值清掉,该记得的反而没了。两难也摆在桌面:LLM 分键器键位召回更高但干净检索率更低,规则提取器正好相反,怎么选要看业务更怕哪一种错。两个冻结 LLM 会把提示里的错误原样复现进生成文本,证明生成前的脏数据不会被模型自动洗掉。
评测该分四层
作者的处方值得抄进内部评测:把记忆评测拆成存储状态有效性、身份消解、拒答能力和服务延迟四层,分开量分开报。这与我们此前介绍的 DSV-Mem(状态演化是主导难度因子)互相印证:记忆系统的病大多不在语义理解,在状态管理与身份绑定这些数据库时代的经典问题。给做记忆系统的团队三条实操:更新消解与活跃值服务先行,能消灭最大头的过期暴露;键位分配上双路并行,规则保底、LLM 提召回,再用合并校验兜住两种错;同名人场景单独立测,别让平均分掩盖身份灾难。论文未附代码仓库,方法描述可照搭内测。