字节笔记本
2026年10月8日 · 约 2 分钟读完
哪些底座值得练成 agent?英伟达的三道筛子
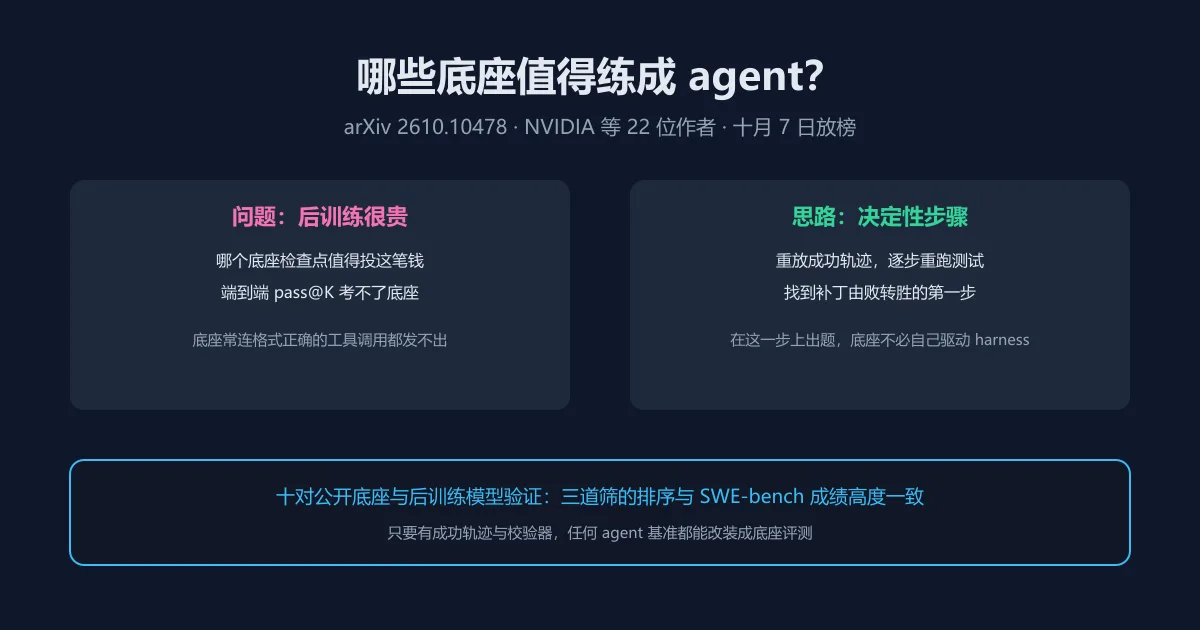
把一个底座模型练成能干的 coding agent,后训练的成本以数十万美元计,选错检查点全部打水漂。问题是底座模型没法直接考:跑端到端 pass@K,底座常常连格式正确的工具调用都发不出来,任务根本走不完;拿短程单步基准考,又绕开了长程多步维持状态这个 agent 核心能力。NVIDIA 牵头的 22 人团队 10 月 7 日放榜的论文(arXiv 2610.10478)给出了一套绕开死结的筛法。
决定性步骤
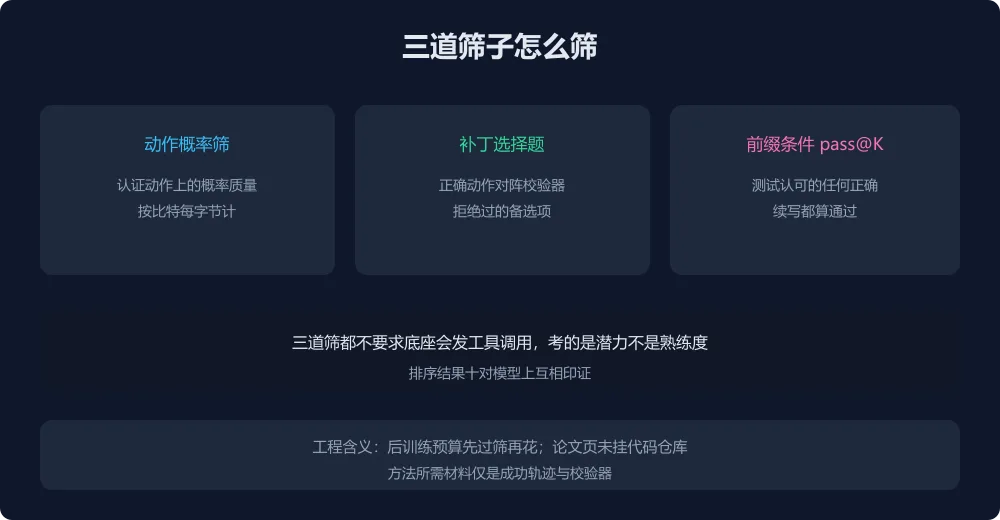
核心概念是决定性步骤:拿后训练成功 agent 的轨迹来重放,每走一步代码修改就重跑一次测试,找到累积补丁让仓库从失败翻转为通过的第一个动作,那一步就是这道题的胜负手。这个定义把漫长轨迹里真正起作用的那个瞬间隔离出来,前后的探索、回退、格式整理全部剥掉,考题因此变得又短又准。在决定性步骤上出题,底座模型不需要自己驱动整个 harness,考的是潜力而非熟练度,恰好补上了端到端评测对底座失灵的窟窿。三道筛子分别是:动作概率筛,量底座在认证动作上的概率质量,按比特每字节计,底座越把概率押在正确动作上得分越高;补丁选择题,让正确动作与校验器拒绝过的备选项打对台,考的是分辨力;前缀条件 pass@K,只要续写能通过测试就算数,不要求逐字复刻参考答案,给多样的正确解法留了门。
验证与含义
在十对公开的底座与后训练模型上,三道筛各自给出的排序都与后训练模型在 SWE-bench Verified 上的 pass@1 表现高度一致,三条独立证据互相印证,谁也不是偶然。更实用的是方法的自适应面:它只需要目标基准的成功轨迹和校验器,任何新的 agentic 编码基准都能就地改装成底座评测,团队自建的内部基准同理。对训模型的团队,这是投钱前的体检:先花小成本过三道筛,筛不出的底座省下一笔后训练预算,把资源集中到真正有潜力的检查点上;对做基准的团队,这提供了把 agent 基准反向卖给底座评测市场的思路。论文页未挂代码仓库,复现要等作者放料,方法描述已足够细。
这篇与本周的 SWE-Game、ReviewBench 放在一起看,评测这条线正在快速专业化:考 agent 的、考评审 agent 的、考底座潜力的,各就各位。基建成熟的速度,比大多数人预期的快。