字节笔记本
2026年10月8日 · 约 3 分钟读完
一亿条 PR 里挑考题:GitHub 给评审 agent 定了标尺
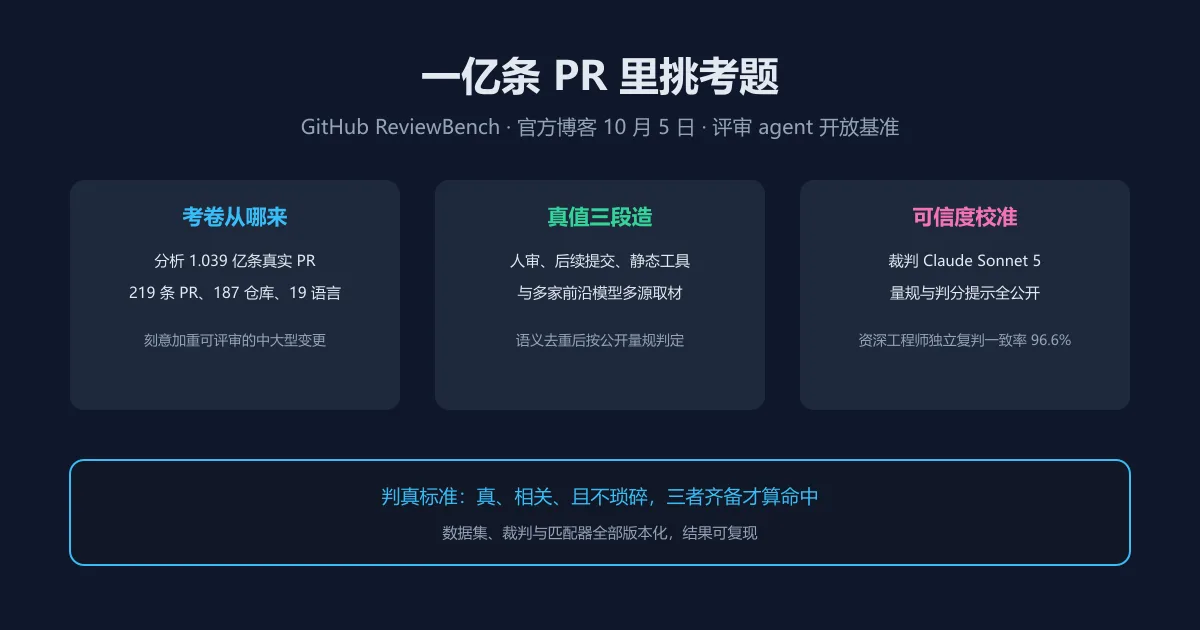
AI 代码评审 agent 的跑分一直难以服众:演示集太小、标注来路不明、跟真实评审场景脱节。GitHub 10 月 5 日在官方博客发布开源基准 ReviewBench,思路是把考卷直接建在真实世界的分布上,配套的真值与判分方法全部公开。同名先例需要说明:LangChain 七月底也独立发布过一个叫 ReviewBench 的评审基准,两者没有隶属关系,本文讲的是 GitHub 官方版本。
考卷怎么出
代表性是第一卖点。团队分析了 1.039 亿条真实 PR,按语言、仓库规模、变更形态的分布抽样,最终考卷含 219 条 PR、来自 187 个开源仓库、覆盖 19 种语言,并刻意加重可评审的中大型变更占比,避免被单文件小改动灌满。真值标注走三段流程:先从人类评审意见、作者后续提交、确定性静态工具与多家前沿模型多源收集候选发现;语义去重合并;再按公开量规判定,一条发现必须同时满足真、相关、不琐碎才算命中。裁判用 Claude Sonnet 5,量规与判分提示词全部公开;未参与建库的资深工程师对所有真值独立复判,一致率 96.6%。数据集、裁判与匹配器全部版本化,跑分可复现。
六项指标与线上验证
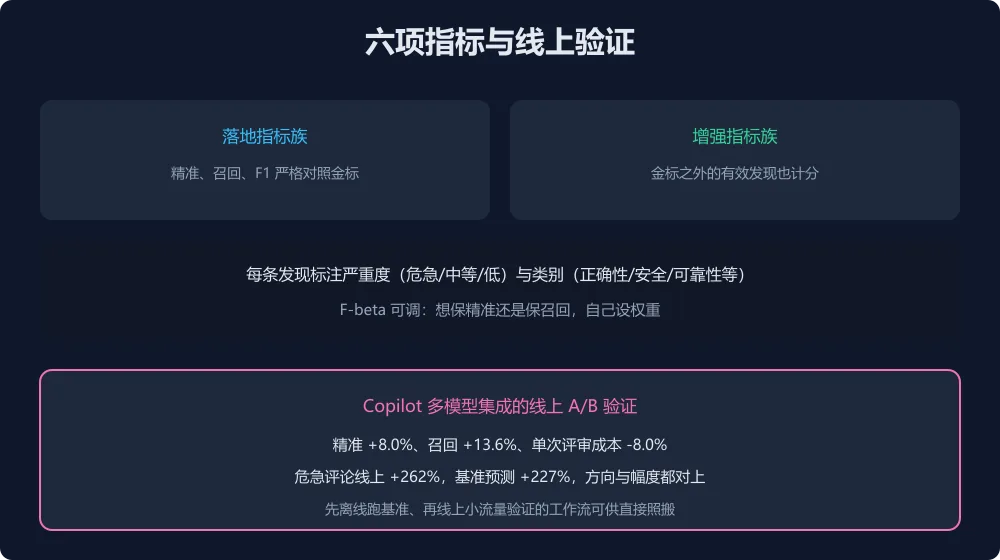
指标分两族:落地精准、召回与 F1 严格对照金标,是跨系统比较的主口径;增强指标族则给金标之外的有效发现也计分,鼓励 agent 找出建库者都没找到的问题。每条发现标注严重度与类别(正确性、安全、可靠性、可维护性、测试等),用户可按自己的偏好调 F-beta 权衡精准与召回。最有说服力的是闭环验证:GitHub 用它指导 Copilot 评审的多模型集成实验,随后线上 A/B 复核,精准加 8.0%、召回加 13.6%、单次评审成本降 8.0%,危急评论线上涨 262% 对基准预测的 227%,方向与幅度都对上了。先离线基准、再小流量验证的工作流,值得所有做评审工具的团队照搬。
怎么用
参与门槛不高:用 GitHub 账号登录官网,注册 agent 的容器镜像与配置,自带模型钥匙(裁判由官方提供);先在 25 条 PR 的测试集上调参,再跑三轮完整 219 条基准;成绩默认保密,只有超过榜单既有条目的改进才会公开。对评审工具的开发者,这份基准把比较的公共地面划出来了;对采购方,六项指标加严重度切片就是现成的验收清单。把上周 Pragmatic Engineer 报告里评审表演化的判断连起来读:当评审越来越多的由 agent 完成,衡量评审质量的地板就必须先立起来,ReviewBench 就是那块地板。