字节笔记本
2026年10月6日 · 约 8 分钟读完
上下文工程入门:Agent 的“记忆”是怎么工作的
本文是 AI 编程(Agentic Coding)系列教程的第 6 篇。环境配好、模型选完之后,几乎每个新手都会撞上同一个问题:明明刚才告诉过 Agent 一件事,过几分钟它就忘了,甚至做出和你的要求完全相反的动作。这不是模型“笨”,而是它的“记忆”有自己的规律。理解并管理这套规律,就是上下文工程(Context Engineering)的入门功课。
上下文是什么:先从做菜说起
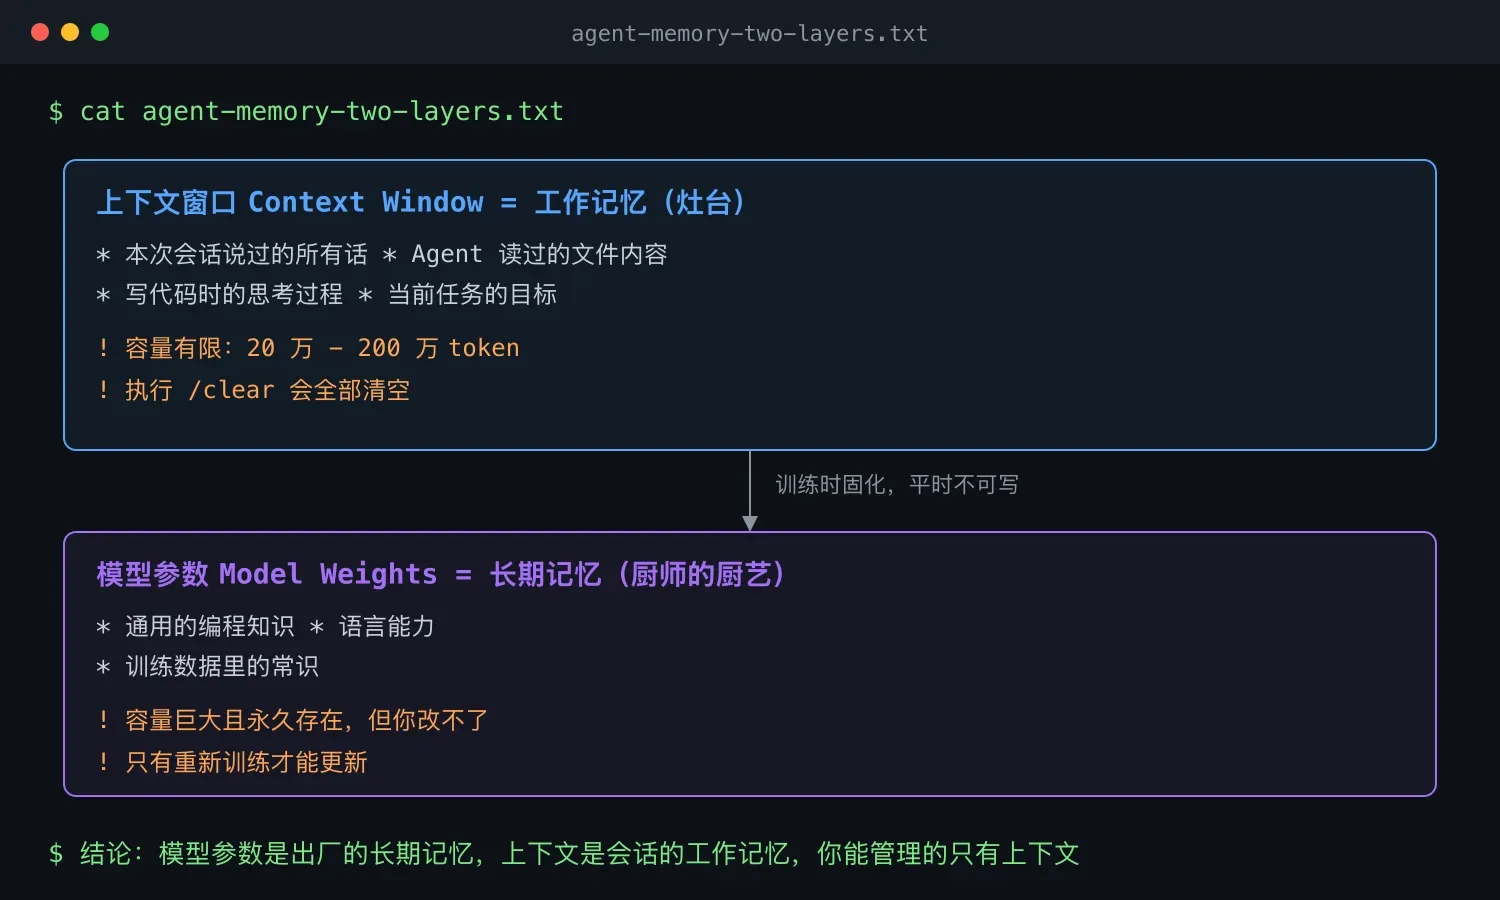
想象你在厨房做一道菜,此刻你的“工作记忆”里装着什么:刚查的菜谱、刚从冰箱拿出来的食材清单、前面已经完成的步骤(比如刚切完葱)、朋友刚才提醒的“少放盐”,还有你十年积累下来的厨艺。
Agent 的工作记忆结构完全一样,只是分成两层,性质截然不同。
第一层是上下文窗口(Context Window),相当于“灶台”。里面装着:这次会话说过的所有话、Agent 读过的文件内容、它写代码时的思考过程、当前任务的目标。它有两个硬约束:容量有限,不同模型从 20 万到 200 万 token 不等;而且你一敲 /clear,它就全部清空。
第二层是模型参数(Model Weights),相当于“厨师的厨艺”。里面是通用的编程知识、语言能力、训练数据里的常识。它容量巨大、永久存在,但你改不了,只有重新训练才能更新。
一句话记住:模型参数是出厂设置的“长期记忆”,上下文是这次会话的“工作记忆”。你能管理的,只有上下文。
上下文窗口:为什么塞太满会出事
容量上限看起来很大,其实非常容易塞满。有三个典型的“内存杀手”。
杀手一:长对话历史。每轮对话都会累加,第 1 轮你说 100 token、它回 300 token,累计 400;到第 50 轮,光历史就可能累计到 2 万 token,按 20 万的窗口算已经吃掉十分之一。
杀手二:大文件。让 Agent 读一个 1 万行的文件,等于一次性吃掉几万 token;读上几个,上下文就满了。
杀手三:Agent 自己的思考。写复杂代码时它会“打草稿”,这些草稿同样在消耗上下文。
塞满之后会发生什么?就像厨房工作台堆满食材,厨师找不到菜谱,开始乱抓东西,做出来的菜自然不对。对应到 Agent,是四个常见症状:忘了你明确说过的话;把 A 文件的逻辑写进 B 文件;越改越乱,每改一处坏一处;输出质量明显下降,注意力被无关内容稀释。
一个实用的判断口诀:会话超过 30 分钟还没 /clear,就要警惕了。
让 Agent 记得牢的五个技巧
技巧一:一次只做一件事。 这是本篇最重要的工作习惯。反例是一句“帮我做三件事:建数据库、写后端、做前端页面”,Agent 会在三件事之间反复横跳,最后每件都做不好。正例是切片推进:“第一步:建数据库 schema,只做这一步,做完等我确认”,确认之后再进入第二步。
技巧二:用 CLAUDE.md 沉淀“项目宪法”。 每次 /clear 后,Agent 会忘掉项目背景。解决办法是在项目根目录放一个 CLAUDE.md,Agent 每次启动都会自动读它。把项目介绍、技术栈、命名规范写进去,一次写好,长期受益。
技巧三:让 Agent 主动复述需求。 复杂任务开始前加一句:“在开始写代码前,请先用 3 句话复述你理解的需求,并列出 3 个你想确认的问题。”这样能提前暴露理解偏差,避免写了半天白写。
技巧四:精准引用,不要全部喂进去。 反例是“看看整个项目(100 个文件)哪里有性能问题”;正例是“重点看 src/api/orders.py 的第 50 到 120 行,这里处理订单查询,怀疑有 N+1 查询问题”。给出的范围越准,上下文越干净。
技巧五:建立工作日志习惯。 复杂项目让 Agent 维护一个 progress.md,每完成一个功能就记录:做了什么、改了哪些文件、还剩什么没做、下一步建议。这样即使 /clear,新会话读完这个文件也能秒速恢复上下文。
案例:一次“记忆崩溃”事故复盘
一位学员做 Web 项目时完全没管理上下文:一个会话连干 2 小时,让 Agent 读了 5 个文件、每个 5000 行,来回改了 30 多轮需求,最后补一句“再加一个登录功能”。
结果是灾难式的:Agent 把“登录”和之前的“注册”逻辑搞混;改完之后,原本正常的“商品列表”功能也坏了,越改越烂。事后诊断发现,上下文已经塞进约 80 万 token,接近上限,注意力被严重稀释,Agent 等于在“梦游”。
重做一遍只花 30 分钟,全程零 bug。流程是:先 /clear 重置;让 Agent 读 CLAUDE.md 拿回项目背景;只让它做“登录功能”这一件事;测试通过后再 /clear;下一个任务重新开始。
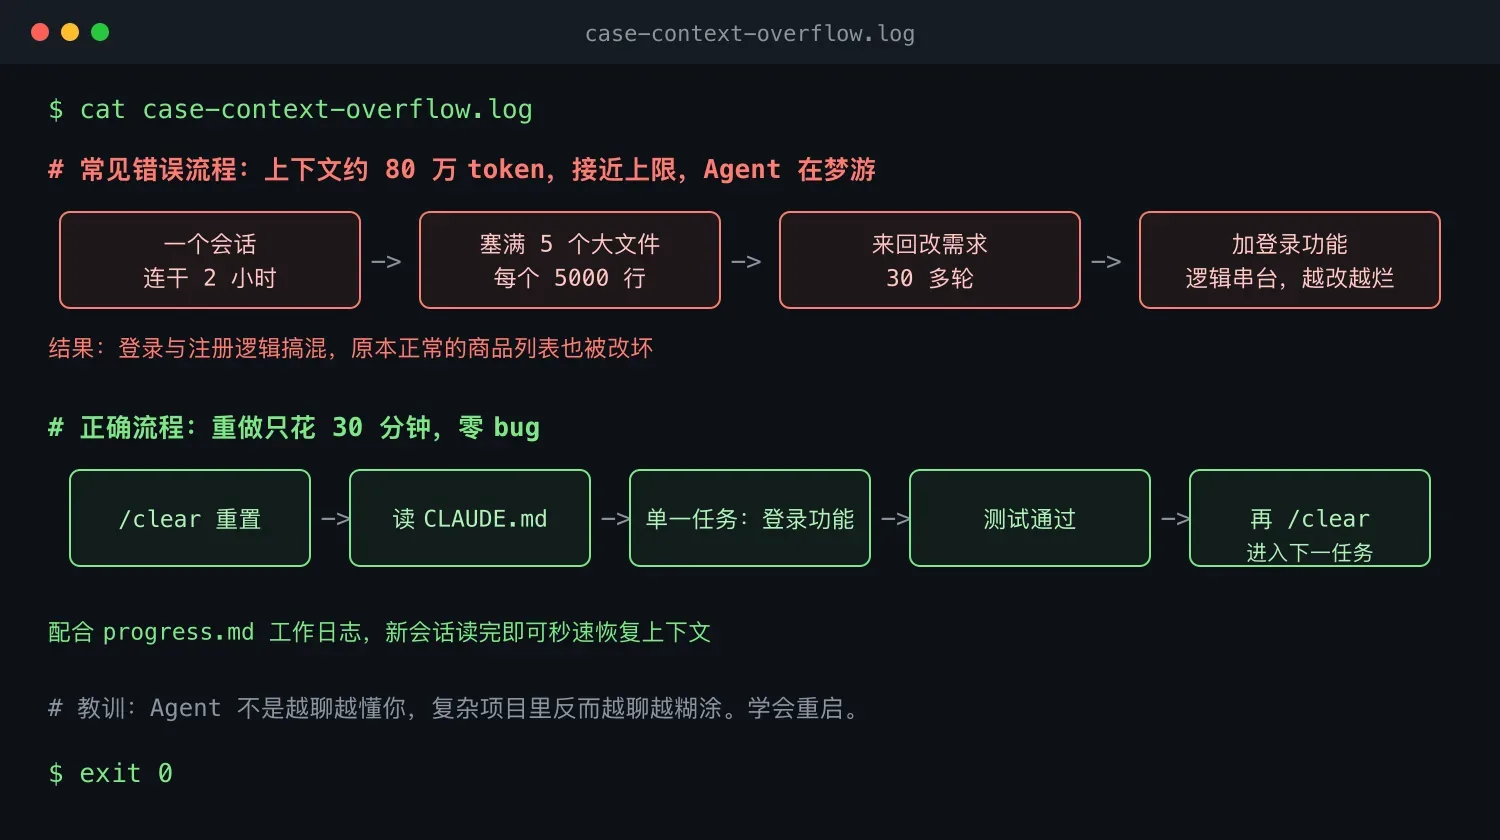
教训值得记住:Agent 不是“越聊越懂你”,复杂项目里反而是越聊越糊涂。要学会重启。
进阶概念:上下文窗口与 RAG
项目大到几百个文件、几十万行代码时,上下文窗口装不下怎么办?这就是进阶阶段会用到的 RAG(检索增强生成,Retrieval-Augmented Generation,概念源自 Lewis et al., 2020)。思路一句话:不要把整本书塞给 Agent,而是建一个“目录索引”,需要哪一章就调出来读。传统方式相当于把整个图书馆搬进房间再找书;RAG 是图书管理员记住每本书的摘要,你问“要讲 Python 的书”,它挑出 3 本最相关的,只把这 3 本递给 Agent。
在 Claude Code 里,这件事的入口是 @ 引用:不要说“看看整个项目”,而是写“看一下 @src/auth 相关的登录逻辑”。@ 会让 Agent 智能检索目录下的文件,只把相关的部分喂给上下文。
一个立刻能用的开场模板
从今天起,每次开新会话,按这个模板开始:
# 新会话开场模板(粘贴给 Agent)

我刚 /clear,请按以下流程开始:

1. 先读 CLAUDE.md(项目背景)
2. 读 progress.md(之前的进度,如果有)
3. 用一句话告诉我你的理解
4. 等我确认后再开始今天的任务

今天的目标:_______________________
约束:_______________________
把它存成快捷键或文本片段。这一个习惯能帮你省下约 30% 的 token,少踩约 50% 的坑。
动手练习与要点回顾
找任意一个练习项目目录,建一个 CLAUDE.md,写清项目说明、当前状态、技术栈和命名规范,然后 /clear 开新会话,观察 Agent 是否自动读了它;再给 Agent 一个复杂指令,要求它“开始前用 3 句话复述理解,并列 2 个确认问题”,看看它暴露了哪些偏差。最后想一个问题:哪种用法更省 token,一个会话从早干到晚,还是每完成一个任务 /clear 一次?答案是后者,前提是 /clear 后用 CLAUDE.md 恢复背景。
要点回顾:Agent 的记忆分两层,模型参数是长期记忆,上下文窗口是工作记忆,你能管的只有上下文;上下文塞满等于 Agent“梦游”,质量暴跌;五个技巧分别是单一任务、CLAUDE.md、复述确认、精准引用、工作日志;复杂项目用 @ 引用只喂相关文件;养成开场模板习惯,省 token 也少踩坑。
最后提醒一句:Agent 是能读你文件、能跑命令的“实习生”,用得再顺手,权限与安全意识也要尽早建立,先给它设好“能闯的祸”的边界,再放手让它干活。