字节笔记本
2026年10月6日 · 约 20 分钟读完
MCP 与工具生态:给 Agent 装上手和眼
本文是 Agentic 编程实战课系列的一章,主题是 MCP(Model Context Protocol,模型上下文协议),一套让 AI Agent 连接外部系统的标准协议。本系列此前的 Agent 已经能读写文件、拆解任务、自我校验,但活动范围始终局限在本机项目目录;这一章给它装上"手和眼",让它能读 Notion、查 Postgres、调 Stripe,真正连通外部世界。
一个让你瞬间懂的场景
假设你要做一个客户分析工具,需要三类数据:从 Notion 读客户档案,从 Stripe 拉消费记录,从 Google Calendar 看预约。
没有 MCP 的做法是手动导出三份 CSV,上传后再分析,数据到手就已经过期。有了 MCP,Agent 直接连这三个系统,实时拉取数据。
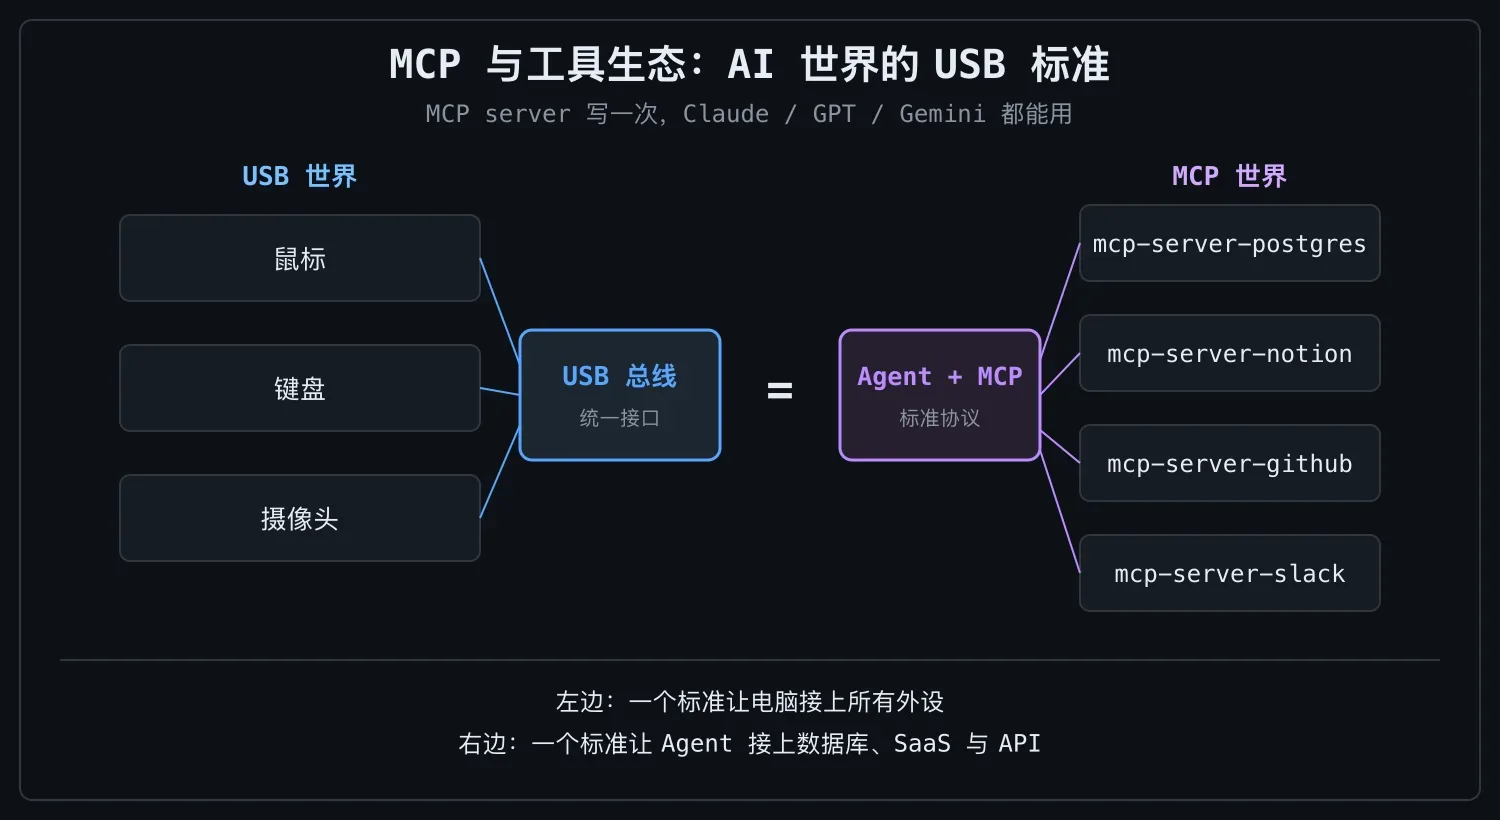
MCP 的定位可以用一个类比讲清:USB 标准让电脑能接各种外设,鼠标、键盘、摄像头;MCP 让 AI 能接各种工具,数据库、SaaS、API。
在 MCP 出现之前,各家 AI 平台各自定义工具接口,互不兼容:OpenAI 有 functions,Anthropic 有 tool_use,开发者要为每个平台单独写一遍。MCP 把这件事标准化:server 写一次,Claude、GPT、Gemini 都能用,生态共享,省时省力。
三个核心概念:Server、Tool、Resource
MCP 的概念体系用三个词就能讲完。
MCP Server(服务器):一个"工具包"程序,封装了某个外部系统的能力。例如 mcp-server-postgres 是 PostgreSQL 工具包,mcp-server-notion 是 Notion 工具包,mcp-server-filesystem 是文件系统工具包。
Tool(工具):一个 server 暴露的具体操作,类似"函数"。以 postgres server 为例,有 query(sql) 跑 SQL,list_tables() 列出所有表,describe_table(name) 查看表结构。
Resource(资源):一个 server 暴露的"可读数据",类似"文件"。例如 postgres://customers 指向客户表数据,notion://page/xxx 指向某个 Notion 页面。
一句话记住三者关系:Server 是工具包,Tool 是动词(能做什么),Resource 是名词(能读什么)。
配置你的第一个 MCP Server
用 Filesystem MCP 入门最简单。以 Claude Code 风格的配置为例,在项目根目录创建 .mcp.json:
{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-filesystem",
        "/Users/你/允许访问的目录"
      ]
    }
  }
}
注意安全:只允许访问特定目录,不要把整个家目录授权出去,这是最小权限原则的直接应用。
启动 Agent(运行 claude 命令),它会自动加载 .mcp.json 并连接 MCP server。在会话里输入"列出可用的 MCP tools",应该能看到 list_files、read_file、write_file、search_files 等工具。
再试一条真实指令:
> 用 filesystem 的 list_files 工具,列出允许目录下所有 .csv 文件
Agent 会调用 list_files 工具并返回结果。到这里,你已经让 Agent 用上第一个外部工具。
实战:连接 PostgreSQL
接下来做一个真正有用的场景:让 Agent 直接查数据库。
第一步,准备数据库。如果没有现成的 PostgreSQL,可以用 Supabase 的免费云端实例:注册 supabase.com,新建项目,建一张测试表:
create table customers (
  id serial primary key,
  name text,
  email text,
  signup_date date
);

insert into customers (name, email, signup_date) values
  ('张三', 'zhang@example.com', '2026-01-15'),
  ('李四', 'li@example.com', '2026-02-20');
第二步,在 .mcp.json 里加 postgres server:
{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-filesystem",
        "/Users/你/project"
      ]
    },
    "postgres": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-postgres",
        "postgresql://user:pass@xxx.supabase.co:5432/postgres"
      ]
    }
  }
}
特别注意:数据库连接串写在 .mcp.json 里,这个文件必须进 .gitignore,凭据入库是最常见的事故源。
第三步,让 Agent 干活:
> 用 postgres MCP:
1. list_tables 看看有哪些表
2. describe_table customers 看表结构
3. 查询:2 月份注册的客户有几个?
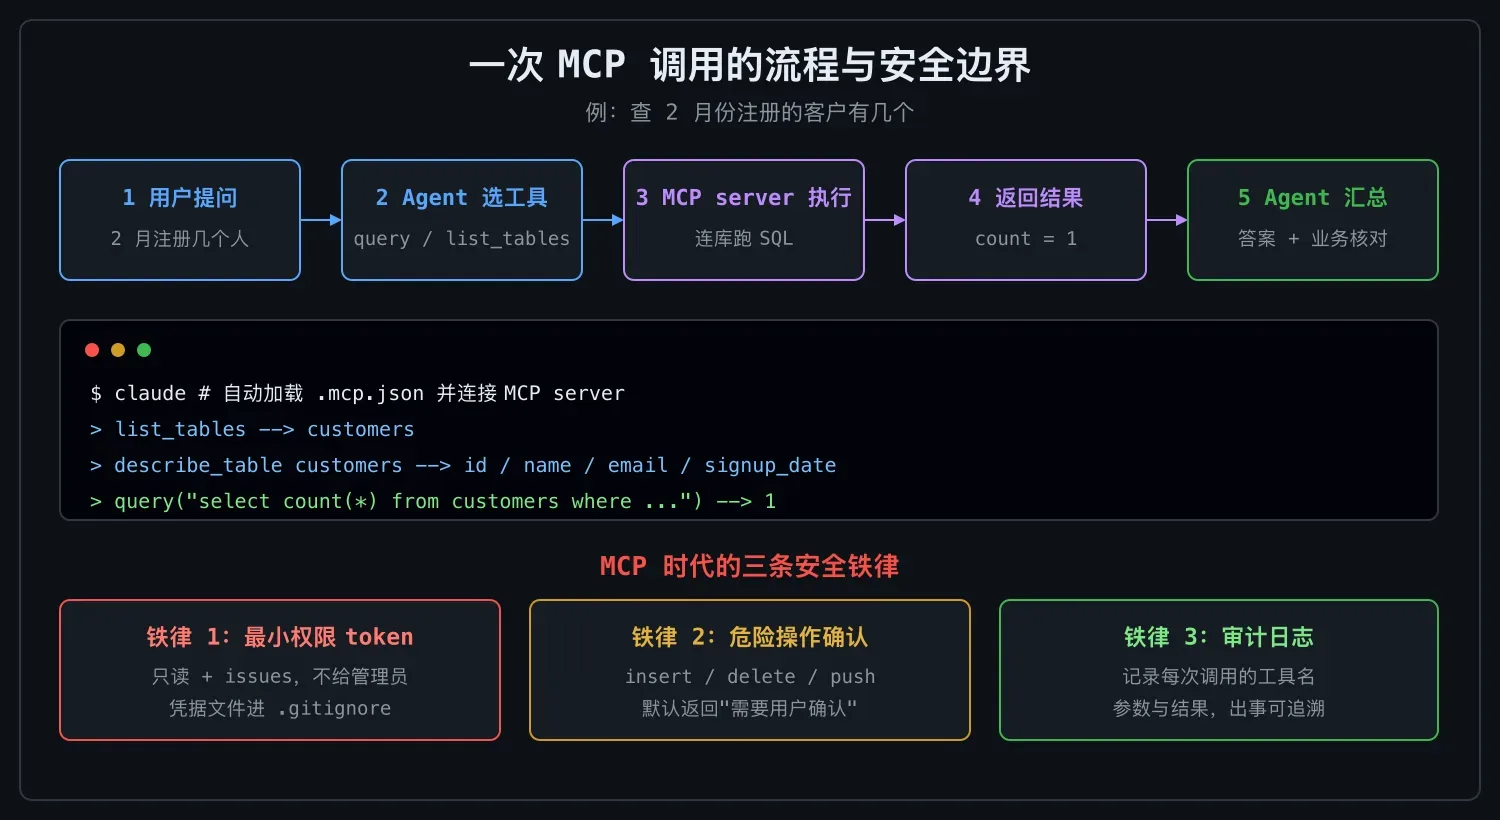
Agent 会依次调用 list_tables 看到 customers 表,调用 describe_table 确认字段,再构造 SQL 调用 query 得到答案。全程你不用写一行 SQL。
拿到答案后要做业务验证,这是人的价值所在:表里李四的注册日期是 2026-02-20,Agent 报"2 月注册 1 个"才对;如果它报 5 个,一定有 bug,可能是 SQL 的 where 条件写错了。
常用 MCP Server 一览
MCP 生态正在爆发,常用 server 可以分五类:
- 数据类:postgres、mysql、sqlite、supabase、mongodb、redis
- SaaS 类:notion、slack、github、gitlab、linear(项目管理)、airtable、google-drive、gmail、calendar
- 开发类:filesystem、shell(执行命令)、puppeteer、playwright(控制浏览器)、docker、sentry(错误监控)
- AI 类:openai(调 GPT)、hugging-face(模型库)、replicate(跑模型)
- 媒体类:brave-search(联网搜索)、fetch(抓网页)、screenshot
完整清单可以查官方 servers 仓库与社区维护的 awesome-mcp-servers 列表。
案例:让 Agent 自动维护 GitHub Issue
加入 GitHub MCP 后:
{
  "github": {
    "command": "npx",
    "args": ["-y", "@modelcontextprotocol/server-github"],
    "env": {
      "GITHUB_TOKEN": "ghp_xxx"
    }
  }
}
然后下指令:
> 看我仓库 owner/repo 的 open issues,
  找出超过 30 天没人回复的,
  自动评论一句"询问是否还需要"并加 stale 标签。
Agent 会自动执行:list_issues 拉取所有 open 状态的 issue,过滤出超过 30 天的,再对每个调用 create_comment 和 add_label。一个"社区维护"任务就此自动化。
进阶:自己写一个 MCP Server
当生态里没有你需要的工具时,可以自己写。Anthropic 在报告里也强调,"工具定制能力"是高产出者的标志之一。适合自写的场景有三类:内部系统没有现成 MCP;现有 MCP 不满足业务,需要加自定义校验;性能优化,合并多个调用。
下面是一个最简的 Python MCP server,封装一条业务规则(各城市销售税率):
# my_mcp_server.py
from mcp.server import Server
from mcp.types import Tool, TextContent
import mcp.server.stdio
import asyncio

server = Server("my-tools")

@server.list_tools()
async def list_tools():
    return [
        Tool(
            name="calc_sales_tax",
            description="计算销售税(业务规则:北京 6%,上海 6%,深圳 5%)",
            inputSchema={
                "type": "object",
                "properties": {
                    "amount": {"type": "number"},
                    "city": {"type": "string"}
                },
                "required": ["amount", "city"]
            }
        )
    ]

@server.call_tool()
async def call_tool(name, arguments):
    if name == "calc_sales_tax":
        amount = arguments["amount"]
        city = arguments["city"]

        # 业务规则!这是你的专业知识
        rates = {"beijing": 0.06, "shanghai": 0.06, "shenzhen": 0.05}
        rate = rates.get(city.lower(), 0.06)
        tax = amount * rate

        return [TextContent(
            type="text",
            text=f"{city} 销售 {amount} 元,税 {tax:.2f} 元(税率 {rate*100:.1f}%)"
        )]

async def main():
    async with mcp.server.stdio.stdio_server() as (read, write):
        await server.run(read, write, server.create_initialization_options())

if __name__ == "__main__":
    asyncio.run(main())
注册到项目:
{
  "mcpServers": {
    "my-tools": {
      "command": "python",
      "args": ["/path/to/my_mcp_server.py"]
    }
  }
}
使用:
> 用 my-tools 算一下:北京客户买 10000 元东西,销售税多少?
注意这个设计的精髓:税率表这类业务规则封装在 MCP server 里,这就是"专业知识代码化"。Agent 不需要记住税率,调用你的工具就行,规则更新也只改一处。
安全模型:三条铁律
MCP 让 Agent 能操作外部系统,安全级别必须相应提升。可以说,MCP 把"AI 安全"升级到了"系统安全"。
铁律一:最小权限的 token。 不要给 MCP server 管理员权限,只给必需权限。以 GitHub 为例,用 fine-grained token,在 Settings、Developer settings、Personal access tokens 里按需勾选,只读加 issues 权限就够,不要全仓库读写。
铁律二:危险操作要二次确认。 写入类操作(insert、delete、push)默认要求确认。可以在自己的 MCP server 里加一道闸:操作名命中 delete、drop、truncate 时返回"需要用户确认"的标记,而不是直接执行。
铁律三:审计日志。 让 MCP server 记录所有调用,用 logging.info 记下工具名、参数与结果。出事时能追溯,是事后止损的唯一线索。
想一想 token 泄露的后果就知道为什么:GitHub token 泄露,攻击者能删你所有仓库;Notion token 泄露,你所有笔记被读走;Postgres token 泄露,业务数据可能被清空。
完整案例:自动化客户支持
把前面的能力拼起来,可以搭一个客户支持自动化系统:Agent 同时连上六类系统,notion 管客户档案,slack 收客户消息,linear 管工单,postgres 存业务数据,gmail 发邮件,github 收 bug 反馈。
下指令时把流程写清楚,并要求先出计划:
> 自动化任务:
1. 从 Slack 拉最近 24h 的客户问题
2. 对每个问题:
   a. 在 Linear 创建工单
   b. 用 Notion 查这个客户档案,加上下文
   c. 用 Postgres 查这个客户的使用数据
   d. 如果是 bug,在 GitHub 创建 issue
   e. 如果是使用问题,在 Slack 自动回复解决方案
3. 汇总:今天处理了几个,分类如何

执行前给我看你的计划,确认后开始。
Agent 会规划出执行清单:先 list_messages 拉取 Slack 消息,然后对每条消息查 Notion 档案与 Postgres 使用数据,bug 类建 GitHub issue,使用问题自动回复 Slack,最后输出汇总报告,例如预计处理 15 个消息,耗时 5 分钟。你点头之后它才跑。
这就是 Agentic AI 的极致形态:你只描述目标,Agent 自主调用各种工具完成。
常见坑与排错
坑一:MCP server 启动失败。最常见原因是依赖没装或命令路径不对。诊断方法:手动跑一遍 server 命令看报错,例如 npx -y @modelcontextprotocol/server-filesystem /test。
坑二:token 权限不够。GitHub 与 Notion 的 fine-grained token 容易漏权限,去对应平台核对 token 的权限矩阵。
坑三:Agent 不调用工具。有时它会"假装"调用,实际自己编答案。解决方法是在 prompt 里明确要求:你必须使用 MCP tool 获取真实数据,不要凭空回答。
坑四:调用太频繁被限流。给工具调用加节流,例如每次调用间隔一秒。
坑五:成本爆炸。每次 MCP 调用的返回结果都会进入上下文消耗 token。解决办法是批量调用,避免一次只取一行。
生态资源
- MCP 官方规范:https://modelcontextprotocol.io
- 官方 servers:https://github.com/modelcontextprotocol/servers
- 社区 servers:https://github.com/punkpeye/awesome-mcp-servers
- Smithery(MCP 包管理器):https://smithery.ai
2026 年的趋势是 MCP 生态持续爆发,几乎所有主流 SaaS 都在出官方 server。学会 MCP,等于拿到 AI 时代的"系统集成"通行证。
要点回顾
- MCP 是 AI 世界的 USB 标准,让 Agent 连接外部系统。
- 三个核心概念:Server(工具包)、Tool(动词,能做什么)、Resource(名词,能读什么)。
- 配置 .mcp.json 即可启用,凭据文件务必进 .gitignore。
- 常用 server:postgres、notion、github、slack、filesystem。
- 可以自己写 MCP server,把业务规则代码化。
- 安全级别更高:最小权限 token、危险操作确认、审计日志,缺一不可。
- MCP 让自主 Agent 成为可能:你描述目标,Agent 自主调用工具。
当项目规模继续变大,每次开新会话都要重新解释项目背景,那时可以把团队约定写进一份项目记忆文件(如 CLAUDE.md),一次写好、长期复用,这是下一个值得单独展开的话题。
参考与延伸:
- MCP 官方规范:https://modelcontextprotocol.io
- 服务器配置语法以 Claude Code 为例,其他 MCP 客户端类似