字节笔记本
2026年10月6日 · 约 48 分钟读完
AI 工作流专栏 09:LLM API 接入与统一适配层
本文是《从零成为 AI 工作流工程师》系列第 9 篇,主题是把大模型正式接进你自己的系统。Prompt 写得再好也只是"台词",你还得先把模型这个"演员"请上台。本文把 OpenAI、Claude、阿里通义、DeepSeek 四家主流大模型的 API 全部接通一遍,更关键的是带你设计一个统一模型适配层:一套代码,改一行配置就能切换模型。这是招聘 JD 里明确要求的能力("熟悉多家大模型 API、能做模型切换与降级"),也是生产级 AI 系统的标配架构。
本篇你将学到:
- 四家主流模型 API 的注册、Key 获取、价格档位与国内访问注意事项
- OpenAI SDK 的标准调用方式与核心参数(model / messages / temperature / max_tokens / top_p)
- messages 三种 role(system / user / assistant)的作用
- Claude API 的差异(system 是顶层参数)与通义、DeepSeek 兼容 OpenAI 协议的关键洞察
- 设计统一模型适配层:LLMClient 抽象加四个实现,业务代码只调 client.chat()
- 多模型对比与选型决策表
- 用 tenacity 做指数退避重试,处理 429 限流与超时
- API Key 安全管理(.env 加 python-dotenv)与成本核算
一、先把四把"钥匙"领到手:API Key 获取
在写代码之前,你得先有四把"钥匙":各家模型的 API Key。这一步看着简单,但国内开发者在这里卡半天的不在少数。逐家说明。
1.1 OpenAI(GPT 系列)
生活类比:OpenAI 就像 iPhone:产品最成熟,但有点"高冷",国内直连不通。
- 注册入口:https://platform.openai.com
- Key 获取:登录后进入 Dashboard → API Keys → Create new secret key。Key 只在创建时显示一次,务必立刻复制保存。
- 国内访问注意:OpenAI 不对中国大陆开放注册(需海外手机号加信用卡),且 API 域名
api.openai.com在国内无法直连。两种解法:- 走代理或中转网关:很多团队用自建的海外代理节点,或第三方中转服务(把请求转发到 OpenAI,只需改
base_url)。 - 用 Azure OpenAI:微软提供的 OpenAI 服务,企业可正经签合同、走合规通道,国内可用,但需要企业资质。
- 走代理或中转网关:很多团队用自建的海外代理节点,或第三方中转服务(把请求转发到 OpenAI,只需改
- 价格档位(2026 参考):
gpt-4o输入 $2.5/M tokens、输出 $10/M;推理模型o3更贵。轻量任务可用gpt-4o-mini(约便宜 30 倍)。
1.2 Anthropic Claude
生活类比:Claude 像"文科加编程的双料学霸",长文和代码特别强,但脾气(协议)和 OpenAI 不太一样。
- 注册入口:https://console.anthropic.com
- Key 获取:Console → API Keys → Create Key。
- 国内访问注意:Anthropic 同样不直接对中国大陆开放,需要海外手机号验证,国内访问通常也走代理。好消息是阿里云、AWS Bedrock 都提供了 Claude 的合规托管,国内企业可以通过百炼、Bedrock 正经调用,走的是国内或合规通道。
- 价格档位:
claude-sonnet-4输入 $3/M、输出 $15/M;旗舰claude-opus-4更贵。长文本、代码任务性价比高。
1.3 阿里通义千问(Qwen)
生活类比:通义是"家门口的便利店":中文好、合规顺、人民币结算,国内项目首选之一。
- 注册入口:阿里云百炼平台 https://bailian.console.aliyun.com
- Key 获取:登录后进模型广场 / API-KEY 管理创建。国内手机号、实名认证即可,无门槛。
- 国内访问注意:完全无障碍,国内直连,毫秒级延迟。新用户通常送免费额度。
- 价格档位:
qwen-plus输入 ¥0.8/M、输出 ¥2/M;旗舰qwen-max略贵,还有开源版qwen-turbo极便宜。关键:通义兼容 OpenAI 协议,代码几乎不用改。
1.4 DeepSeek
生活类比:DeepSeek 是"国产性价比之王":能力接近 GPT-4o,价格只有它的 1/20。
- 注册入口:https://platform.deepseek.com
- Key 获取:登录后进 API Keys 创建。国内手机号注册即可。
- 国内访问注意:国内直连,速度快。模型开源(V3、R1 权重公开),你也可以本地部署。
- 价格档位:
deepseek-chat(V3)输入 ¥1/M、输出 ¥2/M;deepseek-reasoner(R1 推理模型)略贵但仍是白菜价。完全兼容 OpenAI 协议。
1.5 一个表格速记
| 厂商 | 国内直连 | 注册门槛 | 协议 | 适合场景 |
|---|---|---|---|---|
| OpenAI | 需代理 | 海外卡、手机号 | OpenAI(原生) | 海外项目、质量优先 |
| Claude | 需代理 | 海外卡、手机号 | 独立协议 | 长文、代码、写作 |
| 通义 Qwen | 可直连 | 国内实名 | 兼容 OpenAI | 国内企业、中文场景 |
| DeepSeek | 可直连 | 国内手机号 | 兼容 OpenAI | 国内项目、性价比 |
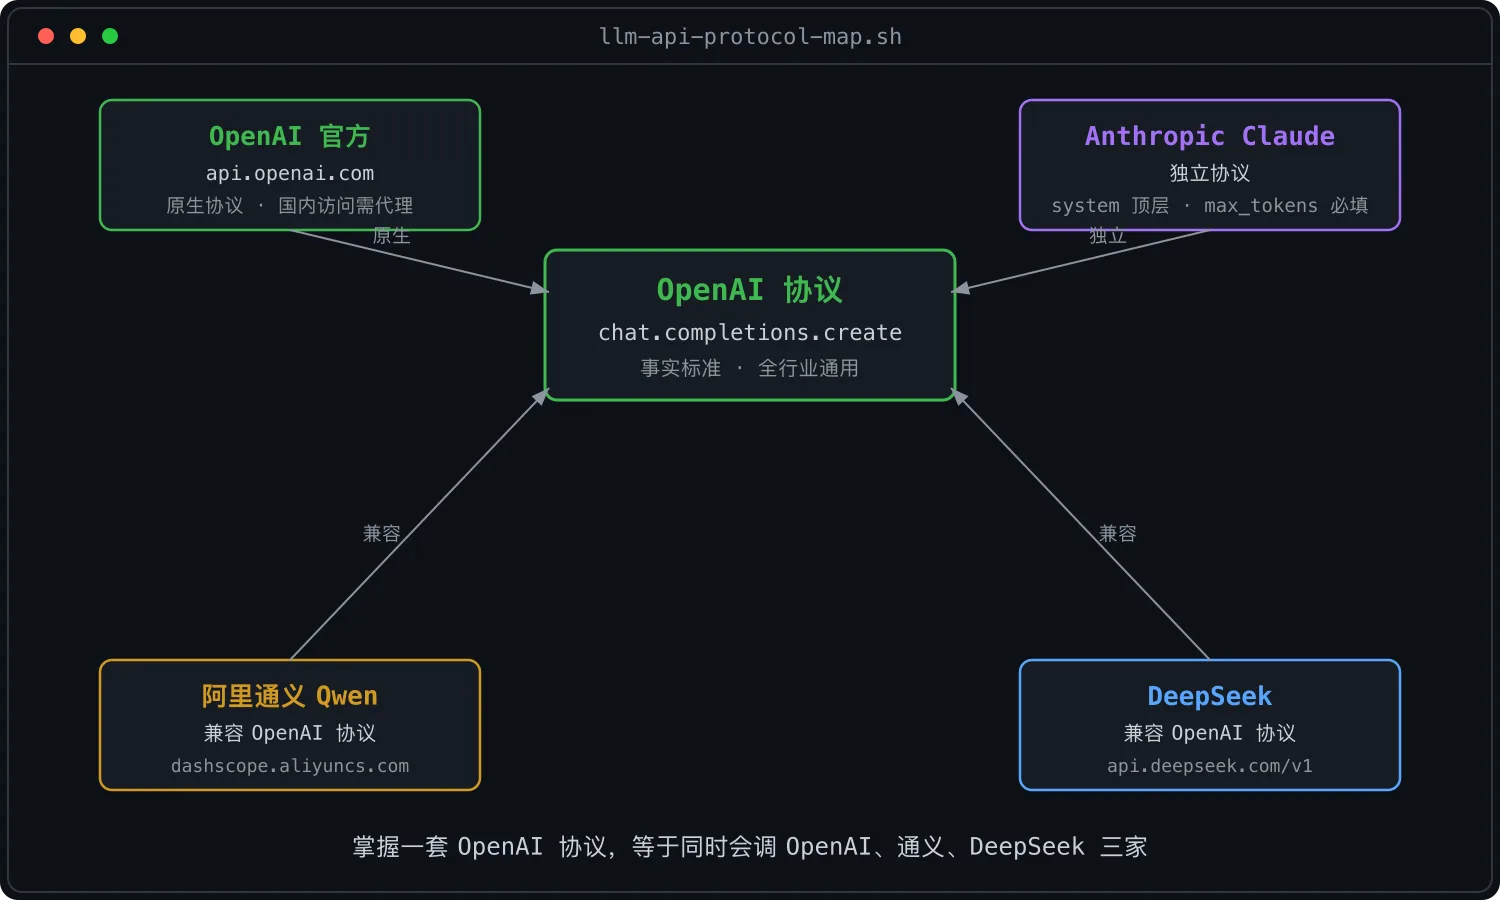
关键洞察:四家里三家(OpenAI、通义、DeepSeek)用同一套协议,只有 Claude 是"另类"。所以先学 OpenAI 协议,性价比最高,这也是本文后面默认用 OpenAI SDK 风格的原因。
二、OpenAI SDK 调用:行业"普通话"
先装 SDK:
pip install openai python-dotenv2.1 生活类比:打电话
调用大模型 API,就像给一个聪明但没记忆的接线员打电话:
- 你要先告诉它"你是谁、扮演什么角色"(system)
- 再问它问题(user)
- 它回答你(assistant)
- 如果是多轮对话,把"你问、它答、你再问"的完整历史都重新念给它听(因为它每次都"失忆",靠 messages 列表重建记忆)
2.2 messages 三种 role
| role | 谁在说话 | 作用 |
|---|---|---|
system | 系统设定 | 给模型"定调子":身份、风格、规则。一般放第一条 |
user | 用户 | 提问、下指令 |
assistant | 模型 | 模型之前的回答。多轮对话时必须带上,模型才记得"刚才说了什么" |
为什么 system 单独拎出来? 因为它对模型的影响是全局的:优先级高于 user 消息,能稳定地约束模型行为(比如"只回答医疗问题、闲聊就拒绝")。
2.3 标准调用代码(可跑)
# llm_basic.py
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()  # 从 .env 读取环境变量

client = OpenAI(
    api_key=os.getenv("OPENAI_API_KEY"),
    # 如用中转服务,取消下一行注释并填中转地址
    # base_url="https://your-proxy.com/v1",
)

response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": "你是一位资深 Python 程序员,回答简洁、带代码示例。"},
        {"role": "user", "content": "用一句话解释什么是装饰器。"},
    ],
    temperature=0.7,
    max_tokens=500,
    top_p=1.0,
)

print(response.choices[0].message.content)
2.4 参数详解
| 参数 | 作用 | 推荐值 |
|---|---|---|
model | 用哪个模型,如 gpt-4o、gpt-4o-mini | 按任务选 |
messages | 对话历史,role 加 content 组成的列表 | 必填 |
temperature | 创造力,0 最稳定,1 以上更发散 | 生产用 0 到 0.3 |
max_tokens | 输出最多生成多少 token(防超长) | 按需,默认够用 |
top_p | 核采样,和 temperature 二选一调节随机性 | 默认 1.0,一般不动 |
stream | 是否流式输出 | 先按 False 处理,流式属于进阶玩法 |
小白常踩的坑:
temperature和top_p一般只调一个,两个都动容易乱。生产环境锁temperature=0,保证可复现。
2.5 多轮对话:记得带上历史
# 模拟多轮对话
history = [
    {"role": "system", "content": "你是友好助手。"},
    {"role": "user", "content": "我叫小明。"},
    {"role": "assistant", "content": "你好小明!很高兴认识你。"},
    {"role": "user", "content": "我刚才说我叫什么?"},  # 测试它"记不记得"
]

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=history,
    temperature=0,
)
print(resp.choices[0].message.content)
# 输出:你刚才说你叫小明。模型本身是无记忆的,它能"记得",是因为你每次都把之前的对话原样塞进 messages。所以做聊天机器人时,你要自己维护这份 history(存数据库或 Redis)。
三、Claude API:那个"另类"
Claude 用自己的 SDK,而且有个最容易踩的坑:它的 system 不是 messages 里的第一条,而是和 messages 平级的顶层参数。
pip install anthropic# claude_basic.py
import os
from anthropic import Anthropic
from dotenv import load_dotenv
load_dotenv()
client = Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))
response = client.messages.create(
model="claude-sonnet-4-20250514",
max_tokens=500,
system="你是一位资深 Python 程序员,回答简洁、带代码示例。", # 注意:放在顶层
messages=[
{"role": "user", "content": "用一句话解释什么是装饰器。"},
],
)
print(response.content[0].text)两个关键差异:
system是顶层参数,不放进 messages。如果你照搬 OpenAI 的写法把 system 塞进 messages[0],Claude 会忽略它(或表现奇怪)。- 必须指定
max_tokens,否则报错。OpenAI 是可选的,Claude 是必填的。
其余几乎一样:messages 列表、多轮对话、temperature 都类似。所以适配层主要处理这两个差异点。
四、通义、DeepSeek:兼容 OpenAI 协议的"惊喜"
这是本篇最实用的一个洞察:通义和 DeepSeek 都能直接用 OpenAI SDK 调用,只需改 base_url 和 api_key。
# qwen_via_openai_sdk.py,通义千问
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),                  # 通义的 Key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 通义的兼容端点
)

resp = client.chat.completions.create(
    model="qwen-plus",
    messages=[{"role": "user", "content": "你好,介绍一下自己。"}],
)
print(resp.choices[0].message.content)# deepseek_via_openai_sdk.py,DeepSeek
import os
from openai import OpenAI
from dotenv import load_dotenv
load_dotenv()
client = OpenAI(
api_key=os.getenv("DEEPSEEK_API_KEY"),
base_url="https://api.deepseek.com/v1", # DeepSeek 的兼容端点
)
resp = client.chat.completions.create(
model="deepseek-chat",
messages=[{"role": "user", "content": "你好,介绍一下自己。"}],
)
print(resp.choices[0].message.content)看出来了吗?这两段代码和第二节 OpenAI 的代码几乎一模一样,只差 base_url、api_key、model 三个值。这就是"兼容 OpenAI 协议"的威力:你掌握了一套调用方式,就掌握了 3 家模型。
行业现状:因为 OpenAI 协议成了事实标准,几乎所有国产模型(智谱 GLM、月之暗面 Kimi、百川、零一万物)都提供了 OpenAI 兼容端点。学会 OpenAI SDK,国产模型你都能调。
五、核心:设计统一模型适配层
现在到了本篇精华。前面四家 API 各有差异(Claude 的 system 在顶层、必填 max_tokens;OpenAI、通义、DeepSeek 协议一致),如果业务代码里到处写 if model == "openai": ...,会乱成一锅粥。
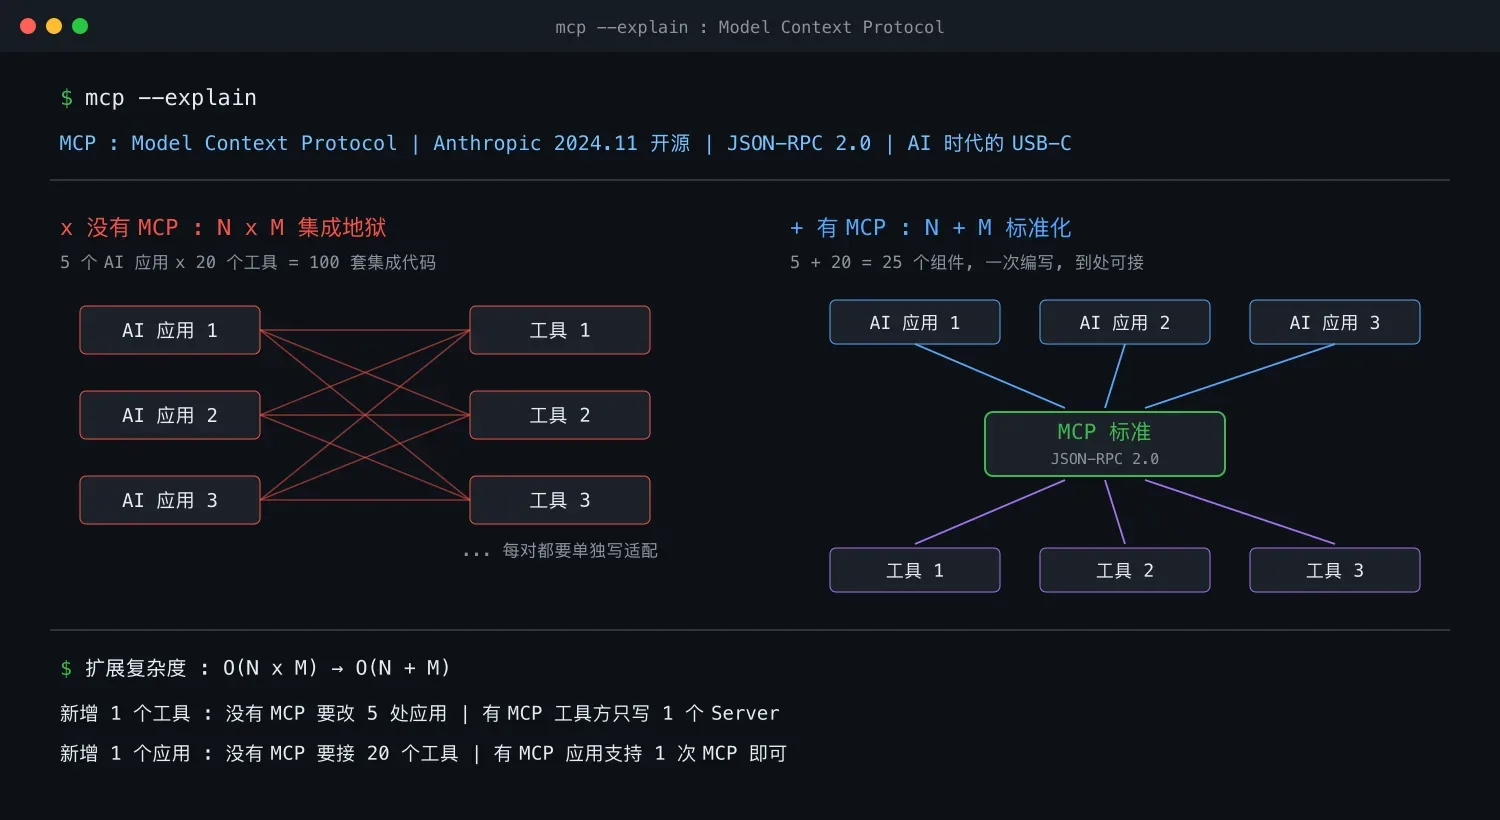
工程上的标准解法是适配器模式(Adapter Pattern):定义一个抽象类 LLMClient,规定"所有模型都必须实现 chat() 方法",然后给每家模型写一个子类实现。上层业务只面向抽象,不关心底层是哪家模型。
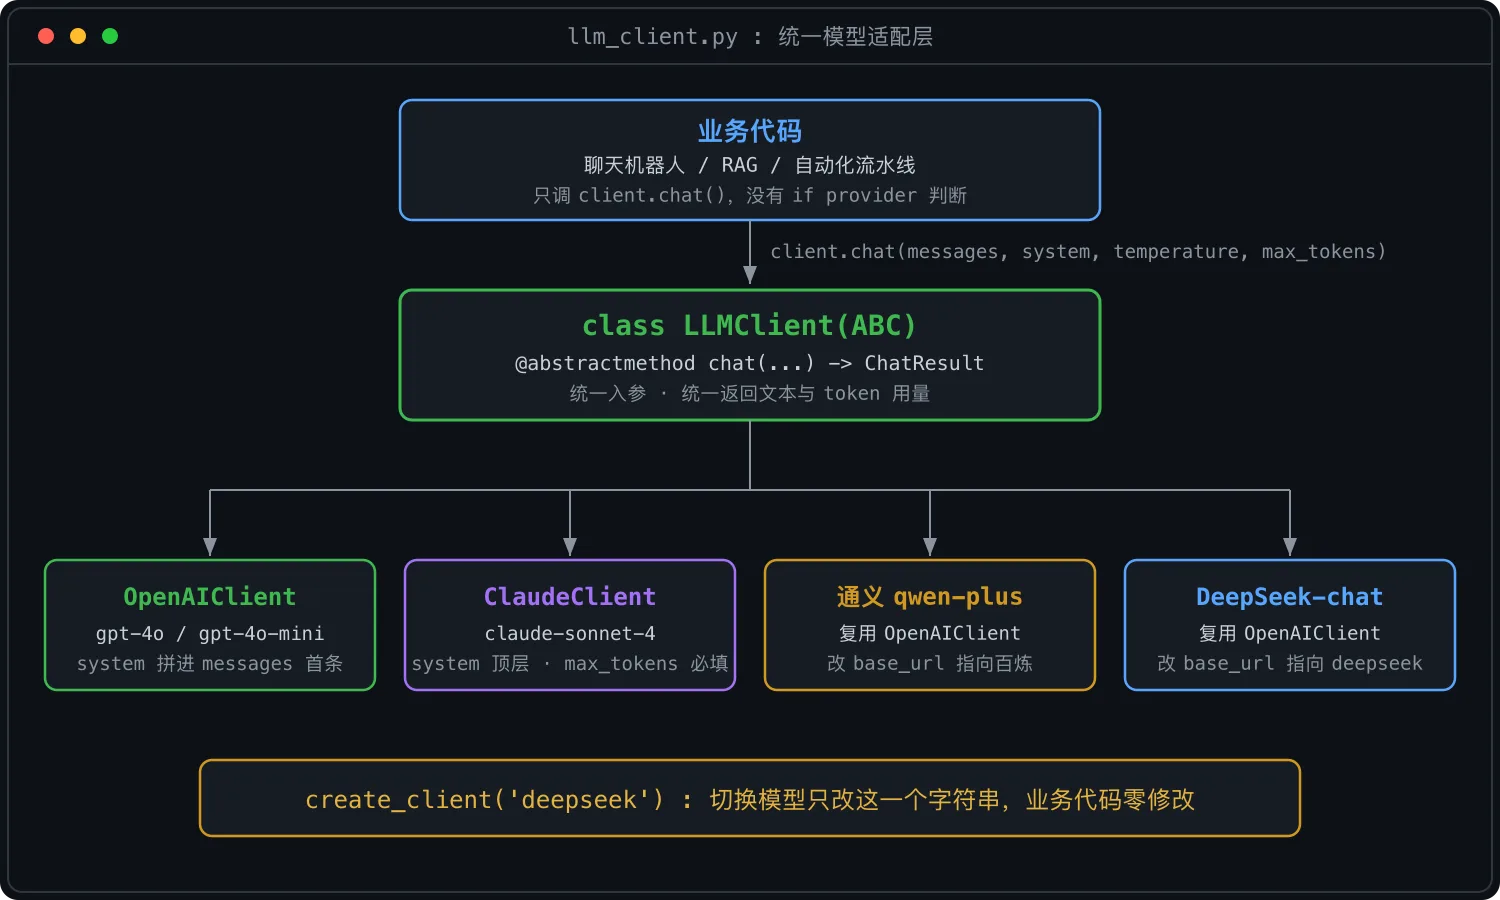
5.1 生活类比:万能遥控器
想象你家有 4 台不同品牌的电视(索尼、三星、LG、小米),每台遥控器按键布局都不一样。你买了一个万能遥控器,只定义了"开机、换台、调音量"三个通用按键,里面再适配每台电视的具体红外码。
LLMClient= 万能遥控器(定义通用接口)- 4 个子类 = 4 个适配器(把通用按键翻译成各品牌的具体信号)
- 你的手 = 业务代码(只按通用按键,不管底下是哪台电视)
5.2 完整实现(可跑、有注释)
# llm_client.py,统一模型适配层
import os
from abc import ABC, abstractmethod
from dataclasses import dataclass
from typing import Optional
from dotenv import load_dotenv

load_dotenv()


@dataclass
class ChatResult:
    """统一的返回结构,屏蔽各家的差异"""
    content: str               # 模型输出的文本
    model: str                 # 实际用的模型名
    prompt_tokens: int = 0     # 输入 token 数(用于算钱)
    completion_tokens: int = 0 # 输出 token 数
    total_tokens: int = 0


class LLMClient(ABC):
    """抽象基类:所有模型适配器都要实现 chat()"""

    @abstractmethod
    def chat(
        self,
        messages: list[dict],
        system: Optional[str] = None,
        temperature: float = 0.7,
        max_tokens: int = 1024,
    ) -> ChatResult:
        """
        统一的对话接口。
        :param messages: [{"role": "user"/"assistant", "content": "..."}]
        :param system: 系统提示词(单独抽出,方便适配 Claude 的顶层参数)
        """
        ...


class OpenAIClient(LLMClient):
    """OpenAI 官方 + 所有兼容 OpenAI 协议的模型(通义、DeepSeek)"""

    def __init__(self, model: str, api_key: str, base_url: Optional[str] = None):
        from openai import OpenAI
        kwargs = {"api_key": api_key}
        if base_url:
            kwargs["base_url"] = base_url
        self.client = OpenAI(**kwargs)
        self.model = model

    def chat(self, messages, system=None, temperature=0.7, max_tokens=1024):
        # OpenAI 协议:system 放进 messages 第一条
        full_messages = []
        if system:
            full_messages.append({"role": "system", "content": system})
        full_messages.extend(messages)

        resp = self.client.chat.completions.create(
            model=self.model,
            messages=full_messages,
            temperature=temperature,
            max_tokens=max_tokens,
        )
        usage = resp.usage
        return ChatResult(
            content=resp.choices[0].message.content,
            model=self.model,
            prompt_tokens=usage.prompt_tokens if usage else 0,
            completion_tokens=usage.completion_tokens if usage else 0,
            total_tokens=usage.total_tokens if usage else 0,
        )


class ClaudeClient(LLMClient):
    """Claude:system 是顶层参数,max_tokens 必填"""

    def __init__(self, model: str, api_key: str):
        from anthropic import Anthropic
        self.client = Anthropic(api_key=api_key)
        self.model = model

    def chat(self, messages, system=None, temperature=0.7, max_tokens=1024):
        kwargs = {
            "model": self.model,
            "max_tokens": max_tokens,   # Claude 必填
            "messages": messages,       # system 不在这里
            "temperature": temperature,
        }
        if system:
            kwargs["system"] = system   # system 作为顶层参数

        resp = self.client.messages.create(**kwargs)
        usage = resp.usage
        return ChatResult(
            content=resp.content[0].text,
            model=self.model,
            prompt_tokens=usage.input_tokens,
            completion_tokens=usage.output_tokens,
            total_tokens=usage.input_tokens + usage.output_tokens,
        )


def create_client(provider: str = "openai") -> LLMClient:
    """工厂函数:根据 provider 名字创建对应适配器。
    切换模型 = 改这一个字符串。"""
    if provider == "openai":
        return OpenAIClient(
            model="gpt-4o-mini",
            api_key=os.getenv("OPENAI_API_KEY"),
        )
    elif provider == "qwen":
        return OpenAIClient(                          # 通义复用 OpenAIClient
            model="qwen-plus",
            api_key=os.getenv("DASHSCOPE_API_KEY"),
            base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
        )
    elif provider == "deepseek":
        return OpenAIClient(                          # DeepSeek 也复用
            model="deepseek-chat",
            api_key=os.getenv("DEEPSEEK_API_KEY"),
            base_url="https://api.deepseek.com/v1",
        )
    elif provider == "claude":
        return ClaudeClient(
            model="claude-sonnet-4-20250514",
            api_key=os.getenv("ANTHROPIC_API_KEY"),
        )
    else:
        raise ValueError(f"未知的 provider: {provider}")
5.3 业务代码:怎么用
# app.py,上层业务,完全不知道底层是哪家模型
from llm_client import create_client

# 切换模型只改这一行!openai / claude / qwen / deepseek
client = create_client("deepseek")

result = client.chat(
    messages=[{"role": "user", "content": "用一句话解释什么是闭包。"}],
    system="你是一位资深程序员,回答简洁。",
    temperature=0,
)

print(f"[{result.model}] {result.content}")
print(f"token 用量:输入 {result.prompt_tokens} + 输出 {result.completion_tokens} = {result.total_tokens}")
看出威力了吗? 业务代码里没有任何 if provider == ...,切换模型只需把 "deepseek" 改成 "qwen"。这就是适配器模式的价值:解耦。
5.4 小结:为什么这么设计
| 设计决策 | 理由 |
|---|---|
system 单独作为参数 | 兼容 Claude 的顶层 system,又能在 OpenAI 协议里自动拼进 messages |
统一返回 ChatResult | 业务代码不关心 Claude 是 resp.content[0].text 还是 OpenAI 是 resp.choices[0].message.content |
通义、DeepSeek 复用 OpenAIClient | 它们协议一致,只需传 base_url,避免重复代码 |
工厂函数 create_client | 集中管理创建逻辑,切换、新增模型只改一处 |
抽象基类 LLMClient | 强制所有实现遵循同一接口,未来加新模型(如 Gemini)只需写一个子类 |
进阶提示:生产环境还可以在适配层加入重试、限流、降级、缓存、日志、计费埋点。本文先讲重试,其余能力思路相同,都可以在这层逐步加上。
六、多模型对比与选型策略
有了适配层,你可以用同一个问题跑 4 家模型,横向对比:
# compare.py,同一问题问 4 家
import time
from llm_client import create_client

question = [{"role": "user", "content": "用 100 字解释什么是 RAG。"}]

for provider in ["openai", "claude", "qwen", "deepseek"]:
    try:
        client = create_client(provider)
        t0 = time.time()
        result = client.chat(question, system="你是 AI 技术专家。", temperature=0)
        elapsed = time.time() - t0
        print(f"\n=== {provider}({elapsed:.1f}s,{result.total_tokens} tokens)===")
        print(result.content[:120], "...")
    except Exception as e:
print(f"\n=== {provider} 调用失败:{e} ===")跑完你会得到一张"质量、速度、成本"三维对比表。基于经验,给你一份选型决策表:
| 任务类型 | 国内推荐 | 海外推荐 | 理由 |
|---|---|---|---|
| 日常对话 / 客服 | Qwen-Plus / DeepSeek-Chat | GPT-4o-mini | 便宜、够用、快 |
| 复杂推理 / 数学 | DeepSeek-R1 | o3 / Claude | 推理模型强 |
| 长文分析 / 合同 | Qwen-Max(长上下文) | Claude(200K 窗口) | 上下文长、准确 |
| 代码生成 / Review | DeepSeek-V3 / Qwen-Coder | Claude Sonnet | 代码能力强 |
| 中文写作 / 营销 | Qwen / DeepSeek | 不作重点 | 中文母语级 |
| 多模态(看图) | Qwen-VL | GPT-4o / Gemini | 视觉理解 |
选型三原则:
- 先按"国内、海外"筛(合规第一)
- 再按预算定档位(能用 mini 就别用 max)
- 最后按任务类型微调(推理任务才上推理模型)
别迷信"旗舰就是最好"。日常任务用
gpt-4o-mini、deepseek-chat,又快又便宜,效果未必差。
七、错误处理与重试:让调用"皮实"
线上调 API,一定会遇到这些错:
| 错误 | 原因 | 处理 |
|---|---|---|
429 Too Many Requests | 限流(QPS、配额超了) | 指数退避重试 |
500 / 503 | 服务端临时故障 | 重试 |
| 超时 | 网络抖动、模型慢 | 重试 + 缩短 max_tokens |
401 Unauthorized | Key 失效、写错 | 不重试,直接报警 |
7.1 用 tenacity 做指数退避
pip install tenacity# llm_retry.py,给适配层加重试
from tenacity import (
retry,
stop_after_attempt,
wait_exponential,
retry_if_exception_type,
)
from openai import RateLimitError, APIConnectionError, APITimeoutError
from llm_client import create_client
class RobustClient:
"""包装一层,自动对可恢复错误做指数退避重试"""
def __init__(self, provider: str, max_attempts: int = 5):
self.inner = create_client(provider)
self.max_attempts = max_attempts
# 用 tenacity 装饰:遇到这三类错误才重试
self._chat = retry(
stop=stop_after_attempt(max_attempts), # 最多重试 5 次
wait=wait_exponential(multiplier=1, min=1, max=16), # 1,2,4,8,16 秒
retry=retry_if_exception_type(
(RateLimitError, APIConnectionError, APITimeoutError)
),
reraise=True, # 重试用尽后抛原异常
)(self.inner.chat)
def chat(self, *args, **kwargs):
return self._chat(*args, **kwargs)
# 使用
client = RobustClient("deepseek")
result = client.chat([{"role": "user", "content": "你好"}])指数退避的意思:第一次失败等 1 秒重试,再失败等 2 秒,再 4 秒、8 秒,越等越久,给服务端喘息时间,避免一堆请求同时重试把服务打挂。
7.2 降级策略
重试 5 次还失败怎么办?降级到备用模型,而不是直接让用户看到报错:
def chat_with_fallback(question: str, primary="deepseek", fallback="qwen") -> str:
    """主模型挂了,自动切备用模型"""
    providers = [primary, fallback]
    for p in providers:
        try:
            client = RobustClient(p)
            return client.chat([{"role": "user", "content": question}]).content
        except Exception as e:
            print(f"[降级] {p} 失败:{e},尝试下一个...")
    raise RuntimeError("所有模型都不可用")
生产 AI 系统标配:主用 → 重试 → 降级 → 兜底(规则、缓存)。这样即使一家模型全线故障,你的产品也不至于瘫掉。
八、API Key 安全管理
这是新手最容易犯的致命错误:把 API Key 写死在代码里,然后 push 到 GitHub。结果 Key 一夜被盗刷几千美金(真事,每周都在发生)。
8.1 正确做法:.env 加 python-dotenv
在项目根目录建一个 .env 文件:
# .env,这个文件绝不能提交到 Git!
OPENAI_API_KEY=sk-xxxxxxxxxxxx
ANTHROPIC_API_KEY=sk-ant-xxxxxxxxxx
DASHSCOPE_API_KEY=sk-xxxxxxxxxxxx
DEEPSEEK_API_KEY=sk-xxxxxxxxxxxx
然后在 .gitignore 里加上:
.env
代码里用 python-dotenv 加载:
from dotenv import load_dotenv
load_dotenv()  # 把 .env 的内容读进环境变量

import os
key = os.getenv("DEEPSEEK_API_KEY")  # 永远从环境变量取
8.2 生产环境:用密钥管理服务
.env 适合本地开发。生产环境别用 .env,改用专业的密钥管理服务:
- 阿里云 KMS、AWS Secrets Manager、HashiCorp Vault:集中存密钥,按权限下发,自动轮转。
- 应用启动时从 KMS 拉取 Key,内存里用,绝不落盘。
核心原则:Key 永远不出现在代码仓库里。任何能 git log 的人都不应该看到 Key。
九、成本意识:每次调用都要算账
调 API 不是免费的,合格的 AI 工程师对每一分钱心里有数。
9.1 从响应里读 usage
每家 API 的响应都带 token 用量(第五节 ChatResult 已经封装好了):
result = client.chat([{"role": "user", "content": "解释量子力学"}])
print(f"输入 {result.prompt_tokens} tokens,输出 {result.completion_tokens} tokens")
9.2 算钱
# cost.py,按各家价格算单次费用
# 单价:每百万 token 多少美元(输入 / 输出)
PRICING = {
    "gpt-4o-mini": (0.15, 0.60),
    "gpt-4o":      (2.5, 10.0),
    "deepseek-chat": (0.14, 0.28),    # 折算成美元,1 元约 0.14 美元
    "qwen-plus":     (0.11, 0.28),
    "claude-sonnet-4-20250514": (3.0, 15.0),
}

def calc_cost(model, prompt_tokens, completion_tokens):
    in_price, out_price = PRICING.get(model, (0, 0))
    cost = (prompt_tokens / 1_000_000) * in_price + (completion_tokens / 1_000_000) * out_price
    return cost

# 示例:一次调用
cost = calc_cost("deepseek-chat", prompt_tokens=500, completion_tokens=200)
print(f"本次调用花费:${cost:.5f}")  # 约 $0.00013,几乎免费
把 cost 记进日志(每次调用都记),月底你就能画出"每个功能、每个用户花了多少钱"。这是成本治理的核心:不可观测的成本就是失控的成本。
9.3 省钱的三个习惯
- 能用小模型别用大模型:分类、提取、简单问答用 mini、turbo 版。
- 控制
max_tokens:别让模型"喋喋不休",按需截断。 - 缓存重复请求:同一问题直接返回缓存结果(适合 FAQ 场景)。
十、本章小结
- 四家模型 API:OpenAI、Claude 是海外加代理,通义、DeepSeek 国内直连。通义和 DeepSeek 兼容 OpenAI 协议,这是最重要的洞察。
- OpenAI SDK 是行业普通话:掌握它,3 家国产模型都能调。核心是
client.chat.completions.create加 messages 三种 role(system 定调、user 提问、assistant 历史)。 - Claude 是"另类":
system是顶层参数、max_tokens必填,适配时要注意。 - 统一模型适配层:抽象基类
LLMClient加工厂函数create_client,业务代码只调client.chat(),切换模型只改一个字符串。这是生产 AI 系统的标配。 - 选型三步:地区、预算、任务类型。日常别迷信旗舰,mini、chat 版够用。
- 错误处理:用 tenacity 做指数退避重试,主模型挂了降级到备用模型。
- Key 安全:本地
.env加.gitignore,生产用 KMS,永不写死在代码里。 - 成本意识:每次调用读 usage 算钱并记日志,对小模型、缓存养成习惯。
十一、动手练习
练习 1(基础):注册 DeepSeek、通义其中一家(国内免费),用本篇的适配层代码跑通一次 client.chat(),把输出和 token 用量打印出来。
练习 2(进阶):用 compare.py 脚本,对同一个问题(如"用 200 字介绍杭州")分别调通义和 DeepSeek,记录两者的:响应内容、耗时、token 数、估算成本,写一份对比小结。
练习 3(挑战):给适配层加一个自动降级功能:主模型用 DeepSeek,调用失败自动切通义。再用 time.sleep 模拟一次 DeepSeek 超时,验证降级是否生效。(提示:参考第七节的 chat_with_fallback,把它做成适配层的一个方法。)
十二、延伸阅读
- OpenAI API 官方文档:https://platform.openai.com/docs/api-reference
- Anthropic Claude 文档:https://docs.anthropic.com
- 通义千问兼容 OpenAI 文档:https://help.aliyun.com/zh/model-studio/developer-reference/use-qwen-by-calling-api
- DeepSeek API 文档:https://api-docs.deepseek.com
- tenacity 重试库:https://tenacity.readthedocs.io
- python-dotenv:https://github.com/theskumar/python-dotenv
- 模式参考:《设计模式》适配器模式(Adapter Pattern)章节,理解本篇适配层的设计思想