
字
字节笔记本
2026年10月6日 · 约 2 分钟读完
检索完先裁剪,证据按需取粒度
API中转
¥120
多模态 RAG 检索回来的证据,粗一点整段都进上下文,浪费且夹带噪声;细一点又可能把必要背景切掉。Hyojeong Yun 等人的 CANOPY(arXiv:2610.00923,Hugging Face 今日榜 9 赞)给这个两难给出了结构化解法:粒度不是选定的,是按查询自适应选出来的。
方法:层级、打分、精修、补检
第一步,把检索回来的文本、表格、图片、视频条目统一表示成层级结构。第二步,在金标准证据上微调的节点编码器对树的各区域按查询相关性打分。第三步,父相对精修从树上选出多个不同粗细的区域,重要的段落整块保留,无关的章节大胆丢弃;这一步的节点级剪枝完全不调用 LLM,成本压得住。第四步是个闭环:批评家组件发现累计证据不够时,发起定向补检,新证据同样先压缩再入库。
数字怎么说
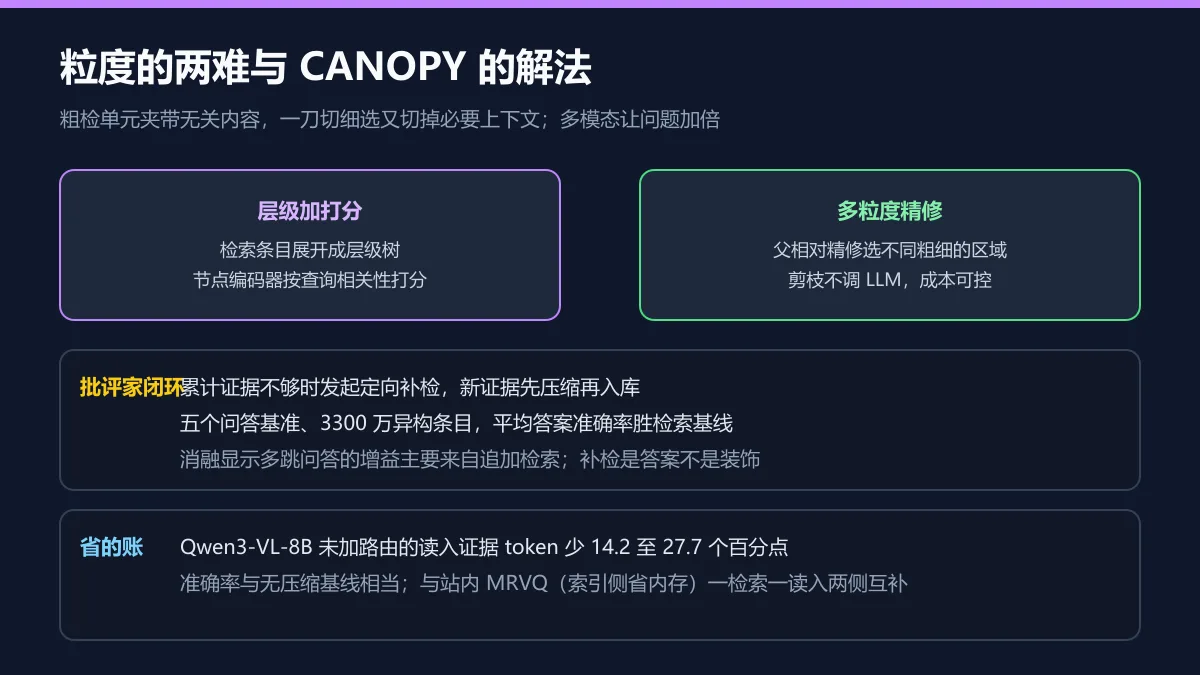
评测规模给得扎实:五个问答基准、三千三百万条异构语料,平均答案准确率超过检索基线;消融显示多跳问答的增益主要来自补检机制,说明批评家是真在干活而不是装饰。工程账更直观:用未加路由的 Qwen3-VL-8B 做阅读器,读入的证据 token 比无压缩的同管线少 14.2 至 27.7 个百分点,准确率基本持平。论文 26 页,项目页已开放,代码链接暂未见。
放进站内 RAG 线
这篇补的位置很清楚。MRVQ 管索引侧(同一份量化产物多档位省内存),CANOPY 管读入侧(证据进上下文前按粒度裁剪),两篇加上此前的 RAG 四轴图谱,检索管线的省 token 账在两头都齐了。做多模态知识库的团队,批评家定向补检的设计尤其值得抄:它把补检索这件事从固定流程变成了按证据充分性的条件动作。
相关文章
分享: