字节笔记本
2026年10月6日 · 约 45 分钟读完
AI 工作流专栏 20:MCP 与 A2A 协议全解
本文是 AI 工作流专栏的第 20 篇,主题是 MCP 与 A2A 这两个协议。打开 2025、2026 年的 AI 工程师招聘 JD,会发现一句话开始反复出现:"了解 MCP(Model Context Protocol)或 A2A(Agent-to-Agent)协议者优先"。这两个词在两年前根本不存在,现在已经成了 AI 工程的"硬通货"。为什么?因为我们终于撞上了一堵墙:工具太多,AI 应用太多,两两对接的代码写到怀疑人生。
先从 Function Calling(函数调用)说起:你给 LLM 定义几个工具,它就能自己决定调哪个。听着很美,但真到公司里你会发现:Claude 用一套工具格式、GPT 用另一套、通义又是一套;而且每接一个新工具(GitHub、Slack、数据库),都得在每个 AI 应用里重新写一遍适配代码。3 个 AI 应用 × 10 个工具 = 30 套集成代码,写到天荒地老。
本篇就来彻底解决这个"集成地狱"。前半篇讲 MCP(Model Context Protocol,模型上下文协议):Anthropic 在 2024 年底开源的协议,被称为"AI 时代的 USB-C 接口",它把"N×M 套集成"砍成"N+M"。后半篇讲 A2A(Agent-to-Agent,代理间协议):Google 在 2025 年主导、2026 年已捐给 Linux 基金会的协议,专门解决"多个 Agent 怎么跨框架协作"。本篇精华是手写一个真正能跑的 MCP Server(用官方 mcp Python SDK 的 FastMCP),写完直接接进 Claude Desktop / Cursor 看效果。读完你会理解,为什么这两个协议是未来 3 年 AI 工程的基础设施。
本篇你将学到:
- MCP 到底解决什么问题:从"N×M 集成地狱"到"N+M 标准化"的范式转变
- MCP 的三层架构:Client(AI 应用)/ Server(工具包装)/ Protocol(JSON-RPC 通信)
- MCP 的三大核心能力:Tools(工具调用)/ Resources(数据读取)/ Prompts(提示模板)
- 实战精华:用官方
mcpPython SDK 的 FastMCP,从零手写一个"本地文件系统" Server,定义list_files和read_file两个工具,代码完整可跑 - 怎么把你的 MCP Server 接进 Claude Desktop / Cursor,看真实效果
- MCP 生态全景:浏览官方 servers 仓库里的实用 Server(GitHub / Slack / PostgreSQL / 浏览器 / 文件系统)
- A2A(Agent-to-Agent)协议:解决什么、和 MCP 的本质区别、核心概念(Agent Card 名片 / Task / Message)、2026 年现状
- MCP、Function Calling、A2A 三者关系:一张表彻底分清
- 为什么 MCP 对 AI 工程师是"跨系统集成能力"的代名词,以及它如何写进你的简历
一、MCP 解决什么问题:从"N×M"到"N+M"
1.1 生活类比:充电线的"战国时代"与 USB-C 统一
想象 2015 年以前的充电线抽屉:苹果用 Lightning、老安卓用 Micro-USB、相机用专用圆口、笔记本用各种圆头、Switch 用自家的、电动牙刷又是另一种……你出门得背一捆线。每出一个新设备,就得再买一根专用线。
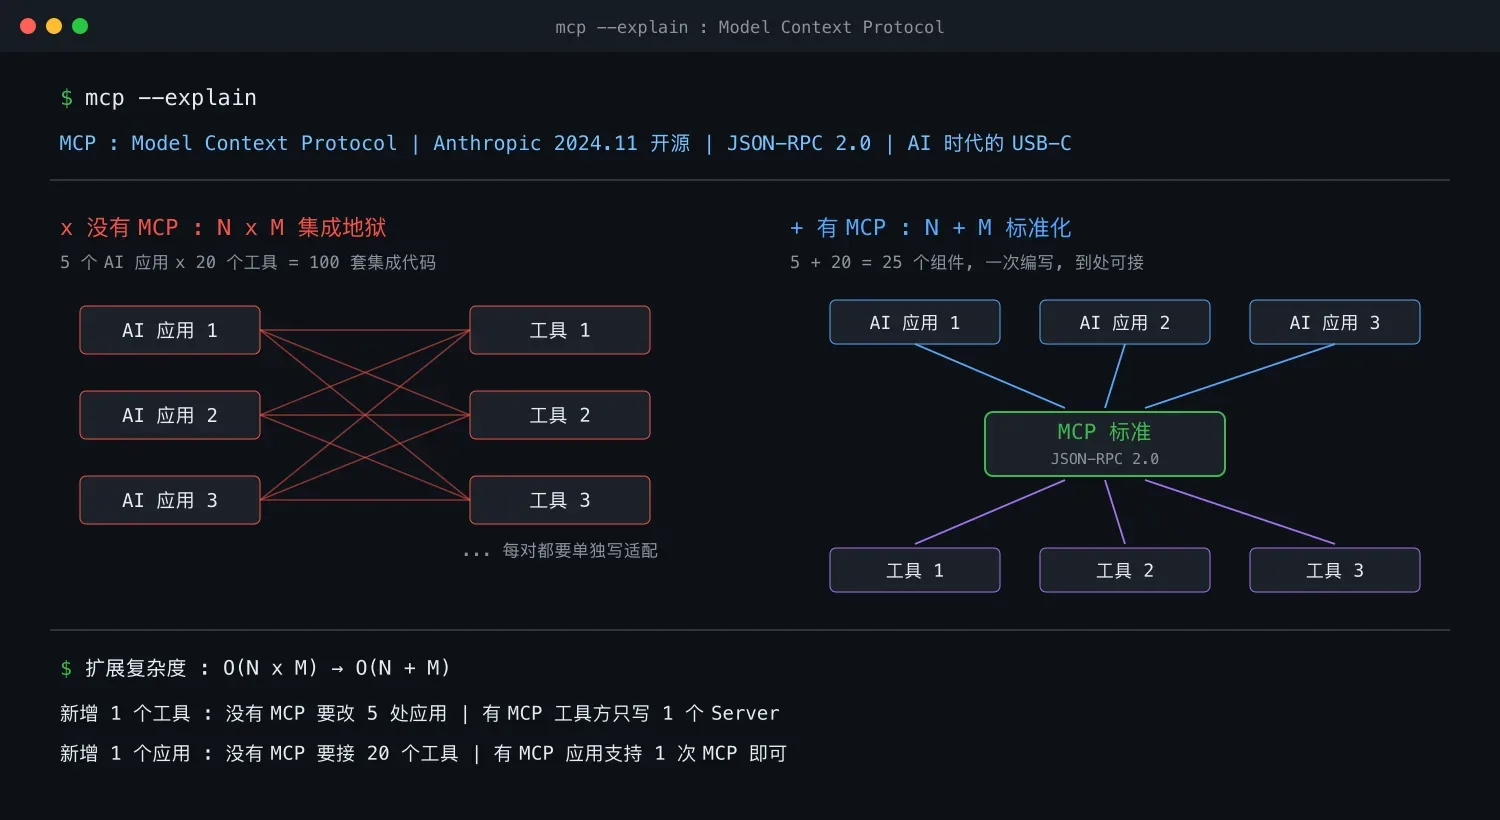
这就是没有标准的痛苦:N 种设备 × M 种接口规格 = N×M 种线。
然后 USB-C 出来了。一个标准,正反都能插,手机、平板、笔记本、耳机、显示器全用它。你的设备只要支持 USB-C,随便拿一根线就能充、能传数据。世界瞬间清爽:从 N×M 套线,变成了 N+M。设备各自支持标准(N),线也只要符合标准(M),中间那个标准把两边解耦了。
MCP 之于 AI 工具,就是 USB-C 之于充电线。
在 MCP 之前,AI 应用要接工具是这样的:
- 你想让 Claude Desktop 读你的 GitHub,要写一套对接代码
- 你想让 Cursor 读同一个 GitHub,要再写一套对接代码(格式还不一样)
- 你想让 用 OpenAI 接口写的 Agent 读同一个 GitHub,又要写一套
3 个 AI 应用 × 1 个 GitHub 工具 = 3 套代码。再加 Slack、数据库、文件系统……5 个 AI 应用 × 20 个工具 = 100 套集成代码。每套都要调试、维护、随 API 变动而更新。这就是所谓的 "集成地狱"(Integration Hell)。
MCP 把中间那层标准化了:工具方只要写一个 MCP Server,任何支持 MCP 的 AI 应用(Claude、Cursor、Cline、Windsurf……)都能直接用,一次编写,到处可接。5×20=100 变成了 5+20=25。
1.2 专业定义
MCP(Model Context Protocol,模型上下文协议):Anthropic 于 2024 年 11 月开源的开放协议,定义了大模型应用与外部数据源/工具之间的标准通信方式。它基于 JSON-RPC 2.0,让任何 AI 应用(MCP Client)都能以统一的方式发现并调用任何工具方提供的能力(MCP Server)。MCP 已被 OpenAI、Google、Microsoft 等主流厂商支持,正在成为 AI 工具接入的事实标准。
1.3 集成成本的数学题:N×M 变 N+M
这是 MCP 最值得记住的一个论点。我们用一张表说清楚:
| 场景 | 没有 MCP(点对点对接) | 有 MCP(标准协议居中) |
|---|---|---|
| 3 个 AI 应用 × 10 个工具 | 30 套集成代码 | 3 + 10 = 13 个组件(每边各实现一次标准) |
| 5 个 AI 应用 × 20 个工具 | 100 套集成代码 | 5 + 20 = 25 个组件 |
| 新增 1 个工具 | 要改 所有 AI 应用(5 处) | 工具方写 1 个 Server,0 处改动 |
| 新增 1 个 AI 应用 | 要接 所有 工具(20 处) | 应用支持 MCP 1 次,0 处工具改动 |
注意最后两行,这是 MCP 最狠的优势:扩展时是 O(1),不是 O(N) 或 O(M)。你新加一个工具,不需要去求每个 AI 应用的开发者给你适配;你新做一个 AI 应用,也不需要从零对接几十个工具。只要双方都遵守 MCP 这一个标准,就能自动互通。
二、MCP 的架构:Client / Server / Protocol
2.1 生活类比:餐厅里的"前台、后厨、对讲机"
把 MCP 想成一家餐厅:
- MCP Client(客户端)= 前台服务员:它是 AI 应用本身(比如 Claude Desktop、Cursor)。服务员负责接待顾客(用户),听顾客说要什么菜,然后把需求转发给后厨。服务员本身不炒菜。
- MCP Server(服务端)= 后厨:它包装了某个具体的"能力"(比如"能读 GitHub"的后厨、"能查数据库"的后厨)。每个后厨只擅长做自己的菜,但它对外提供一份标准菜单,任何服务员都能照着点。
- Protocol(协议)= 对讲机:服务员和后厨之间用什么沟通?不能用各自方言(否则又乱套了),得用一套统一的话术:"几号桌、点啥菜、要不要辣"。这套统一话术就是 JSON-RPC,MCP 规定的通信格式。
关键点:服务员(Client)和后厨(Server)是解耦的。一个服务员可以同时对接多个后厨(中厨、西厨、甜品台),一个后厨也可以同时服务多个服务员。中间那台"对讲机"(JSON-RPC 协议)保证了大家都能听懂彼此。
2.2 三个角色的职责
| 角色 | 谁来扮演 | 职责 | 举例 |
|---|---|---|---|
| MCP Client | AI 应用 | 发起请求、管理连接、把工具结果交给 LLM | Claude Desktop、Cursor、Cline、你写的 Agent |
| MCP Server | 工具/数据提供方 | 把自己的能力用标准格式暴露出来 | GitHub Server、文件系统 Server、数据库 Server |
| Protocol(JSON-RPC) | 双方都遵守 | 规定消息格式、握手流程、能力协商 | tools/list、tools/call、resources/read 等方法 |
它们之间通信的典型流程是这样的:
- 启动:Client 启动一个 Server 进程(通常通过 stdio 标准输入输出,或 HTTP/SSE 网络传输)。
- 握手:双方交换"我是谁、我支持哪个版本、我有哪些能力"(初始化握手 + 能力协商)。
- 发现:Client 问 Server"你有哪些工具/资源?"(
tools/list),Server 返回一份清单。 - 调用:用户提问,LLM 决定要用某个工具,Client 发
tools/call给 Server,Server 执行并返回结果,Client 把结果喂回 LLM,LLM 继续回答。
2.3 MCP 的三大核心能力
一个 MCP Server 通常会暴露三种"商品",对应三类标准方法:
| 能力 | 类比 | 作用 | 标准方法 |
|---|---|---|---|
| Tools(工具) | 后厨能做的动作(炒菜、切配) | LLM 可以调用执行、有副作用 | tools/list、tools/call |
| Resources(资源) | 后厨的食材清单(只读数据) | LLM 可以读取、不带副作用 | resources/list、resources/read |
| Prompts(提示模板) | 后厨的招牌菜谱(预设模板) | 用户可选择的预设提示词 | prompts/list、prompts/get |
简单记忆:
- Tools = 动词("发条 Slack 消息""给文件改名",会改变世界)
- Resources = 名词("今天的日志""配置文件",只读数据)
- Prompts = 模板("代码审查模板""周报模板",预设提示)
绝大多数场景你只会用到 Tools,它是 Function Calling 的标准化升级版。Resources 和 Prompts 是锦上添花。本篇实战代码我们会把三者都演示一遍。
三、实战精华:手写一个能跑的 MCP Server
理论说够了,现在上手。我们用官方 mcp Python SDK(稳定版 v1.x)内置的 FastMCP,写一个"本地文件系统" Server,提供两个工具:list_files(列目录)和 read_file(读文件)。这段代码是本篇的精华,写完直接能接进 Claude Desktop。
3.1 安装 SDK
# 官方 Python SDK,稳定版自带 FastMCP
pip install "mcp[cli]>=1.0"
小贴士:FastMCP 是官方 SDK 内置的高层封装(在
mcp.server.fastmcp模块下),用装饰器把普通 Python 函数变成 MCP 工具,省掉了手写 JSON-RPC 的繁琐。它和社区独立项目fastmcp(PrefectHQ 出品,需pip install fastmcp)是两套东西,本篇用官方 SDK 自带的那个,最稳。
3.2 完整 Server 代码(可直接运行)
把下面这段保存为 file_server.py:
# file_server.py : 一个最小的 MCP 文件系统 Server
# 提供 list_files / read_file 两个工具,外加一个资源和一个提示模板
from pathlib import Path
from mcp.server.fastmcp import FastMCP

# 1) 创建一个 MCP Server 实例,给它起个名字
mcp = FastMCP("FileSystem")


# 2) 定义工具(Tools):LLM 可以"调用执行"的函数
@mcp.tool()
def list_files(directory: str = ".") -> str:
    """列出指定目录下的文件和文件夹。

    参数:
        directory: 要列出的目录路径(默认当前目录)
    返回:
        每行一个条目的字符串
    """
    base = Path(directory).expanduser().resolve()
    if not base.exists() or not base.is_dir():
        return f"错误:{directory} 不是一个有效目录"
    entries = sorted(base.iterdir(), key=lambda p: (not p.is_dir(), p.name.lower()))
    lines = []
    for p in entries:
        tag = "[目录]" if p.is_dir() else "[文件]"
        lines.append(f"{tag} {p.name}")
    return "\n".join(lines) if lines else "(空目录)"


@mcp.tool()
def read_file(path: str, max_chars: int = 2000) -> str:
    """读取一个文本文件的内容(截断到 max_chars 防止超长)。

    参数:
        path: 文件路径
        max_chars: 最多返回的字符数(默认 2000)
    """
    target = Path(path).expanduser().resolve()
    if not target.exists():
        return f"错误:文件不存在 {path}"
    if not target.is_file():
        return f"错误:{path} 不是文件"
    try:
        text = target.read_text(encoding="utf-8", errors="replace")
    except Exception as e:
        return f"读取失败:{e}"
    if len(text) > max_chars:
        text = text[:max_chars] + f"\n\n…(已截断,共 {len(text)} 字符,仅显示前 {max_chars})"
    return text


# 3) 定义资源(Resources):只读数据,用 URI 暴露
@mcp.resource("config://app")
def get_app_config() -> str:
    """暴露一份只读的配置信息给 LLM 读取。"""
    return "当前工作目录配置:允许访问当前目录及其子目录下的文件。"


# 4) 定义提示模板(Prompts):用户可选择的预设提示词
@mcp.prompt()
def summarize_code(file_path: str) -> str:
    """生成一个"总结代码文件"的提示词。"""
    return (
        f"请读取文件 {file_path} 的内容,"
        f"然后用三句话总结它的功能、关键函数和潜在问题。"
    )


# 5) 启动 Server(默认走 stdio 传输,适合本地 AI 应用)
if __name__ == "__main__":
    mcp.run()
读懂这段代码,要抓住几个要点:
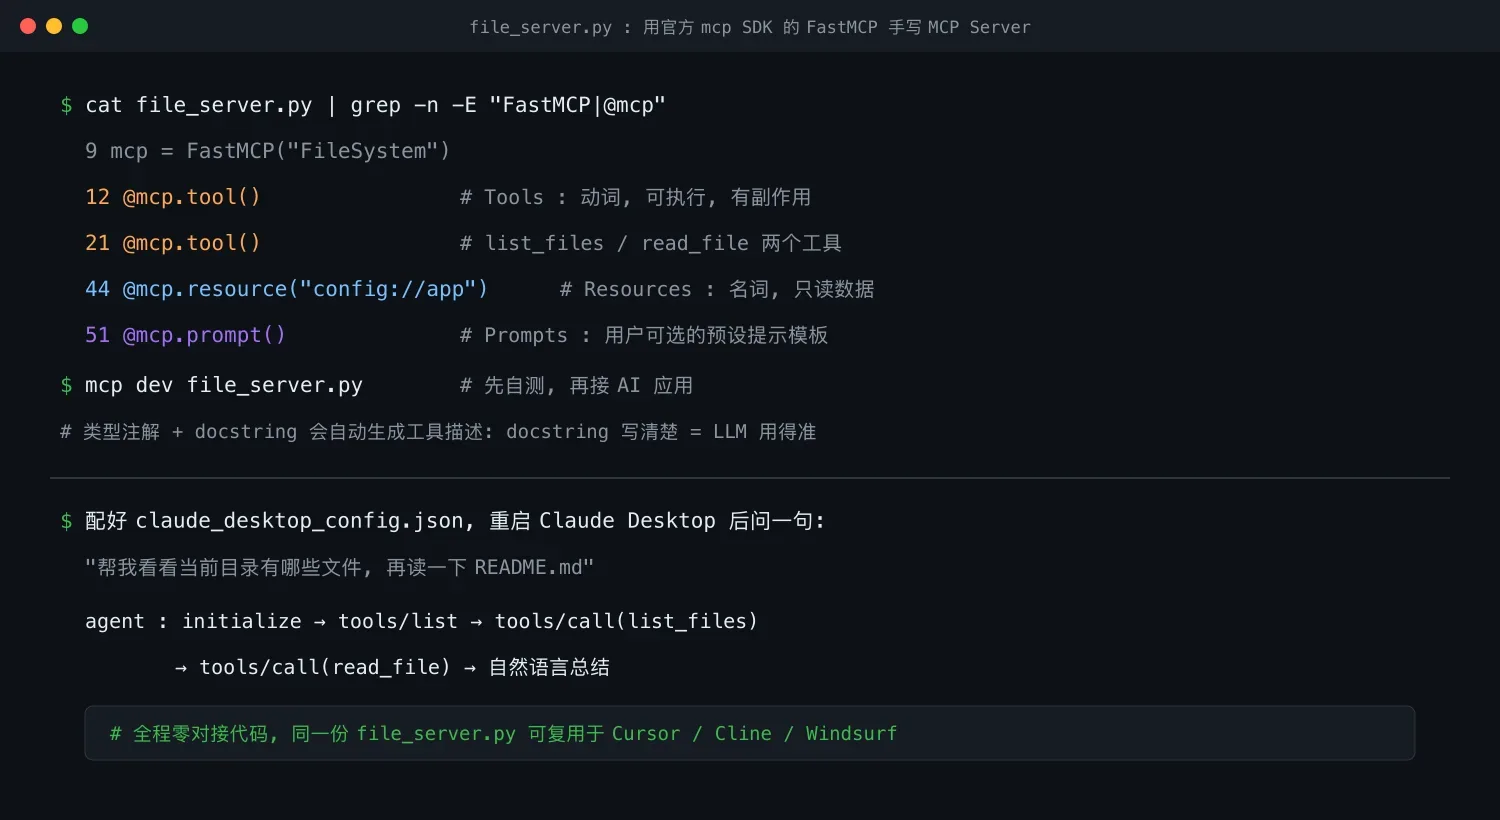
FastMCP("FileSystem")创建一个 Server,名字叫FileSystem,这个名字会显示在 AI 应用里。@mcp.tool()把下面的函数注册成工具。FastMCP 会自动从函数的类型注解(directory: str = ".")和docstring(三引号文档字符串)里提取参数说明:你写的中文 docstring 会直接成为 LLM 看到的工具描述,所以 docstring 写清楚 = LLM 用得准。@mcp.resource("config://app")用 URI(统一资源标识符)暴露只读数据,LLM 可以"读取"它而不是"调用"它。@mcp.prompt()定义一个预设提示模板,用户在 AI 应用里可以一键选用。mcp.run()启动 Server,默认用 stdio(标准输入输出)传输,也就是 AI 应用通过"管道"和它通信,不开网络端口,本地安全。
3.3 先本地自测一下(不依赖任何 AI 应用)
写完先别急着接 AI,我们可以用一个官方调试工具 mcp dev 来验证 Server 有没有问题:
mcp dev file_server.py它会启动一个交互式调试器(在浏览器里打开),你能看到:
- 左边列出这个 Server 暴露的所有 Tools / Resources / Prompts
- 右边可以手动点一个工具、填参数、直接执行,看返回值对不对
如果 list_files(".") 能正确列出你当前目录的文件,说明 Server 完全正常。这一步能帮你把 90% 的 bug(路径错误、类型不对、异常没处理)在接 AI 之前就消灭掉。强烈建议养成"先 mcp dev 自测,再接 AI 应用"的习惯。
小结:FastMCP 的优雅之处在于,你只是在写普通的 Python 函数,加一个装饰器,它就变成了一个符合开放标准、能被所有主流 AI 应用调用的工具。这就是"协议"的威力:业务逻辑是你的,标准是大家的。
四、把你的 Server 接进 Claude Desktop 与 Cursor
Server 写好了、自测过了,接下来让它真正"被 AI 用上"。
4.1 在 Claude Desktop 中配置
Claude Desktop(桌面版 Claude)原生支持 MCP。找到它的配置文件:
- macOS:
~/Library/Application Support/Claude/claude_desktop_config.json - Windows:
%APPDATA%\Claude\claude_desktop_config.json
打开(没有就新建),加入你的 Server:
{
  "mcpServers": {
    "filesystem": {
      "command": "python",
      "args": ["/绝对路径/file_server.py"]
    }
  }
}两个常见坑要提醒:一,args 里的脚本路径必须用绝对路径(Claude 启动时的工作目录不一定是你放脚本的地方);二,如果你的 python 命令对应的环境没装 mcp,要么用虚拟环境的绝对 python 路径,要么用 uv run / pipx run 启动。改完配置重启 Claude Desktop 才生效。
4.2 在 Cursor 中配置
Cursor(AI 编程 IDE)也原生支持 MCP。打开 Settings → Cursor Settings → MCP,点 + Add New MCP Server,填:
- Type:
stdio - Name:
filesystem - Command:
python /绝对路径/file_server.py
保存后,Cursor 的 Composer / Agent 模式就能自动发现并调用你的工具。
4.3 见证奇迹的时刻
配置好重启后,在 Claude Desktop 里输入一句自然语言:
"帮我看看当前目录下都有哪些文件,然后读一下 README.md 讲了啥。"
你会看到 Claude 自动做了三件事:
- 调用了你的
list_files工具,拿到目录列表; - 根据结果,又调用了
read_file工具,读出README.md内容; - 最后用自然语言给你总结。
整个过程你没写任何对接代码:Claude 通过 MCP 标准自动发现了你的工具、理解了参数、完成了调用。这就是"USB-C 插上就能用"的真实体验。
更要命的是:你同一个 file_server.py,不改一行代码,明天也能被 Cursor、Cline、Windsurf 用上。这就是 N+M 而不是 N×M。如果把"读文件"换成"调 GitHub API",你写的 GitHub Server 同样能被所有 AI 应用复用:写一次,处处可用。
五、MCP 生态:别重复造轮子
你不需要每个工具都自己写 Server。Anthropic 维护了一个官方仓库 modelcontextprotocol/servers,里面收录了大量"开箱即用"的 MCP Server。再加上社区贡献,截至 2026 年生态里已有数千个 Server。
挑几个最实用的让你感受下生态的丰富:
| Server | 能让 AI 干什么 | 典型用法 |
|---|---|---|
| filesystem | 读写本地文件 | "把这个文件夹里的笔记总结成一篇" |
| github | 查 issue、PR、提交代码 | "看看我仓库里最近哪些 PR 没合并" |
| slack | 读频道、发消息 | "把昨天 #engineering 频道的讨论总结发到 #standup" |
| postgres / sqlite | 用自然语言查数据库 | "查一下过去 7 天的下单量,画个趋势" |
| puppeteer / playwright | 控制浏览器、抓网页 | "打开这个网址,把产品价格抓下来对比" |
| brave-search / google | 联网搜索 | "搜一下最新的 MCP 教程,整理要点" |
| memory | 跨会话长期记忆 | "记住我喜欢用 TypeScript,下次别再问" |
生态的成熟意味着:很多时候你的工作不是"写 Server",而是"挑 Server + 配置 + 编排"。这跟传统软件工程里"先逛 npm/PyPI 再造轮子"是一个道理。当然,等你遇到公司内部系统(自研 OA、内部数据库)没有现成 Server 时,第 3 节学的"手写 Server"就派上用场了:这是你的核心竞争力。
六、A2A:Agent 之间的"协作语言"
讲完 MCP(AI 连工具),我们来聊它的"姊妹协议" A2A(Agent-to-Agent)。这两个经常被一起提及,但解决的是完全不同层面的问题。
6.1 生活类比:一个部门内部与两个公司之间
把 MCP 和 A2A 放进职场类比里,瞬间就懂了:
-
MCP = 一个部门内部协作。你(Agent)让助手(工具)去帮你订机票、查日历、发邮件。助手是你的"手脚",听你指挥干活。这是一个人指挥自己的工具。
-
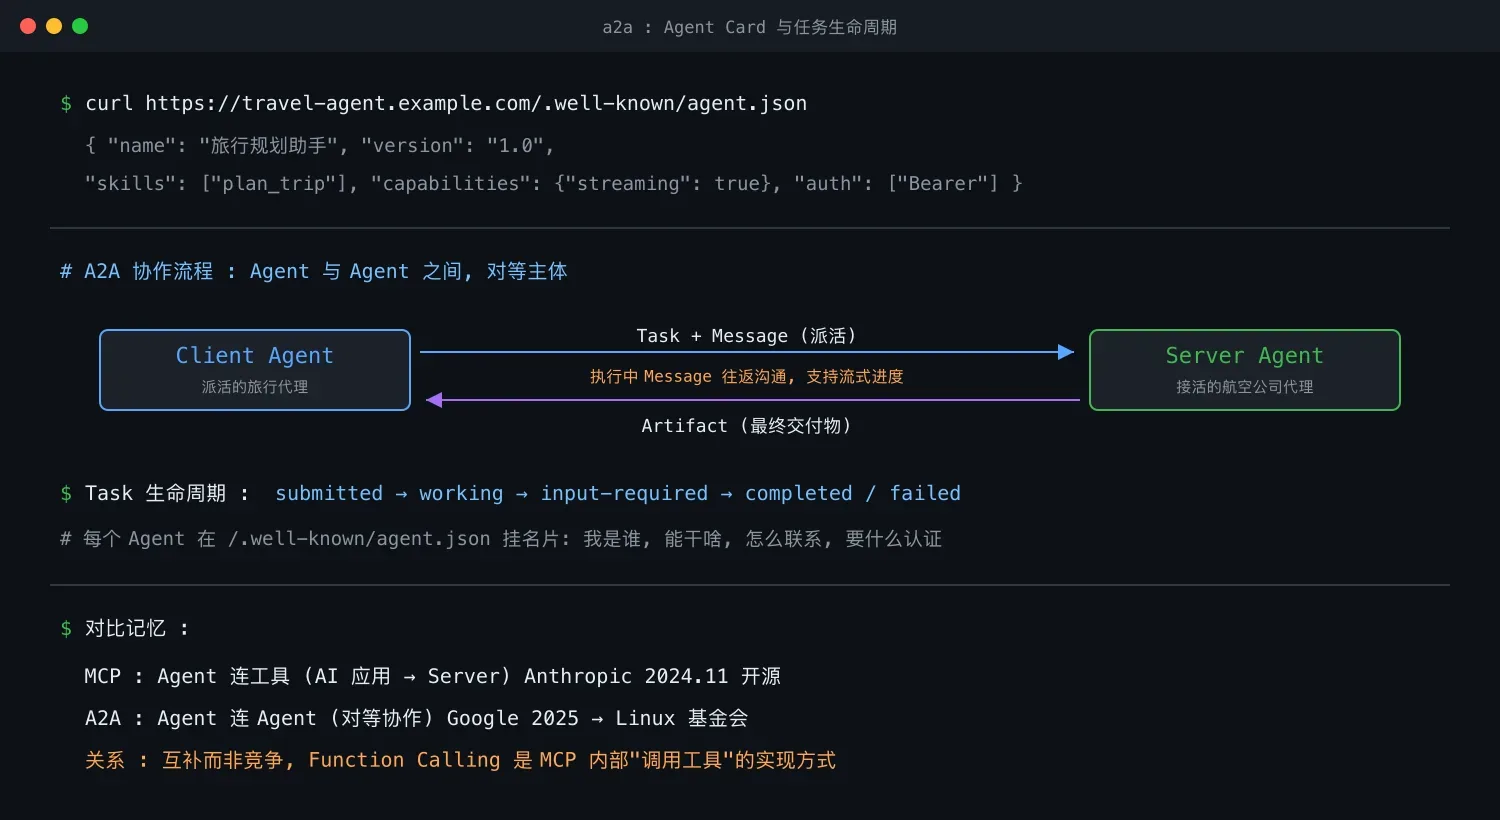
A2A = 两个独立公司之间协作。你的旅行社 Agent 想找航空公司的 Agent 订票,两家是独立的服务,互不隶属。你不能直接"指挥"对方,而是要谈判、委托、确认:你发个任务过去("帮我订 7 月 5 日北京到上海的最早航班"),对方接不接、怎么处理、什么时候交付,由它自己决定,然后把结果(一张机票确认单)回传给你。这是两个平等主体之间的协作。
差别在哪?MCP 里工具是被动的、无脑执行的函数;A2A 里对方 Agent 是主动的、有自己的大脑和判断。你问数据库"有多少订单",它必须答;但你问另一个 Agent"帮我策划行程",它会自己思考、可能反问、可能拒绝、可能分步交付。这就是为什么 A2A 需要"任务生命周期""消息往返"这些更复杂的概念。
6.2 专业定义
A2A(Agent-to-Agent,代理间协议):Google 于 2025 年 4 月主导发布、2026 年捐给 Linux 基金会的开放协议,专门解决多个独立 AI Agent 之间的发现、通信与协作。它让你用 LangChain 写的 Agent、用 CrewAI 写的 Agent、用 Google ADK 写的 Agent 能跨框架、跨厂商地互相找上门、派活、收结果。A2A 与 MCP 互补而非竞争:MCP 是"Agent 连工具",A2A 是"Agent 连 Agent"。
6.3 A2A 的核心概念
A2A 规定了几个关键对象,理解它们就理解了 A2A:
| 概念 | 类比 | 作用 |
|---|---|---|
| Agent Card(代理名片) | 商务名片 | 每个 Agent 在固定网址 /.well-known/agent.json 挂出一张 JSON 名片,说明"我是谁、我能干啥、怎么联系我、要什么认证"。别的 Agent 靠它来发现你 |
| Task(任务) | 一份委托合同 | 客户端 Agent 派给服务端 Agent 的一件工作,有生命周期(提交、进行中、需要输入、完成/失败) |
| Message(消息) | 来回沟通的话 | 双方之间的一轮对话,带"角色"(user/agent),内容可以是文字、文件、结构化数据(多模态) |
| Artifact(产物) | 最终交付物 | Agent 完成任务后产出的结构化结果(一份报告、一张图、一段代码) |
一个典型的 A2A 协作流程是:
- 发现:客户端 Agent 访问对方网址,读取它的 Agent Card,了解它能干什么。
- 派活:客户端创建一个 Task,附带第一条 Message("帮我……")发过去。
- 执行:服务端 Agent 用自己的 LLM 思考、可能调用自己的 MCP 工具,期间通过消息反复沟通(可能反问"你预算多少?")。
- 交付:任务完成,返回一个 Artifact(最终成果)。
- 流式:整个过程可以流式(streaming)实时推送进度,就像 ChatGPT 打字机效果。
6.4 一个 Agent Card 长什么样
Agent Card 本质就是一段 JSON,挂在约定俗成的网址上。简化版示例:
{
  "name": "旅行规划助手",
  "description": "擅长制定行程、订机票酒店、推荐景点",
  "url": "https://travel-agent.example.com/a2a",
  "version": "1.0",
  "capabilities": {
    "streaming": true,
    "pushNotifications": false
  },
  "skills": [
    {
      "id": "plan_trip",
      "name": "行程规划",
      "description": "根据目的地和天数生成详细行程",
      "tags": ["travel", "planning"]
    }
  ],
  "authentication": {
    "schemes": ["Bearer"]
  }
}
有了这张名片,任何 Agent 只要访问 https://travel-agent.example.com/.well-known/agent.json,就知道"哦,这是个会规划行程的 Agent,走 Bearer 鉴权,支持流式",然后就能决定要不要、以及怎么跟它合作。这跟人类在职业社交网站上查对方简介是一个思路。
6.5 2026 年现状:方向重要,但尚处早期
说句实在话:相比 MCP 的"已经大规模落地",A2A 在 2026 年还相对早期。但它的势头很猛:
- 发布一年内已有 150+ 家企业/组织加入 A2A 项目,落地到了主要云平台(Google Cloud 等),并出现企业级生产用例。
- 协议已演进到 v1 稳定版,Google 的 Agent Development Kit (ADK) 1.0 原生集成 A2A。
- 支持的 Agent 框架越来越多:LangChain、CrewAI、Google ADK、AutoGen 等都在打通。
对个人开发者来说,现阶段重点掌握 MCP(它已经是你日常会用的工具),了解 A2A 的概念和方向(知道它解决什么、和 MCP 啥关系)就够了。等你做的系统真的需要"多个 Agent 跨服务协作"时,再深入 A2A 的实现细节不迟。但这两个名词,你现在就能在面试和 JD 里用对了。
七、MCP、Function Calling 与 A2A:一张表分清
这是读者最容易混淆的三个概念。Function Calling 指的是 LLM 单次调用一个函数的能力,这里把它与 MCP、A2A 放在一起,做一次彻底的澄清。
7.1 生活类比:点菜的三种境界
-
Function Calling = 你直接对服务员喊:"把这份牛肉面端上来!"单次、直接、你和服务员一对一。这是最原始的"让 AI 调一个函数"。
-
MCP = 餐厅统一的服务标准。所有服务员(AI 应用)都按同一本"标准菜单"点单(发现工具),所有后厨(工具)都按同一套格式接单(暴露能力)。Function Calling 还是在用,但它被标准化了,不再是各家各派各写一套格式。
-
A2A = 两家餐厅之间互相介绍生意。你所在的火锅店(Agent A)没有甜点,于是你联系隔壁的甜品店(Agent B):"帮我准备一份芒果班戟。"甜品店是个独立的店、有自己的厨师和判断,你们是平等合作而非指挥。
7.2 对比表
| 维度 | Function Calling | MCP | A2A |
|---|---|---|---|
| 本质 | LLM 单次调用一个函数 | 工具发现与调用的标准协议 | Agent 之间的协作协议 |
| 连接谁和谁 | LLM 与一个函数 | AI 应用(Client)与工具(Server) | Agent 与 Agent |
| 类比 | 你喊服务员上菜 | 统一的点餐标准 | 两家餐厅互相介绍生意 |
| 被调用方有没有"大脑" | 没有,纯函数 | 没有,被动工具 | 有,是独立 Agent |
| 是否标准化 | 各家格式不同(OpenAI/Claude/通义各异) | 跨厂商统一(JSON-RPC) | 跨框架统一(HTTP+JSON-RPC) |
| 谁主导 | 各大模型厂商各自定义 | Anthropic(2024)开源 | Google(2025),后捐 Linux 基金会 |
| 关系 | 是 MCP 内部"调用工具"的实现方式 | 包含并标准化了 Function Calling | 与 MCP 互补,不冲突 |
一句话总结:Function Calling 是"一次调用",MCP 把它标准化成"一套可发现的工具市场",A2A 把它升级成"一群会思考的 Agent 互相对话"。它们是三个层次,不是三个竞争者。
八、为什么 MCP 对 AI 工程师如此重要
最后,我们把视线拉回"职业"层面。为什么 JD 要专门写"了解 MCP 或 A2A 协议优先"?因为这两个协议背后,是一种稀缺能力的代名词:跨系统 AI 集成能力。
8.1 "写一次工具,所有 AI 应用都能用"的杠杆效应
传统做法里,你给公司搭一个"AI 查内部数据库"的能力,可能要:给销售用的 Claude 接一套、给运营用的自研 Agent 接一套、给 BI 看板接一套,三套代码、三套维护。一旦数据库接口变了,改三处。
用了 MCP,你只写一个数据库 Server,三家 AI 应用全秒接。数据库变了,只改一处。这种"杠杆"在工程师眼里就是生产力的数量级提升,是老板最爱的"降本增效"。能在简历上写"基于 MCP 设计公司统一的工具接入层,将 N 套集成代码收敛为 1 套,复用于 X 个 AI 应用",这是非常硬的亮点。
8.2 它让你站在"标准"这一边
技术圈有个规律:谁站在标准这一边,谁就搭上了生态的便车。HTTP 标准化了网页通信,于是你会写一个网站全世界都能访问;USB-C 标准化了接口,于是你做一个配件所有设备都能用。MCP 正在标准化 AI 与工具的连接:你现在学会写 MCP Server,等于把自己接入了一个正在指数级增长的生态。Anthropic、OpenAI、Google、Microsoft 全在推,Cursor、Claude、Cline、Windsurf 全在用,社区 Server 数千个,这不是某个厂商的私货,是行业共识。
8.3 简历怎么写
给你两个可直接套用的简历句式(结合本篇所学):
- "跨系统集成:基于 MCP 协议(Python FastMCP)开发公司内部工具接入层,封装数据库 / GitHub / 飞书等 8 个 Server,一次编写即可被 Claude Desktop、Cursor 及自研 Agent 复用,工具集成成本降低 70%。"
- "协议选型与多 Agent 架构:在项目中辨析并应用 Function Calling / MCP / A2A 三层协议,用 MCP 标准化工具调用,用 A2A 编排跨服务 Agent 协作,支撑日均 X 次的自动化工作流。"
面试被问到"MCP 和 Function Calling 啥区别"时,你能答出"Function Calling 是单次调用的实现方式,MCP 是工具发现与调用的标准化协议,A2A 则是 Agent 间的协作协议,三者是层次关系不是竞争关系",面试官会眼前一亮。
本篇小结
用最浓缩的话回顾本篇:
- MCP 解决"N×M 集成地狱":把每个 AI 应用对接每个工具的乱局,收敛成"N+M",靠的是一个居中的开放标准。它是 AI 时代的 USB-C。
- MCP 三层架构:Client(AI 应用,如 Claude Desktop / Cursor)+ Server(工具包装)+ Protocol(JSON-RPC 通信)。
- MCP 三大能力:Tools(动词、可执行、有副作用)/ Resources(名词、只读数据)/ Prompts(模板、预设提示)。绝大多数场景用 Tools。
- 手写 MCP Server 用官方
mcpSDK 的 FastMCP,核心就三步:FastMCP()建实例,@mcp.tool()注册函数(靠类型注解 + docstring 自动生成描述),mcp.run()启动。先mcp dev自测,再接 AI 应用。 - MCP 生态已数千个 Server,常用:filesystem / github / slack / postgres / 浏览器 / 搜索 / memory。先逛生态,再考虑自己写。
- A2A 是 Agent 与 Agent 的协作协议(Google 主导,已捐 Linux 基金会),核心概念:Agent Card(名片)/ Task(任务)/ Message(消息)/ Artifact(产物)。与 MCP 互补,2026 年仍处早期但方向重要。
- 三者层次:Function Calling(单次调用)→ MCP(标准化工具协议)→ A2A(Agent 协作协议),不是竞争是递进。
- 职业价值:MCP 是"跨系统 AI 集成能力"的代名词,让你写一次工具、复用所有 AI 应用,是降本增效的硬技能。
动手练习
练习 1(基础):把本篇第 3 节的 file_server.py 跑起来。先用 mcp dev file_server.py 在调试器里手动调用 list_files 和 read_file,确认能正确列出和读取文件。然后给它再加一个工具 word_count(path),统计一个文本文件的字数和行数,记得写好 docstring,让 LLM 能理解。
练习 2(进阶):把你的 Server 接进 Claude Desktop 或 Cursor。配置好重启后,用一句自然语言(如"看看我项目目录里最大的几个文件是啥")让它自动调用你的工具。观察它是怎么"发现工具、填参数、拿结果"的,感受"插上即用"。
练习 3(挑战 + 探索):去 modelcontextprotocol/servers 仓库,挑一个 github 或 sqlite 的官方 Server,按它的 README 配进你的 AI 应用。然后思考:如果公司有一套自研的内部 OA 系统没有现成 Server,你会怎么用第 3 节学的方法给它"包一个 MCP Server"?把核心工具函数的签名和 docstring 先写出来(不用实现具体逻辑),这就是你在公司里"造轮子"的第一步。
延伸阅读
- MCP 官方文档(协议规范 + Python/TS SDK 教程):https://modelcontextprotocol.io
- MCP Python SDK(官方仓库,含 FastMCP 完整 API):https://github.com/modelcontextprotocol/python-sdk
- 官方 Servers 仓库(开箱即用的 Server 集合):https://github.com/modelcontextprotocol/servers
- FastMCP 文档(社区版,API 设计参考):https://gofastmcp.com
- A2A 协议官网与规范(Agent Card / Task / Message 详解):https://a2a-protocol.org/latest/specification/
- Google 官宣 A2A(为什么需要 Agent 互操作):https://developers.googleblog.com/en/a2a-a-new-era-of-agent-interoperability/
- Google 官方论坛:A2A、MCP、ADK 三者角色澄清:https://discuss.google.dev/t/a2a-mcp-and-adk-clarifying-their-roles-in-the-ai-ecosystem/190226
- MCP vs A2A 深度对比(TrueFoundry,含企业集成场景):https://www.truefoundry.com/blog/mcp-vs-a2a
专栏接下来会转向"自己造发动机":本地模型部署。用 Ollama 在你的笔记本上跑起开源大模型(Llama、Qwen、DeepSeek),用 vLLM 在 GPU 服务器上做高并发推理。"能用 API 就别本地部署"和"必须本地部署"这两种声音都对,区别只取决于你的场景(成本、隐私、延迟、可控性)。