字节笔记本
2026年10月6日 · 约 51 分钟读完
AI 工作流 13:向量数据库怎么选与实战
本文是 AI 工作流专栏的第 13 篇。RAG 的核心思路是"先检索、再生成",但"检索"这一步,到底把向量存在哪儿、怎么快速找出来?这就是向量数据库(Vector Database)要解决的问题。如果你以为它只是"另一个数据库",那就太小看它了:它能让模型"3 毫秒内从一亿段文字里找到最像的 5 段",是 RAG 系统名副其实的"仓库"。本文会横评 4 大主流向量数据库:pgvector / Pinecone / Qdrant / Weaviate,然后重点手把手教 pgvector(因为它长在 PostgreSQL 上,是 AI 工程师最该会的)和 Qdrant(开源、Rust 写、性能强、推荐自建)。读完你能直接动手搭一个本地向量库,跑通"存进去、查出来"的完整闭环。
本文你将学到:
- 向量数据库是什么:和 MySQL/PostgreSQL 这类关系型数据库的根本区别("按旋律找歌"类比)
- 三个核心概念:向量、相似度度量(余弦/欧氏/点积)、ANN 近似最近邻索引(HNSW / IVF)
- 四大主流横评:pgvector / Pinecone / Qdrant / Weaviate(一张对比表选型)
- pgvector 实战:Docker 启动 → 建表 → HNSW 索引 → 增删改查 + 相似度检索(SQL + Python)
- Qdrant 实战:Docker 启动 → collection → Python client 增删改查 + 过滤检索
- 选型决策树:什么场景用什么库
- 性能优化:HNSW 参数(m / ef_construction)、过滤检索、批量插入、分片
一、什么是向量数据库
1.1 生活类比:按旋律找歌
你一定用过音乐 App 的"听歌识曲"功能:你哼了段旋律,App 几秒钟就告诉你"这是周杰伦的《晴天》"。它不是在歌名里搜"晴天"两个字,而是把旋律变成一串数字特征,然后在百万首歌的"旋律特征库"里找最接近的那首。这种"找最像的",就叫相似度检索。
再换个例子:你在淘宝拍了一张红色连衣裙的照片,想搜同款。淘宝不是按"红色""连衣裙"两个关键词去商品标题里搜(那样搜出来一堆挂羊头卖狗肉的),而是把图片变成一串数字,去商品库里找图片数字最接近的商品。
这两种"找最像"的活儿,关系型数据库干不了,它只会"按 ID 精确查"。
- 关系型数据库(MySQL/PostgreSQL) = 图书馆按"书名/作者/ISBN"找书。你告诉它"我要《三体》",它精确返回。但你问"我要一本跟《三体》风格像的",它就懵了。
- 向量数据库 = 听歌识曲 / 拍照搜物。你给它"一个样本"(一段文字、一张图、一段语音),它返回"最像的 N 个"。
1.2 专业定义
向量数据库(Vector Database):一种专门用于存储高维向量(embedding,通常是几百到几千维的浮点数组),并对这些向量做相似度检索(找"最近的 N 个向量")的数据库系统。
在 RAG 系统里,它的位置长这样:
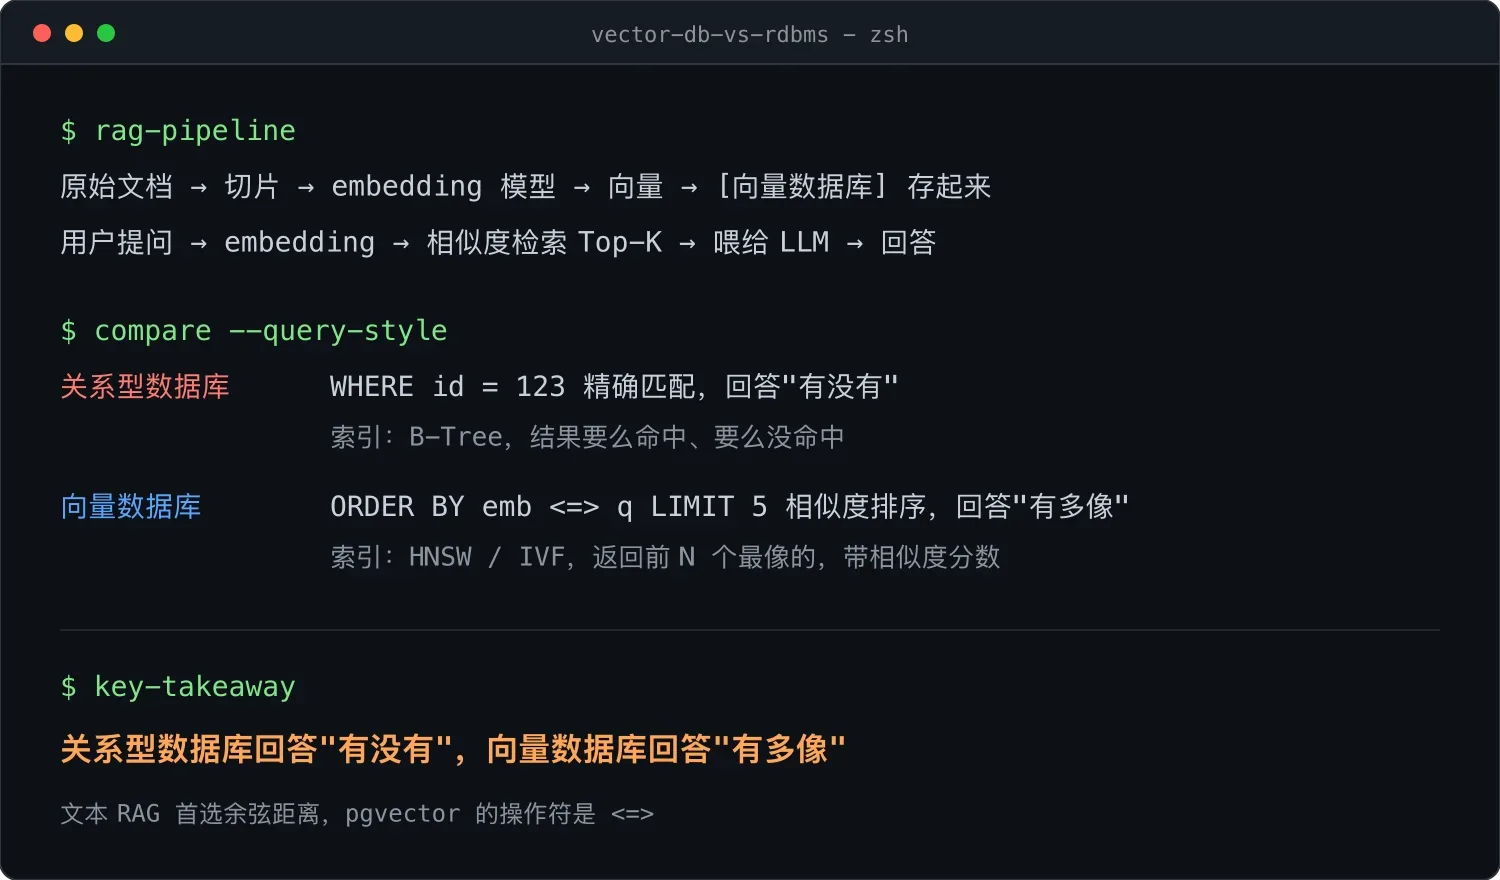
原始文档 → 切片 → embedding 模型 → 向量 → 【向量数据库】存起来
                                                          ↑
                            用户提问 → embedding → 去【向量数据库】找最像的 → 喂给 LLM
RAG 链条里,向量数据库就是那个"仓库",本文把它彻底搞明白。
1.3 和关系型数据库的根本区别
| 维度 | 关系型数据库(PostgreSQL) | 向量数据库 |
|---|---|---|
| 存什么 | 表、行、字段(int / text / date…) | 向量(float 数组)+ 元数据 |
| 查询方式 | WHERE id = 123 精确匹配 | ORDER BY 距离 LIMIT 5 相似度排序 |
| 索引 | B-Tree(精确范围查) | HNSW / IVF(近似最近邻) |
| 结果 | 命中或没命中 | "前 5 个最像的",带相似度分数 |
| 典型 SQL | SELECT * FROM users WHERE age > 18 | SELECT * FROM docs ORDER BY emb <=> $1 LIMIT 5 |
一句话总结:关系型数据库回答"有没有",向量数据库回答"有多像"。
二、三个核心概念
在动手之前,必须搞懂三件事,否则后面写代码全是"知其然不知其所以然"。
2.1 概念一:向量(Vector / Embedding)
生活类比
想象你要描述一个人的"长相特征",可以用一组数字:身高 175、体重 70、肩宽 42、肤色 0.7……把很多特征拼成一个数组,就是这个人的"特征向量"。
文字、图片、音频也一样:通过 embedding 模型把任意内容压缩成一个固定长度的浮点数组。比如 OpenAI 的 text-embedding-3-small 模型,会把任何一段文字压成 1536 维的数组。这个数组就是这段文字的"语义坐标":意思越接近的文字,坐标点越挨在一起。
专业定义
向量(Vector / Embedding):用一组浮点数
[0.12, -0.45, 0.88, ...]表示一段内容的"语义特征",维度通常是 384 / 768 / 1024 / 1536 等。语义相近的内容,向量在高维空间里距离很近。
举几个真实的向量例子(用 3 维简化示意):
"猫"     → [0.21, 0.55, 0.10]
"小猫"   → [0.20, 0.56, 0.09]   ← 和"猫"非常接近
"狗"     → [0.18, 0.50, 0.12]   ← 也比较近(都是动物)
"汽车"   → [0.90, -0.30, 0.77]  ← 和前三个都很远
你看,"猫"和"小猫"几乎重合,和"汽车"十万八千里,这就是 embedding 的魔力。
2.2 概念二:相似度度量(Similarity Metric)
生活类比
怎么判断两个向量"有多像"?有三种常见的"尺子":
- 余弦相似度(看角度):两个人朝同一个方向走,不管走多远,只要方向一致就算像。适合"比内容方向,不比长短"。
- 欧氏距离(看直线距离):两个人站在哪儿,量一下直线距离多远。近的就算像。
- 点积(看投影):一个人在另一个人方向上"投影"有多长。
专业定义
相似度度量(Similarity Metric):把两个向量算成一个标量值,表示它们"有多接近"的数学方法。常用三种:
- 余弦相似度/距离:算两个向量夹角的余弦值。范围 -1 到 1,越接近 1 越像(距离则反过来,0 最像)。忽略向量长度,只看方向,文本检索最常用。
- 欧氏距离(L2):两点间直线距离。越小越像。图像、音频有时用它。
- 点积(内积 / Dot Product):两个向量对应位相乘再相加。归一化后的向量上,等价于余弦相似度。
代码示意:三种度量的计算
# similarity_demo.py: 三种相似度度量
import numpy as np

a = np.array([1.0, 2.0, 3.0])
b = np.array([2.0, 4.0, 6.0])  # 和 a 方向一致,长度翻倍

# 1. 余弦相似度(忽略长度,方向一致就为 1)
cosine = np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))
print("余弦相似度:", cosine)  # 1.0(方向完全一致)

# 2. 欧氏距离(看绝对位置)
euclidean = np.linalg.norm(a - b)
print("欧氏距离:", euclidean)  # 3.74(位置差不少)

# 3. 点积(受长度影响)
dot = np.dot(a, b)
print("点积:", dot)  # 28.0
怎么选? 文本 RAG 99% 用余弦距离(embedding 一般都归一化了,余弦和点积等价,但余弦更直观)。pgvector 里余弦距离的操作符是 <=>,记住这个符号,后面要用。
2.3 概念三:ANN 近似最近邻索引
生活类比
假设你要在 1 亿张人脸照片里,找和"嫌疑人照片"最像的 5 张。最笨的办法:挨个比对,算 1 亿次相似度,慢得离谱(暴力搜索)。
聪明的办法:先给所有照片建个索引,按"长得像的聚在一起"原则分好类,查的时候先定位到某个类,再在类里细查,快得多,但可能漏掉一点点(所以叫"近似")。
就像你查字典找"狗"字:不会从第一页翻到最后一页(暴力),而是先翻到"G"部首(粗筛),再在"G"里找"狗"(细查)。牺牲一点点准确率,换来几万倍速度提升,这就是 ANN 索引的精髓。
专业定义
ANN(Approximate Nearest Neighbor,近似最近邻)索引:一种为"找最近的 N 个向量"专门设计的数据结构。比起暴力搜索的 O(N) 时间,ANN 能做到接近 O(log N)。代价是结果是"近似"的(可能漏掉个别真正最近的),但召回率通常能到 95% 以上。两大主流算法:
- HNSW(Hierarchical Navigable Small World,分层可导航小世界图):把向量组织成多层图,从上层稀疏图快速跳到目标区域,再在下层细查。查询快、召回高,但构建慢、吃内存,目前主流首选。
- IVF(Inverted File,倒排文件):先把向量空间分成 N 个"格子"(cluster),查的时候先定位格子,再在格子里暴力搜。构建快、省内存,但召回略低。
三、四大主流向量数据库横评
市面上的向量库一大把,但工程上真正主流的就 4 个。下面这张表你存下来,选型直接照着查。
3.1 横评对比表
| 维度 | pgvector | Pinecone | Qdrant | Weaviate |
|---|---|---|---|---|
| 类型 | PostgreSQL 插件 | 全托管云服务 | 开源(Rust) | 开源(Go) |
| 开源/收费 | 完全开源免费 | 商业 SaaS(按用量付费) | 开源免费(云版另收费) | 开源免费(云版另收费) |
| 部署方式 | 自建(Docker / 实例) | 只能用它的云 | 自建 Docker / 它的云 | 自建 Docker / 它的云 |
| 数据出境 | 否,数据不出你的机房 | 注意:数据进美国/欧洲云 | 否,自建就不出 | 否,自建就不出 |
| 性能 | 中上(百万级够用,亿级吃力) | 高(全托管优化好) | 高(Rust 写,快) | 中上 |
| 学习成本 | 低(会 SQL 就会) | 极低(API 调用) | 中(学 client API) | 中 |
| 和业务数据集成 | 最佳(同一库,事务一致) | 一般(要同步两份数据) | 好 | 好 |
| 多模态 | 文本为主 | 文本 | 文本 + 图 | 强(内置多模态模块) |
| 典型场景 | 企业内部知识库、和个人业务数据一起存 | 快速验证、不想运维 | 自建高性能向量服务 | 多模态应用、图谱增强 |
3.2 四个库的特点一句话点评
-
pgvector:你是 AI 工程师,这个必须会。因为它长在 PostgreSQL 上:你的用户表、订单表、对话历史表都在同一个库,加一列
embedding vector(1536)就能做向量检索,业务数据和向量在同一个事务里,没有"数据一致性"的噩梦。Supabase、阿里云 RDS 默认都带它。 -
Pinecone:最省心。注册账号、拿个 API key,
upsert/query几行代码搞定,不用管运维、不用管扩容。但贵(百万向量每月几十到几百美元),而且数据要出境,国内合规敏感的场景直接 pass。适合快速做 MVP、原型验证。 -
Qdrant:开源里性能最好之一(Rust 写的,内存和并发都强)。Docker 一行命令启动,自带漂亮的 Dashboard UI。推荐自建向量库时的首选。API 设计干净,过滤检索("先按部门筛,再向量搜")很优雅。
-
Weaviate:多模态最强。内置了文本/图片的 embedding 模块(可以自动把文本转向量,省一步),还支持图谱式查询。如果你要做"图文混合检索",它最顺手。但纯文本 RAG 场景,没必要上它。
3.3 小结:本文为什么重点教 pgvector 和 Qdrant
- pgvector:AI 工程师最该会,它和你的业务数据天然在一起,绝大多数企业 RAG 项目都用它(或最终会迁到它)。
- Qdrant:自建高性能向量服务的首选,开源、快、文档好、API 优雅。
Pinecone 太简单(看文档 10 分钟就会),Weaviate 太场景化,所以本文把笔墨集中在这两个最值得深学的库上。
四、pgvector 实战(重点)
接下来手把手搭一个 pgvector,跑通"建库 → 插入 → 相似度检索"全流程。
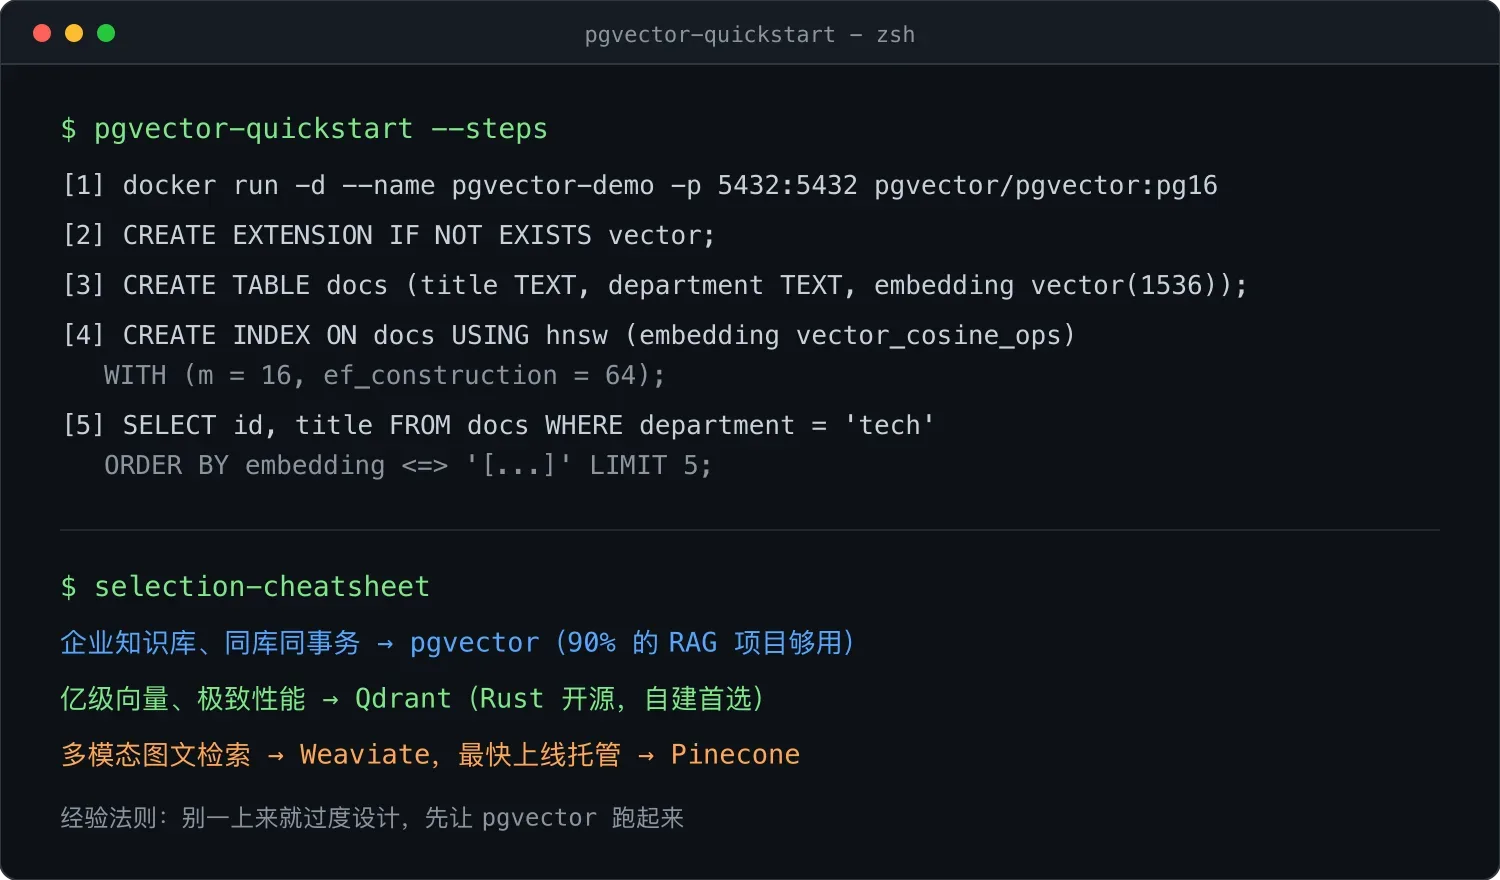
4.1 第一步:用 Docker 启动带 pgvector 的 PostgreSQL
pgvector 是 PostgreSQL 的扩展,需要一个带这个扩展的 PG 镜像。官方提供了现成镜像 pgvector/pgvector:pg16:
# 启动一个带 pgvector 的 PostgreSQL 16
docker run -d \
  --name pgvector-demo \
  -e POSTGRES_PASSWORD=mysecret \
  -e POSTGRES_DB=vectordb \
  -p 5432:5432 \
  pgvector/pgvector:pg16

# 检查是否起来了
docker ps | grep pgvector
如果你用的是云数据库(Supabase / 阿里云 RDS PG 高版本),大部分已经预装了 pgvector,跳过这步即可。
4.2 第二步:启用扩展 + 建表
进入 psql(或用任何 SQL 客户端如 DBeaver),执行:
-- 1. 启用 vector 扩展(每个数据库只需执行一次)
CREATE EXTENSION IF NOT EXISTS vector;

-- 2. 建一张表:既存业务字段,又存向量
CREATE TABLE IF NOT EXISTS docs (
    id          BIGSERIAL PRIMARY KEY,
    title       TEXT,                       -- 文档标题
    content     TEXT,                       -- 文档正文
    department  TEXT,                       -- 所属部门(用于过滤)
    embedding   vector(1536)                -- 向量列!1536 维(text-embedding-3-small)
);

-- 3. 创建 HNSW 索引(用余弦距离)
CREATE INDEX IF NOT EXISTS idx_docs_embedding
ON docs USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);关键点解读:
vector(1536):声明这一列存 1536 维向量。维度必须和你用的 embedding 模型对齐(OpenAItext-embedding-3-small是 1536,text-embedding-3-large是 3072)。vector_cosine_ops:告诉索引"我用余弦距离建图"。如果用欧氏距离,改成vector_l2_ops;点积改成vector_ip_ops。m = 16:HNSW 每个节点的最大连接数。越大召回越高,但更吃内存、构建更慢。ef_construction = 64:建索引时的搜索宽度。越大索引质量越好,但构建越慢。
4.3 第三步:插入数据
向量通常在 Python 里算好再传进来。先看一段纯 SQL 的插入(手写向量做演示):
-- 插入两条带向量的记录(这里用 3 维向量简化演示,真实是 1536 维)
INSERT INTO docs (title, content, department, embedding)
VALUES (
    'RAG 入门',
    'RAG 是检索增强生成……',
    'tech',
    '[0.1, 0.2, 0.3]'
);
4.4 第四步:相似度检索(核心)
pgvector 提供三个距离操作符,必须记住:
| 操作符 | 含义 | 越小越像? |
|---|---|---|
<=> | 余弦距离(Cosine Distance) | 是(0 表示完全一样) |
<-> | 欧氏距离(L2 Distance) | 是 |
<#> | 负内积(Negative Inner Product) | 是 |
注意:pgvector 算的是距离(distance),不是相似度(similarity)。距离越小越像,所以 ORDER BY embedding <=> $1(升序)排在前面的就是最像的。
-- 找和给定向量最像的 5 条记录,按相似度升序
SELECT id, title, department,
       1 - (embedding <=> '[0.1, 0.2, 0.3]') AS similarity
FROM docs
WHERE department = 'tech'                   -- 先按业务字段过滤
ORDER BY embedding <=> '[0.1, 0.2, 0.3]'    -- 再按向量距离排序
LIMIT 5;
这段 SQL 有三个细节:
WHERE department = 'tech'放在ORDER BY前面,这是 pgvector 的过滤检索,先按业务字段筛,再在结果里做向量排序(PG 优化器会智能处理)。ORDER BY embedding <=> $1,按余弦距离升序,最像的排第一。1 - (embedding <=> $1)把"距离"转成"相似度百分比",方便给人看(0.95 表示 95% 像)。
4.5 第五步:用 Python 完整操作(推荐工程做法)
真实项目里你不会手写 SQL 向量,而是用 Python 算 embedding + psycopg 操作数据库。完整可跑代码:
# pgvector_demo.py: pgvector 完整 CRUD + 相似度检索
import os
import psycopg
from psycopg.rows import dict_row_factory
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

# ---------- 1. 初始化客户端 ----------
oai = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))   # 国内可换 base_url
DB_DSN = os.getenv("PG_DSN", "postgresql://postgres:mysecret@localhost:5432/vectordb")


def get_embedding(text: str) -> list[float]:
    """把文字转向量(1536 维)"""
    resp = oai.embeddings.create(
        model="text-embedding-3-small",
        input=text,
    )
    return resp.data[0].embedding


# ---------- 2. 建表(带 HNSW 索引)----------
SCHEMA_SQL = """
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE IF NOT EXISTS docs (
    id          BIGSERIAL PRIMARY KEY,
    title       TEXT,
    content     TEXT,
    department  TEXT,
    embedding   vector(1536)
);

CREATE INDEX IF NOT EXISTS idx_docs_embedding
ON docs USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
"""


def init_db():
    with psycopg.connect(DB_DSN) as conn:
        with conn.cursor() as cur:
            cur.execute(SCHEMA_SQL)
        conn.commit()
    print("[OK] 表和索引已就绪")


# ---------- 3. 插入(带向量)----------
INSERT_SQL = """
INSERT INTO docs (title, content, department, embedding)
VALUES (%s, %s, %s, %s)
RETURNING id;
"""


def insert_doc(title: str, content: str, department: str):
    vec = get_embedding(content)         # 先算 embedding
    with psycopg.connect(DB_DSN) as conn:
        with conn.cursor() as cur:
            # 注意:向量要转成字符串 '[0.1,0.2,...]' 传给 PG
            cur.execute(INSERT_SQL, (title, content, department, str(vec)))
            doc_id = cur.fetchone()[0]
        conn.commit()
    print(f"[OK] 插入成功 id={doc_id} title={title}")
    return doc_id


# ---------- 4. 相似度检索 ----------
SEARCH_SQL = """
SELECT id, title, department,
       1 - (embedding <=> %s::vector) AS similarity
FROM docs
WHERE department = %s
ORDER BY embedding <=> %s::vector
LIMIT %s;
"""


def search(query: str, department: str, top_k: int = 5):
    qvec = get_embedding(query)
    vec_str = str(qvec)
    with psycopg.connect(DB_DSN, row_factory=dict_row_factory) as conn:
        with conn.cursor() as cur:
            cur.execute(SEARCH_SQL, (vec_str, department, vec_str, top_k))
            return cur.fetchall()


# ---------- 5. 主流程 ----------
if __name__ == "__main__":
    init_db()

    # 插入几条文档(演示)
    insert_doc("RAG 入门", "RAG 是检索增强生成,先检索再生成。", "tech")
    insert_doc("向量检索", "向量数据库做相似度检索,找最像的。", "tech")
    insert_doc("公司放假通知", "国庆放假 7 天,10 月 1 日至 7 日。", "hr")

    # 检索:"怎么找相似的文字" → 应该命中前两条 tech 文档
    results = search("如何让模型先查资料再回答", department="tech", top_k=2)
    print("\n检索结果:")
    for r in results:
print(f" [{r['similarity']:.3f}] {r['title']} (id={r['id']})")踩坑提示:
- 向量传给 pgvector 时要转成字符串
[0.1,0.2,...],不能直接传 Python list(除非用pgvector的 Python 包,见下)。 1 - (embedding <=> %s)把距离转成相似度,前端展示更直观。- 国内不用 OpenAI 的话,把
oai = OpenAI(...)换成通义/DeepSeek 的 base_url,模型名换对应 embedding 模型即可。
4.6 进阶:用 pgvector 官方 Python 包简化代码
官方提供了 pgvector 包,封装了向量类型,省去手动 str():
pip install pgvector psycopg# 用 pgvector 包,向量可直接传 list,无需 str()
from pgvector.psycopg import register_vector
import psycopg
conn = psycopg.connect(DB_DSN)
register_vector(conn) # 注册 vector 类型适配器
# 现在可以直接传 list,PG 自动识别
cur = conn.cursor()
cur.execute(
"INSERT INTO docs (title, embedding) VALUES (%s, %s)",
("test", [0.1, 0.2, 0.3]) # ← 直接传 list
)4.7 pgvector 小结
- 优势:和业务数据同库、事务一致、SQL 友好、生态成熟。
- 局限:亿级以上向量时,性能比专用向量库(Qdrant)差;HNSW 索引构建慢、吃内存。
- 适用:百万到千万级向量、企业内部知识库、需要和业务表 JOIN 的场景。
五、Qdrant 实战
当数据量上亿、或需要极致性能和精细过滤时,专用向量库更合适。Qdrant 是其中的开源之光。
5.1 第一步:Docker 启动 Qdrant
docker run -d \
  --name qdrant \
  -p 6333:6333 \
  -p 6334:6334 \
  -v $(pwd)/qdrant_data:/qdrant/storage \
  qdrant/qdrant
启动后浏览器打开 http://localhost:6333/dashboard,能看到 Qdrant 自带的漂亮 UI。
5.2 核心概念:Collection / Point / Payload
Qdrant 的数据模型比 SQL 简单,三个概念记住就行:
- Collection(集合):相当于一张"表"。建表时要指定向量维度和距离度量。
- Point(点):相当于一行记录。每个 point 有个
id+ 一个vector+ 一个payload(JSON 元数据,类似业务字段)。 - Payload(负载):附在 point 上的 JSON,比如
{"department": "tech", "title": "..."},用于过滤。
5.3 第二步:Python 完整操作
pip install qdrant-client openai python-dotenv# qdrant_demo.py: Qdrant 完整 CRUD + 相似度检索
import os
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct, Filter, FieldCondition, MatchValue
from openai import OpenAI
from dotenv import load_dotenv
load_dotenv()
oai = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
COLLECTION = "docs"
DIM = 1536 # text-embedding-3-small 维度
# ---------- 1. 连接 + 建 collection ----------
client = QdrantClient(url="http://localhost:6333")
# 如果不存在就建(已存在会跳过)
if COLLECTION not in [c.name for c in client.get_collections().collections]:
client.create_collection(
collection_name=COLLECTION,
vectors_config=VectorParams(size=DIM, distance=Distance.COSINE),
)
print(f"[OK] 已创建 collection: {COLLECTION}")
# ---------- 2. 工具:算 embedding ----------
def get_embedding(text: str) -> list[float]:
resp = oai.embeddings.create(model="text-embedding-3-small", input=text)
return resp.data[0].embedding
# ---------- 3. 插入(upsert)----------
def upsert_docs():
points = [
PointStruct(
id=1,
vector=get_embedding("RAG 是检索增强生成,先检索再生成。"),
payload={"title": "RAG 入门", "department": "tech"},
),
PointStruct(
id=2,
vector=get_embedding("向量数据库做相似度检索。"),
payload={"title": "向量检索", "department": "tech"},
),
PointStruct(
id=3,
vector=get_embedding("国庆放假 7 天。"),
payload={"title": "放假通知", "department": "hr"},
),
]
client.upsert(collection_name=COLLECTION, points=points)
print(f"[OK] 已插入 {len(points)} 条 point")
# ---------- 4. 相似度检索(带过滤)----------
def search(query: str, department: str, top_k: int = 5):
results = client.search(
collection_name=COLLECTION,
query_vector=get_embedding(query),
query_filter=Filter(
must=[FieldCondition(key="department", match=MatchValue(value=department))]
),
limit=top_k,
)
return results
# ---------- 5. 主流程 ----------
if __name__ == "__main__":
upsert_docs()
print("\n检索:'怎么找相似的文字'")
for r in search("如何让模型先查资料再回答", department="tech", top_k=2):
print(f" [{r.score:.3f}] {r.payload['title']} (id={r.id})")对比 pgvector 你会发现:
- Qdrant 的过滤检索写在
query_filter参数里,更声明式;pgvector 写在 SQLWHERE子句里,更熟悉。 - Qdrant 的
payload就是元数据,不用单独建列;pgvector 要在表里加字段。 - Qdrant 的
upsert天然幂等(同 id 覆盖);pgvector 要写INSERT ... ON CONFLICT DO UPDATE。 - Qdrant 的
score直接是相似度(0~1,越大越像);pgvector 是距离(要1 - dist转一下)。
5.4 Qdrant 小结
- 优势:性能强(Rust 写)、过滤优雅、Dashboard 直观、文档好。
- 局限:和业务数据分离(要维护两份数据一致性)、学习曲线比 pgvector 陡一点。
- 适用:亿级向量、高性能要求、纯检索场景(不需要和业务表 JOIN)。
六、选型决策树
到底该用哪个?下面这棵树帮你一锤定音:
- 数据敏感(金融/医疗/政企内部)→ 自建
- 业务数据和向量要强一致(同事务)→ pgvector
- 纯向量检索、追求性能 → Qdrant 自建
- 数据不敏感(公开内容、C 端产品)→ 可托管
- 想最快上线、不想运维 → Pinecone
- 想省钱但要省心 → Qdrant Cloud 或 Weaviate Cloud
- 个人项目 / 学习 / Demo
- 已经会 PostgreSQL → pgvector(顺带复习 SQL)
- 想体验纯向量库 → Qdrant(本地 Docker 一行起)
- 多模态(图+文+音混合检索)→ Weaviate
- 海量数据(10 亿级向量)→ Qdrant 集群 / Milvus(本文没讲 Milvus,但超大规模时它是另一个主流选项)
经验法则:90% 的企业 RAG 项目,pgvector 足够。只有当向量量上亿、或性能瓶颈出现,才需要迁到 Qdrant 这类专用库。别一上来就过度设计。
七、性能优化
向量库上量后(百万级以上),性能就是命根子。下面 4 个优化点你必知:
7.1 HNSW 参数调优
| 参数 | 含义 | 典型值 | 调大的影响 |
|---|---|---|---|
m | 每个节点最大连接数 | 16 | 召回提高、内存上涨、构建变慢 |
ef_construction | 建索引时搜索宽度 | 64~256 | 索引质量提高、构建变慢 |
ef_search(pgvector) | 查询时搜索宽度 | 默认 40 | 召回提高、查询变慢 |
pgvector 调查询召回:
-- 临时调高查询时的搜索宽度(值越大越准但越慢)
SET hnsw.ef_search = 100;

-- 然后再查
SELECT id, title FROM docs ORDER BY embedding <=> '[...]' LIMIT 5;调参经验:先 m=16, ef_construction=64 起步,召回不够再往上调,不要一上来就 m=48(构建时间爆炸)。
7.2 过滤检索的正确姿势
错误做法:先 SELECT 所有向量到内存再 Python 过滤,数据量大就 OOM。
正确做法(pgvector):把过滤条件写进 SQL,让 PG 优化器处理:
SELECT id, title
FROM docs
WHERE department = 'tech'           -- 过滤在 ORDER BY 之前
  AND created_at > '2025-01-01'
ORDER BY embedding <=> $1
LIMIT 5;
正确做法(Qdrant):用 query_filter,Qdrant 内部会做"先过滤再搜"或"边搜边过滤"的优化:
client.search(
    collection_name="docs",
    query_vector=qvec,
    query_filter=Filter(must=[
        FieldCondition(key="department", match=MatchValue(value="tech")),
    ]),
    limit=5,
)
7.3 批量化插入
千万别一条一条 INSERT,百万条插到天荒地老。要批量插入:
pgvector(用 execute_values):
from psycopg import sql
import psycopg

rows = [("doc1", [0.1, 0.2]), ("doc2", [0.3, 0.4])]  # 你的批量数据

with psycopg.connect(DB_DSN) as conn:
    with conn.cursor() as cur:
        # 一次性插多行
        args = b",".join(
            cur.mogrify("(%s, %s)", (title, str(vec)))
            for title, vec in rows
        )
        cur.execute(b"INSERT INTO docs (title, embedding) VALUES " + args)
conn.commit()Qdrant(upsert 直接传 list):
# Qdrant 的 upsert 本身就支持批量
points = [PointStruct(id=i, vector=vecs[i], payload={"i": i}) for i in range(1000)]
client.upsert(collection_name="docs", points=points) # 一把插入 1000 条经验:每批 500~5000 条,太大会撑爆内存/网络包,太小体现不出批量优势。
7.4 分片(Sharding)
数据上亿后,单机扛不住,要分片:
- pgvector:用 PostgreSQL 自带的分区表(按
idhash 或按时间范围),或上 Citus 分布式扩展。 - Qdrant:原生支持分布式集群,多个节点自动分片+副本,配置几个
--uri就能组集群。
分片是后期才考虑的事,别在数据量百万级时就纠结分片,单机绰绰有余。
八、本文小结
- 向量数据库 ≠ 关系型数据库:前者回答"有多像"(相似度检索),后者回答"有没有"(精确匹配)。前者用 HNSW/IVF 索引,后者用 B-Tree。
- 三个核心概念:向量(embedding,语义坐标)、相似度度量(余弦/欧氏/点积,文本 RAG 用余弦)、ANN 索引(HNSW 主流,牺牲一点准确率换几万倍速度)。
- 四大库横评:pgvector(同库同事务,企业首选)、Pinecone(托管省心但贵且数据出境)、Qdrant(开源 Rust 高性能,自建首选)、Weaviate(多模态强)。
- pgvector 必会:
CREATE EXTENSION vector→vector(1536)列 → HNSW 索引vector_cosine_ops→<=>余弦距离操作符。 - Qdrant 推荐:Docker 一行起 →
create_collection→upsert(PointStruct)→search(query_filter=...)。 - 选型决策:90% 企业 RAG 用 pgvector 足够;亿级或极致性能用 Qdrant;多模态用 Weaviate;想最快上线用 Pinecone。
- 性能优化四板斧:HNSW 参数(m / ef_construction / ef_search)、过滤检索(让 DB 优化器处理)、批量插入(每批 500~5000)、分片(亿级才考虑)。
九、动手练习
练习 1(基础):用 Docker 启动 pgvector,跑通本文的 pgvector_demo.py。把你最喜欢的 5 本书简介做成向量存进去,然后检索"和《三体》风格类似的书",看结果是否合理。
练习 2(进阶):在 pgvector 里建一张 products 表(id / name / category / price / embedding),插入 20 条虚构商品。写一个 SQL:先按 category='electronics' 过滤,再按向量找最像的 3 个商品。体会"过滤 + 向量排序"的组合。
练习 3(挑战):把同样的 100 条文档同时存进 pgvector 和 Qdrant,写脚本对比两者的检索结果(top-5 重合率)和查询耗时(用 time.perf_counter())。观察:召回率一致吗?谁更快?体会两个库的差异。这是工程上选型前的标准评估动作。
十、延伸阅读
- pgvector 官方仓库(含完整 SQL 参考):https://github.com/pgvector/pgvector
- pgvector HNSW 调参指南:https://github.com/pgvector/pgvector#hnsw
- Qdrant 官方文档:https://qdrant.tech/documentation/
- Qdrant Python Client:https://github.com/qdrant/qdrant-client
- Pinecone 官方文档:https://docs.pinecone.io/
- Weaviate 官方文档:https://weaviate.io/developers/weaviate
- HNSW 原始论文(Malkov & Yashunin):https://arxiv.org/abs/1603.09320
- ANN-Benchmarks(向量库性能横评,看真实跑分):https://ann-benchmarks.com/
- 概念参考:可以把 HNSW 类比为"高德地图的层级缩放":缩小看大区(上层稀疏图),放大看街道(下层密集图),逐层精化定位目标。
写在最后:到这里,RAG 的"仓库"已经搭好了,但还有一个关键问题没有解决:仓库里那些向量从哪儿来?答案藏在 embedding 模型与文档处理流水线里:怎么选 embedding 模型(OpenAI / 通义 / BGE / 本地模型的取舍)、文档怎么切片(chunk)才不丢语义、切片大小和重叠窗口怎么权衡、多语言与中文场景的特殊处理。RAG 的检索质量有 80% 取决于 embedding 和切片,存储层搭好之后,值得在这两件事上继续深挖。