字节笔记本
2026年10月6日 · 约 48 分钟读完
AI 工作流专栏 12:RAG 检索增强生成原理拆解
本文是《从零成为 AI 工作流工程师》系列第 12 篇,主题是 RAG(Retrieval-Augmented Generation,检索增强生成):为什么需要它、五大环节怎么跑、以及怎么用 30 行代码写出一个最小可用的实现。
你已经会写 Prompt、会调 API、会让模型流式输出、调函数、吐 JSON。但只要真做过一个企业级 Demo,就会立刻撞上一堵墙:大模型压根不知道你公司的私有数据。你问它"我们公司的退款政策是什么",它一本正经地编;你问它"上季度销售报表里华东区的数字",它两眼一抹黑;你问它"内部 OA 系统怎么提请假",它给你瞎指路。这就是企业落地 AI 的头号拦路虎,而解决它的答案,占了招聘 JD 里 AI 工程师要求的一半篇幅。
本篇用一个"退款政策问答"的小例子,把 RAG 的五大环节彻底拆透,并讲清为什么 RAG 能减少幻觉、它有哪几个流派、有哪些高级优化技巧、什么场景该用 RAG 什么时候该微调:
- RAG 要解决的三大痛点:幻觉、知识过时、私有数据
- 一个让你秒懂 RAG 的类比:闭卷考试 vs 开卷考试
- RAG 五大环节逐个拆解:解析、切片、向量化、检索、生成
- 手写一个最小可用 RAG(纯
openai + numpy,不用任何框架),本篇精华 - RAG 的三大流派:Naive RAG / Advanced RAG / Modular RAG
- RAG 高级优化四件套:查询改写、混合检索(BM25+向量)、Rerank 重排、HyDE
- RAG 常见坑:召回率低、chunk 切不好、表格图片丢失、长文本"中间遗忘"
- RAG vs 微调:什么场景该用哪个,什么时候两者结合
一、RAG 到底要解决什么问题
1.1 生活类比:闭卷考试 vs 开卷考试
想象你是一场考试的考生。
闭卷考试:只许带脑子进考场。你背了多少就答多少,背错了就编一个看起来合理的答案(哪怕根本没这个知识点)。监考老师一翻书,好家伙,全错。
开卷考试:可以带教材、笔记进考场。题目一来,你先翻书找到对应章节,然后照着书上的内容组织答案。答得对不对,取决于你翻书的速度和找得准不准,但至少不会"凭空编造"。
- 闭卷考试 = 原始大模型:只靠训练时记住的知识,记不准就幻觉(一本正经地胡说八道)
- 开卷考试 = RAG:先从你的资料库里检索出相关段落,再让模型照着检索结果生成答案
一句话定义 RAG:在大模型回答问题之前,先从外部知识库里"翻书"找到相关资料,拼进 Prompt,让模型"开卷答题"。
这就是 RAG 的全部精髓。它把模型的角色从"知识仓库"变成了"阅读理解高手":你不用把所有知识塞进它脑子(也不可能),只要把当下需要的资料临时递给它就行。
1.2 RAG 要解决的三大痛点
光知道"开卷"还不够,你得知道为什么非开卷不可。这背后是大模型的三个死穴:
痛点一:幻觉(Hallucination)
大模型本质上是个"概率接龙机器":它只管"接得通顺",不管"是不是真的"。你问它"林黛玉倒拔垂杨柳的故事",它能给你编得有鼻子有眼,因为这五个字连在一起看起来很像那么回事。在企业场景里,模型编一个错误的退款金额、编一个不存在的 API、编一段假的法律条款,代价可能是真金白银甚至法律风险。
RAG 怎么治幻觉?把真实资料塞进上下文,并告诉它"只能根据下面这些资料回答"。模型有了"标准答案在手",自然不会瞎编,就像开卷考试时,你不会放着书上的正确答案不抄、而去自己编一个。
痛点二:知识过时
大模型的训练数据有个截止日期,这之后发生的所有事,新政策、新产品、新同事、新 bug,它统统不知道。你问它"今年公司年会在哪办",它只能猜。你总不能每出一条新消息,就重新训练一个几百亿参数的模型吧?那成本是天文数字。
RAG 怎么治过时?外部知识库随时更新。今天出了新政策,往库里塞一条新文档,下次提问立刻能查到,零训练成本,秒级生效。
痛点三:私有数据
这是企业落地最核心的痛点。大模型训练时没看过你公司的任何文档:产品手册、内部 wiki、历史工单、客户合同、销售记录,它一个字都不知道。你想让它回答"我们公司的退款政策",它要么装作不知道,要么就编。
RAG 怎么治私有数据盲区?把私有文档切片存进向量库,提问时检索出来喂给模型。模型本身不用知道你的私有数据,它只需要会"读资料回答问题"。
| 痛点 | 不用 RAG | 用了 RAG |
|---|---|---|
| 幻觉 | 凭记忆编造 | 基于检索结果作答,可溯源 |
| 知识过时 | 等模型厂商重新训练 | 更新知识库,秒级生效 |
| 私有数据 | 完全不知道 | 检索私有文档后回答 |
要点:RAG 不是让模型"更聪明",而是给模型"递资料"。它解决的核心问题是把外部、最新、私有知识,低成本地注入到生成阶段,同时通过"基于资料作答"显著降低幻觉。
二、RAG 五大环节:先把流水线装进脑子
2.1 流水线全景
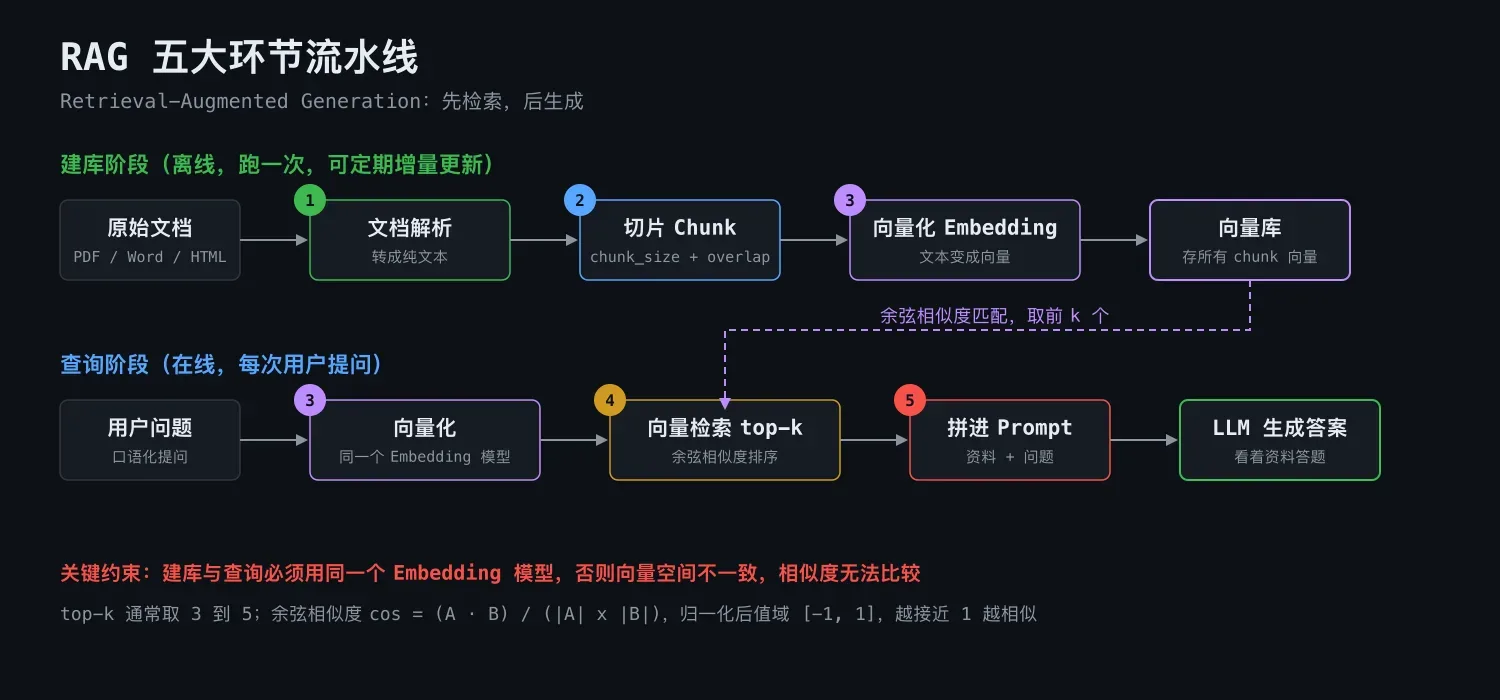
RAG 看似神秘,拆开就五步。其中前三步是"建库阶段"(离线做一次),后两步是"查询阶段"(每次提问在线做):
【建库阶段:一次性,可定期增量更新】
原始文档 → ① 文档解析 → ② 切片 → ③ 向量化(Embedding)→ 存进向量库

【查询阶段:每次用户提问】
用户问题 → ③ 向量化 → ④ 向量检索(找 top-k 相关片段)→ ⑤ 拼进 Prompt → LLM 生成答案
注意第③步"向量化"出现了两次:建库时把文档向量化,查询时把问题向量化。两者必须用同一个 Embedding 模型,否则算出来的向量"语言不通",没法比相似度。
下面五节,逐个环节放大看。
2.2 环节①:文档解析(Parsing)
生活类比:你拿到一本精装画册,想把里面的文字誊抄到笔记本上。但画册里有图、有表、有花式排版,你不可能"原样抄",得把图和表也描述成文字,再把多栏排版理成顺序文字。
文档解析就是这一步:把 PDF / Word / HTML / PPT / 扫描件 这些"人看着舒服、机器读着费劲"的格式,转成纯文本(或带简单结构的 Markdown)。
常见难点:
- PDF 排版:双栏论文、文字环绕图片,提取后顺序可能错乱(用 PyMuPDF / pdfplumber)
- 扫描件 PDF:本质是图片,需要 OCR(用 Tesseract / PaddleOCR)
- 表格:PDF 里的表格提取后往往变成乱序文本(用 Camelot / pdfplumber 的 table 模式)
- 图片图表:纯文本提取会丢,需要多模态模型(GPT-4V / Qwen-VL)转写成文字描述
最小示例:
# parse_pdf.py:用 PyMuPDF 把 PDF 转成纯文本
import fitz  # pip install pymupdf

def pdf_to_text(pdf_path: str) -> str:
    """读取 PDF 全文,返回纯文本"""
    doc = fitz.open(pdf_path)
    pages = [page.get_text("text") for page in doc]
    doc.close()
    return "\n\n".join(pages)

text = pdf_to_text("refund_policy.pdf")
print(text[:500]) # 打印前 500 字看看解析效果工程提醒:文档解析是 RAG 里最容易被低估的环节。很多团队死磕 Embedding 模型,结果发现召回率低,最后定位到是解析阶段就丢了一半信息(表格变乱码、图片丢失)。
2.3 环节②:文档切片(Chunking)
生活类比:你把一本 500 页的菜谱喂给 AI,问"红烧肉怎么做"。你没必要把 500 页全塞给它(塞不下,也贵),只需要精准找到"红烧肉"那两页递给它就行。
但你不能按"页"切,因为一本书里"红烧肉"可能分散在第 12 页、第 200 页。你需要把整本书切成小块(chunk),每块大概几百字,然后只挑最相关的几块。
切片策略常见的几种:
| 策略 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 固定字符切 | 每 500 字符切一刀 | 实现最简单 | 可能把句子从中间切断 |
| 按段落切 | 以换行为分隔 | 语义相对完整 | 段落长短不一,难控制 |
| 递归切(Recursive) | 先按段落,段落太长再按句子,句子太长再按字符 | 语义和长度兼顾 | 实现稍复杂 |
| 重叠切(Overlap) | 任意相邻两块有 50~100 字重叠 | 防止边界信息丢失 | 总块数变多,成本略增 |
两个最关键的参数:
- chunk_size:每块多大。常见 300~800 字符(中文)或 200~500 token。太小则信息碎片化,检索不准;太大则单块塞太多无关内容,稀释相关性,还浪费 token。
- overlap:相邻块重叠多少。一般取 chunk_size 的 10%~20%,作用是防止"关键句正好被切成两半"。
最小切片代码(递归 + 重叠):
# chunking.py:递归字符切片(模仿 LangChain 的 RecursiveCharacterTextSplitter)
def split_text(text: str, chunk_size: int = 500, overlap: int = 50,
               separators: list[str] = None) -> list[str]:
    """
    递归切片:依次尝试 separators 里的分隔符,切到 chunk_size 以内。
    相邻 chunk 之间保留 overlap 个字符的重叠。
    """
    if separators is None:
        separators = ["\n\n", "\n", "。", "!", "?", ".", "!", "?", " ", ""]

    def _split(text: str, seps: list[str]) -> list[str]:
        # 用第一个能切开文本的分隔符
        sep = seps[0]
        if sep:
            pieces = text.split(sep)
        else:
            pieces = list(text)  # 退化为按字符
        # 如果第一刀切完后还有比 chunk_size 长的,用下一个分隔符继续切
        if any(len(p) > chunk_size for p in pieces) and len(seps) > 1:
            refined = []
            for p in pieces:
                if len(p) > chunk_size:
                    refined.extend(_split(p, seps[1:]))
                else:
                    refined.append(p)
            pieces = refined
        # 重新用当前分隔符拼回去,拼到接近 chunk_size
        chunks, cur = [], ""
        for p in pieces:
            piece = p if sep == "" else p + sep
            if len(cur) + len(piece) <= chunk_size:
                cur += piece
            else:
                if cur:
                    chunks.append(cur)
                cur = piece
        if cur:
            chunks.append(cur)
        return chunks

    raw_chunks = _split(text, separators)
    # 加 overlap:每块尾部切 overlap 字符给下一块当头部
    if overlap <= 0 or len(raw_chunks) <= 1:
        return raw_chunks
    final = [raw_chunks[0]]
    for i in range(1, len(raw_chunks)):
        prev_tail = raw_chunks[i - 1][-overlap:]
        final.append(prev_tail + raw_chunks[i])
    return final

chunks = split_text(open("policy.txt", encoding="utf-8").read(),
                    chunk_size=500, overlap=50)
print(f"共切成 {len(chunks)} 块,第一块预览:\n{chunks[0][:200]}")
2.4 环节③:向量化(Embedding)
切片之后,每块是一段文字。但文字和文字怎么算"相似"? 计算机不认识字,它只认识数字。所以要把每段文字变成一串数字,向量(Embedding)。
生活类比:给每个 chunk 发一张"身份证",身份证上不是照片,而是一串数字坐标。语义相近的 chunk,坐标也相近;语义无关的 chunk,坐标离得老远。这串坐标通常是 1024 维或 1536 维,每一维都代表某种"语义方向"(比如某一维可能代表"是否和金钱有关",另一维代表"是否和退款有关",但这些维度都是模型自动学的,人类没法直接解读)。
调用 Embedding 模型很简单:
# embedding.py:用 OpenAI text-embedding-3-small 把文本变成向量
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

def embed(text: str, model: str = "text-embedding-3-small") -> list[float]:
    """把一段文本变成一个 1536 维向量"""
    resp = client.embeddings.create(input=text, model=model)
    return resp.data[0].embedding

vec = embed("用户申请 7 天内退款")
print(f"向量维度:{len(vec)},前 5 维:{vec[:5]}")
几个要点:
- 模型选型:OpenAI
text-embedding-3-small(1536 维,便宜)或3-large(3072 维,更准);中文场景常用开源的 BGE(智源 BAAI 出品,免费、可本地部署)、m3e-base。 - 同库必须同模型:建库和查询用同一个 Embedding 模型,否则向量空间不一致。
- 维度越高不一定越准,但一定更贵更慢,生产环境
3-small/bge-large-zh已经够用。
Embedding 模型怎么来的? 和 LLM 一样,也是神经网络训练出来的,只不过训练目标是"让相似语义的句子向量靠近、无关语义的远离"。
2.5 环节④:向量检索(Retrieval)
有了向量库,怎么找最相关的几块?算相似度。
最常用的是余弦相似度(Cosine Similarity),算两个向量的"夹角"。夹角越小(方向越一致),相似度越高,最大为 1。
生活类比:把每个向量想象成一根从原点射出去的箭头。两根箭头方向几乎一致(夹角接近 0°),说明它们语义高度相似;互相垂直(90°),说明八竿子打不着;方向相反(180°),说明语义对立。
公式(不用背,知道意思就行):
cos(θ) = (A · B) / (||A|| × ||B||)
A·B 是两个向量的点积,分母是两个向量长度的乘积。归一化后,结果落在 [-1, 1]。
检索过程:把用户问题的向量和库里所有 chunk 向量逐一算余弦相似度,按分数从高到低排序,取前 k 个(叫 top-k,通常 k=3~5)。这就是"召回"。
代码(纯 numpy,不用框架):
# retrieval.py:纯 numpy 算余弦相似度 + top-k
import numpy as np

def cosine_sim(a: list[float], b: list[float]) -> float:
    """两个向量的余弦相似度"""
    a, b = np.array(a), np.array(b)
    return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b) + 1e-8))

def search_topk(query_vec: list[float], doc_vecs: list[list[float]],
                chunks: list[str], k: int = 3) -> list[tuple[str, float]]:
    """对查询向量,从文档向量库里检索 top-k 最相关 chunk"""
    scores = [cosine_sim(query_vec, dv) for dv in doc_vecs]
    # 按分数降序,取前 k
    top_idx = np.argsort(scores)[::-1][:k]
    return [(chunks[i], scores[i]) for i in top_idx]
2.6 环节⑤:生成(Generation)
最后一步:把检索到的 top-k chunk 拼进 Prompt,交给 LLM 生成答案。Prompt 的标准模板长这样:
你是一个严谨的客服助手。请只根据下面提供的【参考资料】回答用户问题。
如果参考资料里没有相关内容,请直接回答"我没有找到相关资料",不要编造。

【参考资料】
{chunk_1}
{chunk_2}
{chunk_3}

【用户问题】
{user_question}

【你的回答】
关键设计点:
- 强调"只能根据资料回答",这是降低幻觉的"咒语",明确告诉模型不准编。
- "找不到就说找不到",给模型一个体面的退路,避免它为了"显得有用"而硬编。
- 要求引用来源(进阶),让模型回答时标注"[来自资料 2]",方便溯源。
到这一步,你已经把 RAG 五大环节全部走完了。下面把它们串成一段真正能跑的最小 RAG 代码,这是本篇精华。
三、精华:手写一个最小可用 RAG
不用 LangChain、不用 LlamaIndex,只用 openai + numpy。这个例子用一个"退款政策"小文档,让你看到 RAG 的本质就是这五步,没有任何魔法。
# mini_rag.py:30 行看懂 RAG 本质
# pip install openai numpy python-dotenv
import os, numpy as np
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
EMBED_MODEL = "text-embedding-3-small"
CHAT_MODEL = "gpt-4o-mini"

# ===== 知识库(实际场景是从文档解析来的,这里简化为几段文本)=====
DOCS = [
    "我们的退款政策:所有实物商品,自签收之日起 7 天内可以申请无理由退款,商品需保持原包装。",
    "数字商品(如会员、课程)一经购买,不支持退款,但可以在购买后 24 小时内申请换货。",
    "退款到账时间:原路退回,支付宝/微信 1-3 个工作日,银行卡 3-7 个工作日。",
    "如果商品有质量问题,30 天内可以申请退货退款,运费由我们承担。",
    "联系客服:工作时间 9:00-22:00,电话 400-123-4567,邮箱 support@example.com。",
]

# ===== 建库阶段 =====
def embed(text: str) -> list[float]:
    r = client.embeddings.create(input=text, model=EMBED_MODEL)
    return r.data[0].embedding

doc_vectors = [embed(d) for d in DOCS]   # 解析省略,每个 DOCS 就是一个 chunk,向量化后入库

# ===== 查询阶段 =====
def rag_answer(question: str, k: int = 2) -> str:
    # 检索:把问题向量化,算余弦相似度,取 top-k
    qv = embed(question)
    scores = np.array([np.dot(qv, dv) / (np.linalg.norm(qv) * np.linalg.norm(dv) + 1e-8)
                       for dv in doc_vectors])
    top_idx = np.argsort(scores)[::-1][:k]
    context = "\n\n".join([f"[资料{i+1}] {DOCS[j]}" for i, j in enumerate(top_idx)])

    # 生成:拼进 Prompt,让 LLM 作答
    prompt = f"""你是一个严谨的客服。请只根据下面的【参考资料】回答问题。
如果资料里没有,请直接说"我没有找到相关资料",禁止编造。

【参考资料】
{context}

【问题】{question}
"""
    resp = client.chat.completions.create(
        model=CHAT_MODEL,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,   # 客服场景要稳,温度调 0
    )
    return resp.choices[0].message.content

# ===== 跑一下 =====
if __name__ == "__main__":
    print("Q1:我买的衣服能退吗?")
    print(rag_answer("我买的衣服能退吗?"))
    # → 应该引用资料1,告诉你 7 天内可退

    print("\nQ2:会员能退款吗?")
    print(rag_answer("会员能退款吗?"))
    # → 应该引用资料2,告诉你数字商品不退

    print("\nQ3:火星上能种土豆吗?")  # 知识库里没有的
    print(rag_answer("火星上能种土豆吗?"))
# → 应该回答"我没有找到相关资料",而不是瞎编跑完你会发现:
- 前两个问题模型答得又准又有据,因为它"看到了"相关资料。
- 第三个问题(知识库没有的),模型诚实地回答"没找到",而不是编一个火星种土豆的方法,这就是 RAG 抑制幻觉的威力。
这 30 行代码就是 RAG 的全部本质。 后面所有的框架(LangChain、LlamaIndex)、所有的优化(混合检索、Rerank、查询改写),都是在这五步的某一步上做增强。把它跑通,你就拿到了 RAG 的"骨架",剩下的都是"长肉"。
建议:把这段代码复制到本地,把 DOCS 换成你公司的真实 FAQ,加几个刁钻问题试试,亲手感受一下 RAG 的效果和边界,这是理解后面所有内容的地基。
四、RAG 的三大流派:从 Naive 到 Modular
RAG 经过几年演进,分成了三代。理解这个脉络,你就能看懂论文和 JD 里那些花里胡哨的术语。
4.1 Naive RAG(朴素 RAG):就是上面那 30 行
最朴素的版本:建库、检索、生成,一条线走到底。优点是简单清晰、好实现;缺点是召回质量看运气,用户问题一旦口语化、含糊、或者关键信息和文档用词不一致,检索就拉胯。
4.2 Advanced RAG(进阶 RAG):在 Naive 上加"前后处理"
针对 Naive 的弱点,在检索前和检索后各加一道工序:
- 检索前(Pre-retrieval):查询改写(把口语化问题改成检索友好的)、HyDE(先编一个假设性答案再去检索)。
- 检索后(Post-retrieval):Rerank 重排(用更准但更慢的模型对召回结果二次排序)、上下文压缩(去掉冗余)。
- 检索中:混合检索(向量 + 关键词)。
这一代是目前生产环境的主流,第五节会专门讲这四件套。
4.3 Modular RAG(模块化 RAG):把 RAG 拆成可插拔模块
第三代更进一步:RAG 不再是一条固定流水线,而是一组可编排的模块,检索器、记忆模块、路由器、融合器、判断器,根据任务动态组合。比如有的问题不需要检索(直接用模型知识答),有的需要多轮检索,有的需要先检索再调工具再检索。LangGraph、LlamaIndex Workflows 都是这一派的产物。
| 流派 | 特点 | 适用场景 |
|---|---|---|
| Naive RAG | 五步一条线,简单 | Demo、小规模 FAQ |
| Advanced RAG | 加查询改写/混合检索/Rerank | 生产环境主流 |
| Modular RAG | 模块可编排,支持多轮/路由 | 复杂企业应用、Agent |
五、RAG 高级优化四件套(区分初中级工程师的关键)
这一节是面试加分项。你简历上写"做过 RAG"和"做过 Advanced RAG,包含查询改写 + 混合检索 + Rerank",完全是两个段位。
5.1 查询改写(Query Rewriting)
痛点:用户提问往往很口语、很烂。比如:
- 用户问:"那玩意儿能不能退?","那玩意儿"指什么?检索器懵了。
- 用户问:"上周说的那个政策","上周说的"是哪条?检索器懵了。
对策:先用一个小模型,把用户的口语问题改写成检索友好的、信息完整的问题,再去检索。
# query_rewrite.py:查询改写
def rewrite_query(user_question: str, chat_history: str = "") -> str:
    prompt = f"""你是一个查询改写助手。请把用户的口语化问题,
改写成一个信息完整、适合检索的清晰问题。结合历史对话补充指代。
只输出改写后的问题,不要解释。

【历史对话】
{chat_history}

【原问题】{user_question}

【改写后】"""
    resp = client.chat.completions.create(
        model=CHAT_MODEL,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
    )
    return resp.choices[0].message.content.strip()

# "那玩意儿能不能退?" + 历史"我在看你们的会员" → "会员能不能退款?"
5.2 混合检索(Hybrid Search:向量 + BM25)
痛点:纯向量检索对专有名词、型号、编号不敏感。比如用户问"产品 SKU-XJ2024 的保修期",向量检索可能召回一堆"保修"相关的文档,但完全错过包含"XJ2024"这个精确字符串的那条,因为向量化后这种精确字符信息被"语义化"稀释了。
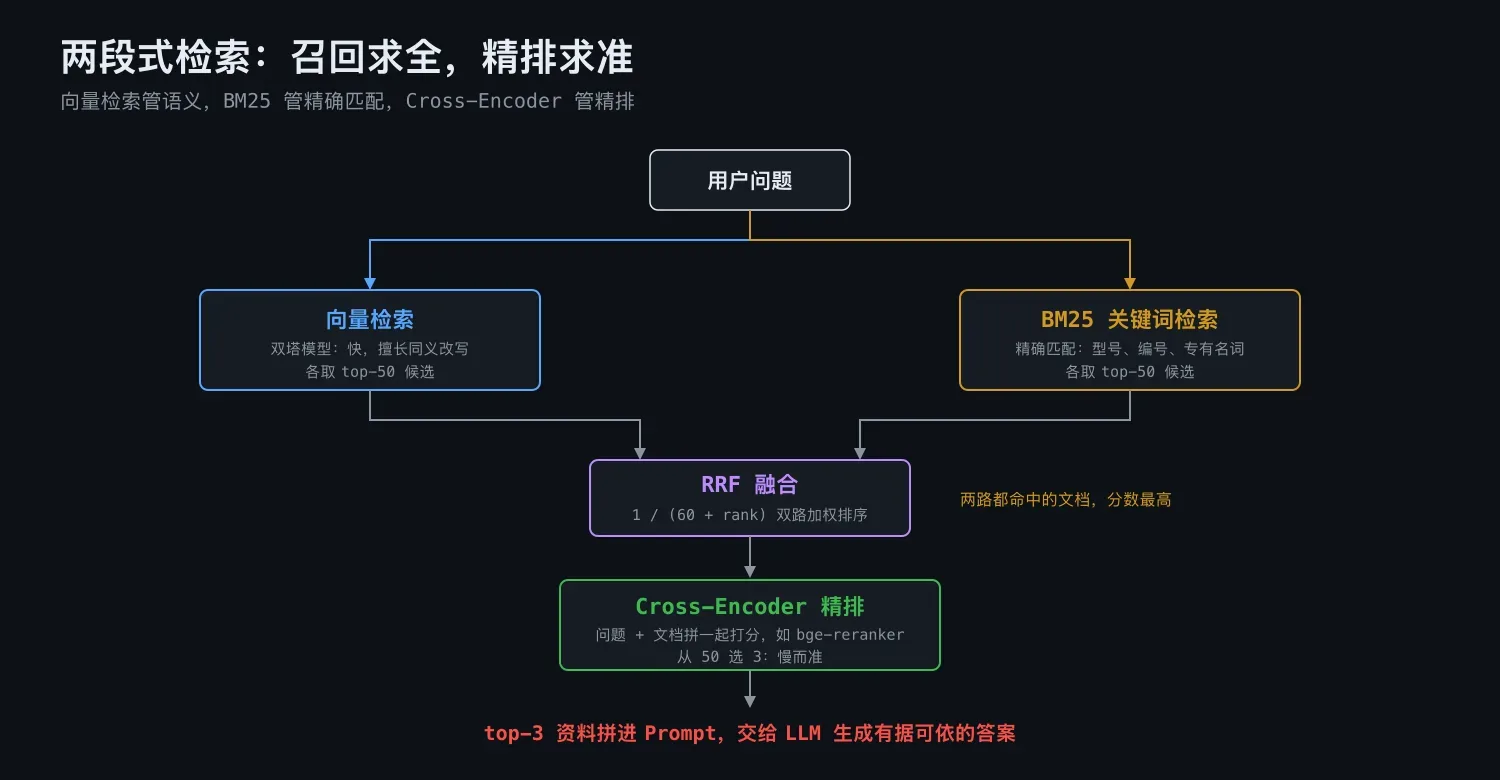
对策:向量检索 + 关键词检索(BM25)双路并行,再把两路结果融合(常用 RRF,Reciprocal Rank Fusion)。
- 向量检索:擅长语义相似("退款"对应"退货还钱")
- BM25 关键词检索:擅长精确匹配("XJ2024" 这个型号必须一模一样)
# hybrid_search.py:向量检索 + BM25 简易融合(RRF)
# pip install rank-bm25
from rank_bm25 import BM25Okapi

def hybrid_search(question: str, k: int = 5, alpha: float = 0.5):
    # 向量检索 top-k
    qv = embed(question)
    vec_scores = [cosine_sim(qv, dv) for dv in doc_vectors]
    vec_rank = np.argsort(vec_scores)[::-1][:k]

    # BM25 关键词检索 top-k
    tokenized = [list(d) for d in DOCS]   # 中文按字切,生产用 jieba 分词
    bm25 = BM25Okapi(tokenized)
    bm25_scores = bm25.get_scores(list(question))
    bm25_rank = np.argsort(bm25_scores)[::-1][:k]

    # RRF 融合:每路的排名取倒数加权,1/(60+rank)
    rrf = {}
    for rank, idx in enumerate(vec_rank):
        rrf[idx] = rrf.get(idx, 0) + alpha / (60 + rank + 1)
    for rank, idx in enumerate(bm25_rank):
        rrf[idx] = rrf.get(idx, 0) + (1 - alpha) / (60 + rank + 1)
    fused_rank = sorted(rrf, key=rrf.get, reverse=True)[:k]
    return [(DOCS[i], rrf[i]) for i in fused_rank]
5.3 重排(Rerank):召回求全,精排求准
痛点:向量检索(双塔模型)为了快,用的是"问题向量和文档向量算一次相似度",快但糙。它擅长从 10 万条里召回可能相关的 20 条(求全),但这 20 条的精细排序不准。
对策:召回后,用一个更准但更慢的 cross-encoder 模型(如 bge-reranker-base)对这 20 条逐一精排,它把"问题 + 文档"拼在一起送进模型,输出一个精确相关性分数。重新排序后取 top-3 喂给 LLM。
# rerank_demo.py:用 BGE Reranker 重排(本地推理,需 pip install FlagEmbedding)
from FlagEmbedding import FlagReranker

reranker = FlagReranker("BAAI/bge-reranker-base", use_fp16=True)

def rerank(question: str, candidates: list[str], top_n: int = 3) -> list[str]:
    """对召回的候选 chunk 用 cross-encoder 精排,取 top_n"""
    pairs = [[question, c] for c in candidates]
    scores = reranker.compute_score(pairs, normalize=True)
    if isinstance(scores, float):   # 只有一条时返回标量
        scores = [scores]
    ranked = sorted(zip(candidates, scores), key=lambda x: x[1], reverse=True)
    return [c for c, _ in ranked[:top_n]]
为什么不全用 cross-encoder? 因为它慢、贵,要对每个(问题, 文档)对做一次完整推理。所以工程上分两层:双塔召回(快,从 10 万选 50)→ cross-encoder 精排(准,从 50 选 3)。这就是"召回-精排"经典两段式,和搜索引擎、推荐系统的思路一模一样。
5.4 HyDE(Hypothetical Document Embeddings)
痛点:用户问题是疑问句("怎么退款?"),而文档是陈述句("我们的退款政策是……")。两者句式不同,向量相似度可能不高。
对策:先用 LLM 针对问题编一个"假设性答案"(哪怕编错),然后用这个假答案的向量去检索,因为假答案和真文档都是陈述句,句式更接近,向量相似度反而更高。
# hyde.py:假设性文档生成
def hyde_retrieve(question: str, k: int = 3) -> list[str]:
    # 让 LLM 编一个假答案
    prompt = f"请用 2-3 句话回答这个问题(可以不准确):{question}"
    fake_answer = client.chat.completions.create(
        model=CHAT_MODEL, messages=[{"role": "user", "content": prompt}]
    ).choices[0].message.content
    # 用假答案(而不是原问题)去检索
    fake_vec = embed(fake_answer)
return search_topk(fake_vec, doc_vectors, DOCS, k=k)这招在问句和文档句式差异大时奇效。但代价是多一次 LLM 调用,延迟和成本翻倍,按场景取舍。
六、RAG 常见坑(踩过才算入门)
讲完了"该做什么",再讲"会踩什么"。这些坑都是真实生产里反复出现的:
坑 1:召回率低,检索的根本不准
表现:检索回来的 chunk 压根不是用户问的。原因可能是:Embedding 模型太弱或不适配中文;文档用词和用户提问用词差异大("退货" vs "退货还钱")。对策:换更强 Embedding、上混合检索、加查询改写。
坑 2:chunk 切得不好
- 切太短:一个完整政策被切成两半,模型只看到一半,答不全。
- 切太长:一块塞了一堆无关内容,稀释了关键信息,模型反而抓不到重点。
- 没加 overlap:关键句正好被切断,两边都查不到。
对策:先用 chunk_size=500, overlap=50 作 baseline,再做 A/B 测试调参。chunk 策略对效果的影响,往往比换 Embedding 模型还大。
坑 3:表格和图片信息丢失
PDF 里的表格提取后常常变成乱序文字(如"姓名 年龄 张三 25"变成"姓名 张三 年龄 25",还可能更乱),导致模型答错。图片里的信息(流程图、示意图)纯文本提取直接丢失。对策:表格用专门工具(Camelot / 多模态模型),图片用 VLM 转文字描述。
坑 4:长文档的"中间遗忘"
即使检索回来了正确的 chunk,**模型对长 Prompt 也有"中间位置信息容易被忽略"**的倾向(业界叫 "Lost in the Middle")。表现:关键资料放在 Prompt 中间时,模型反而答不准;放在开头或结尾就答得好。对策:把最重要的 chunk 放在最前面(重排后按分数放);控制上下文长度,别贪多;用长上下文模型(如 GPT-4o 128k、Claude 200k)。
坑 5:评估缺失,"感觉还行"是最危险的
很多团队做完 RAG,靠人肉试几个问题"感觉答得对"就上线,结果线上翻车。RAG 必须有量化评估:准备一批"问题、标准答案、相关文档"三元组,跑召回率(Recall@k)、答案准确率(用 LLM-as-Judge 或人工)。
工程经验:RAG 的 80% 时间不在写代码,而在调 chunk、换 Embedding、加 Rerank、补评估集。框架只是脚手架,真正的功夫都在数据。
七、RAG vs 微调:到底用哪个
这是面试高频题,也是工程选型的核心决策。两者都是"给模型加知识/能力",但路线完全不同。
| 维度 | RAG | 微调(Fine-tuning) |
|---|---|---|
| 本质 | 给模型递资料(外挂知识库) | 把知识烧进模型参数(内化) |
| 知识更新 | 改库即可,秒级 | 要重新训练,小时到天级 |
| 成本 | 低(向量库 + 检索) | 高(GPU 训练 + 数据标注) |
| 适合 | 事实型问答、动态知识、私有文档 | 固定风格/格式、特定领域术语、稳定能力 |
| 可解释性 | 高(能溯源到具体文档) | 低(知识在黑盒参数里) |
| 幻觉控制 | 好(有资料兜底) | 一般(仍可能编) |
一句话决策:
- 知识要频繁更新 / 要可溯源 / 是私有文档 → RAG
- 要改模型的说话风格、输出格式、领域"语感" → 微调
- 既要有动态知识,又要有固定风格 → 两者结合:先微调一个"懂行话、风格稳"的底座,再用 RAG 注入实时知识。这是大型企业的高级玩法。
举几个具体场景:
- "客服机器人回答公司退款政策" → RAG(政策常变、要可溯源)
- "让模型用我们公司的法务文书风格写合同" → 微调(风格固定、私有语料)
- "医疗问答助手" → RAG 为主 + 少量微调(医学知识用 RAG 查指南,医学术语和问诊风格用微调)
常见误区:很多人以为"知识量大就该微调",错。知识量再大,只要会变、要溯源,就该 RAG。微调擅长的从来不是"塞更多知识",而是"调风格、格式、能力"。
八、本章小结
- RAG = 开卷考试:先从知识库检索相关资料,拼进 Prompt,让模型"看着资料答题"。核心解决幻觉、知识过时、私有数据三大痛点。
- 五大环节:文档解析、切片(chunk_size + overlap)、向量化(Embedding)、向量检索(余弦相似度 + top-k)、生成(拼 Prompt)。前三步建库(离线),后两步查询(在线)。
- 30 行代码就是本质:
openai + numpy就能跑通一个最小 RAG,所有框架都是在这五步上做增强。 - 三大流派:Naive(一条线)、Advanced(加查询改写/混合检索/Rerank)、Modular(模块可编排)。
- 高级四件套:查询改写(修口语化)、混合检索(向量+BM25 补精确匹配)、Rerank(cross-encoder 精排)、HyDE(用假答案检索)。
- 常见坑:召回率低、chunk 切不好、表格图片丢失、长文本中间遗忘、缺评估。
- RAG vs 微调:动态、可溯源、私有知识用 RAG;固定风格、格式、语感用微调;复杂场景两者结合。
- 本篇刻意没碰"向量数据库":示例用 Python 列表加 numpy 存向量,是为了看清本质;生产环境数据量大了,必须换专业向量库(pgvector / Pinecone / Qdrant 等),并配合 ANN 索引解决"海量向量怎么搜得快"的问题。
九、动手练习
练习 1(基础):把第三节的 mini_rag.py 跑通,把 DOCS 换成你自己写的一段"租房须知"(5~8 条),问 3 个问题,观察回答质量。再故意问一个知识库里没有的问题,确认模型会回答"没找到"而不是瞎编。
练习 2(进阶):在练习 1 基础上,加一个查询改写函数(参考 5.1),让模型先改写口语化问题再检索。对比"改写前 vs 改写后"在模糊问题(如"那房子能养宠物不")上的回答效果。
练习 3(挑战):给 mini_rag.py 加上 BM25 混合检索(参考 5.2),并造一个"含精确编号"的问题(如"XJ2024 房源的租金"),验证混合检索比纯向量检索更准。再尝试调整 RRF 的 alpha 参数(0.2/0.5/0.8),观察结果变化,体会"调参"在 RAG 工程里的分量。
十、延伸阅读
- RAG 开山论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》(Lewis et al., 2020):https://arxiv.org/abs/2005.11401
- 综述《Retrieval-Augmented Generation for Large Language Models: A Survey》,讲清 Naive/Advanced/Modular 三代演进:https://arxiv.org/abs/2312.10997
- 《Lost in the Middle: How Language Models Use Long Contexts》,讲长上下文中间遗忘:https://arxiv.org/abs/2307.03172
- HyDE 原始论文:https://arxiv.org/abs/2212.10496
- BGE Embedding 与 Reranker 模型库:https://huggingface.co/BAAI/bge-large-zh 、https://huggingface.co/BAAI/bge-reranker-base
- OpenAI Embeddings 官方指南:https://platform.openai.com/docs/guides/embeddings
- RAG 评估框架 RAGAS:https://docs.ragas.io/
收个尾:本篇你已拿到 RAG 的"骨架":五环节、30 行最小代码、高级四件套。示例里的向量库是列表加 numpy 线性扫描,数据量一上万就慢得不能看,生产环境要换成专业向量库。把第三节的最小实现跑起来,再拿一份真实文档走一遍五环节,你对 RAG 的理解就从"知道"变成"做过"了。