字节笔记本
2026年10月6日 · 约 30 分钟读完
AI 工作流专栏 18:LangGraph 与 Dify
本文是 AI 工作流专栏「Agent 与多步编排」主题的收官一篇:前半篇深入 LangGraph,动手写一个带循环和条件分支的研究助手工作流;后半篇上手低代码平台 Dify,从零搭一个知识库问答应用;最后给一张选型决策表,讲清代码派与低代码派各适合什么场景。
用 LangChain 的 AgentExecutor 跑过 Agent 的同学,多半经历过这种场面:Agent 在"思考、调用工具、再思考"的循环里转圈,你完全不知道它下一步会干什么,偶尔还会死循环,同一个工具来回调十几遍停不下来,token 烧得心疼。
问题出在它的运行模型上:AgentExecutor 本质是一个 while True 循环,LLM 决定调哪个工具,执行,把结果喂回 LLM,LLM 再决定下一步,直到 LLM 自己说"我答完了"才停。这种"把方向盘交给 AI"的黑盒模式,在生产环境里没人敢直接上线:
| 痛点 | 表现 | 后果 |
|---|---|---|
| 不可控 | 循环逻辑藏在框架里,没法让它在指定步骤停下来给人看一眼 | 生产环境不敢上线 |
| 难调试 | 跑偏的决策要从一大段 Thought/Action/Observation 文本里人肉定位 | 排查一个问题花半小时 |
| 易死循环 | LLM 偶尔反复调用同一个工具,没有"最多 N 次"的硬约束 | token 烧穿,账单爆炸 |
打个比方:黑盒 Agent 像坐进一辆自动驾驶出租车,你说"去机场",它自己规划路线,绝大多数时候能到,但偶尔绕进死胡同反复倒车,你坐在后座看着计价器狂跳却插不上手。LangGraph 是显式路线派:你提前画好路线,中间在哪改道、哪一步要停下来确认,全由你定的规则说了算。
LangGraph 是 LangChain 团队推出的有状态、可控循环的工作流编排框架。它把 AI 工作流建模成一张有向图:节点(Node)是处理单元,通常是函数或 LLM 调用;边(Edge)定义节点之间的跳转关系,可以是固定的,也可以基于条件;状态(State)是在节点之间流动的共享数据。整张图编译之后,可以像函数一样 invoke 或 stream。针对上面三个痛点,它的解法分别是:显式的图结构(可控),结构化 State 加流式输出(可调试),条件边加递归上限(防死循环)。
一、核心三件套:State、Node、Edge
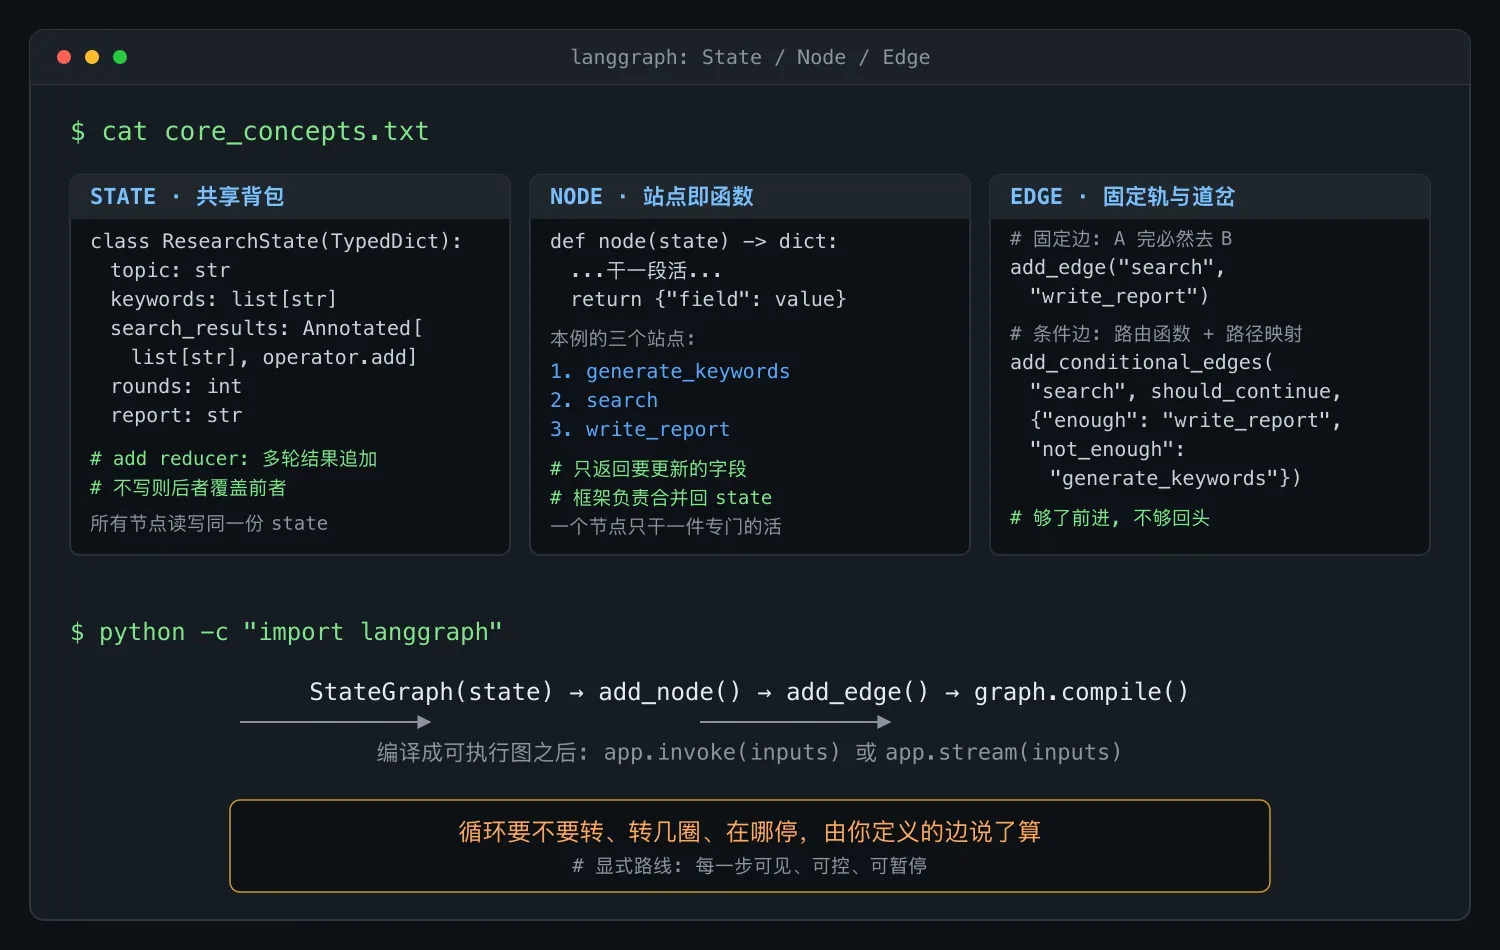
把一张 LangGraph 图想象成一个地铁系统:
- State(状态) 是所有站点共享的双肩包。每到一个站点,工作人员往包里塞点新东西(搜索结果、中间结论),下一个站点的人从包里掏出来接着用。
- Node(节点) 是地铁站点。每个站点干一件专门的活,本质上就是一个函数:接收包里的东西,干完活往包里塞新东西。
- Edge(边) 是铁轨,决定从这站能开到哪站。有的是固定铁轨,A 站必然开往 B 站;有的是道岔,根据包里某个标志决定拐去 B 站还是 C 站,这就是条件边(conditional edge)。
1.1 State:节点间传递的数据
State 是一个类型化的字典,Python 里用 TypedDict 定义,它规定了工作流从头到尾要记着哪些东西。每个字段还可以挂一个 reducer(归约函数),告诉框架当多个节点都往这个字段写时该怎么合并:
from typing import TypedDict, Annotated
from operator import add

class ResearchState(TypedDict):
    topic: str                  # 研究主题
    keywords: list[str]         # 搜索关键词(每轮可能更新)
    search_results: Annotated[list[str], add]  # 资料:每轮累加
    rounds: int                 # 已研究轮数(防死循环)
    report: str                 # 最终报告
关键技巧是 Annotated[list[str], add]:当某个节点返回 {"search_results": ["新结果"]} 时,LangGraph 不会覆盖原有列表,而是用 operator.add(也就是列表拼接)把新结果追加进去。不写 Annotated 的默认行为是后者直接覆盖前者,在循环场景下,前几轮的搜索结果会全部丢掉。
1.2 Node:每个节点是一个函数
节点就是普通的 Python 函数:接收 state,返回一个只包含要更新字段的 dict,框架负责把它合并回整个 state:
def generate_keywords(state: ResearchState) -> dict:
    topic = state["topic"]
    rounds = state.get("rounds", 0)
    prompt = (f"研究主题:{topic}。请给出 3 个用于网络搜索的关键词,"
              f"只返回 JSON,形如 {{\"keywords\": [\"k1\",\"k2\",\"k3\"]}}。")
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        response_format={"type": "json_object"},
    )
    keywords = json.loads(resp.choices[0].message.content)["keywords"]
    print(f"[节点1·第{rounds + 1}轮] 关键词: {keywords}")
    return {"keywords": keywords, "rounds": rounds + 1}
1.3 Edge:固定边与条件边
固定边用 add_edge("A", "B"):执行完 A 必然去 B。条件边用 add_conditional_edges:A 执行完后,框架调用一个路由函数看一眼 state,返回一个字符串(比如 enough 或 not_enough),再按路径映射决定去哪个节点:
def should_continue(state: ResearchState) -> str:
    enough = len(state.get("search_results", [])) >= 6   # 攒够 6 条就算够
    too_many = state.get("rounds", 0) >= 3               # 最多 3 轮,硬上限
    if enough or too_many:
        return "enough"
    return "not_enough"
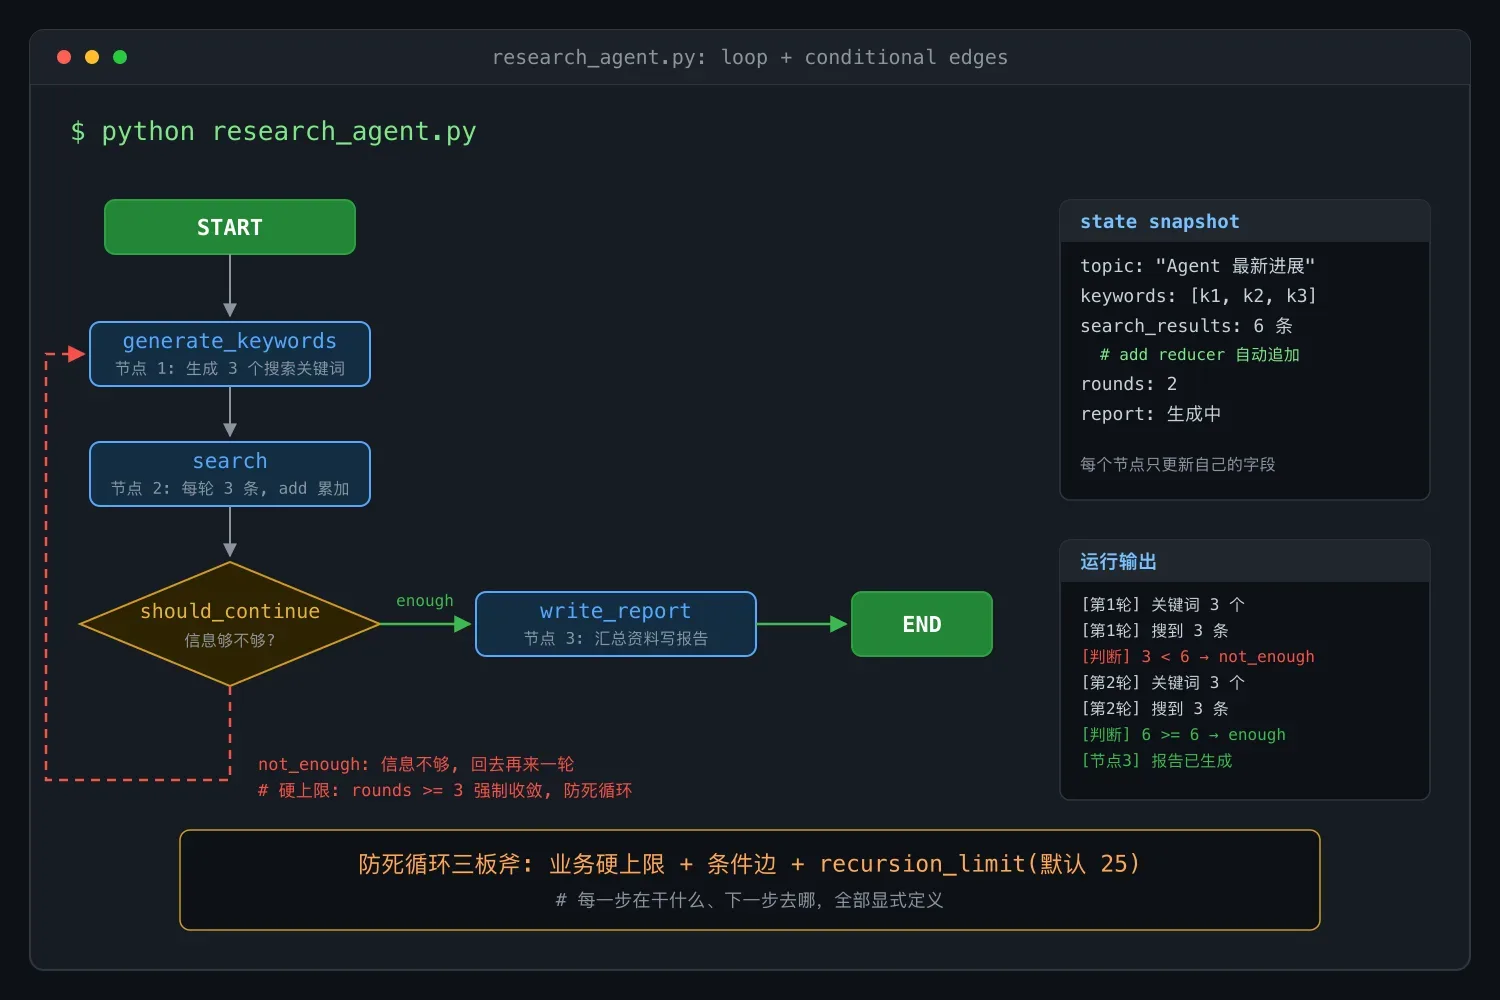
注意 too_many 这个判断,这是治死循环的精髓:业务层自己定一个硬上限,哪怕 LLM 一直说"不够不够",最多 3 轮也得停。
二、实战:写一个会自我纠错的研究助手
把三件套拼起来,我们要搭的工作流是:生成关键词,搜索,判断信息够不够;够了就写报告,不够就回到生成关键词再来一轮,最多 3 轮。
完整代码如下,保存成 research_agent.py,配好 OPENAI_API_KEY 就能跑:
# research_agent.py:LangGraph 研究助手工作流
import os, json, operator
from typing import TypedDict, Annotated
from openai import OpenAI
from langgraph.graph import StateGraph, START, END

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

class ResearchState(TypedDict):
    topic: str
    keywords: list[str]
    search_results: Annotated[list[str], operator.add]
    rounds: int
    report: str

def generate_keywords(state: ResearchState) -> dict:
    topic, rounds = state["topic"], state.get("rounds", 0)
    prompt = (f"研究主题:{topic}。请给出 3 个用于网络搜索的关键词,"
              f"只返回 JSON,形如 {{\"keywords\": [\"k1\",\"k2\",\"k3\"]}}。")
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        response_format={"type": "json_object"},
    )
    keywords = json.loads(resp.choices[0].message.content)["keywords"]
    print(f"[节点1·第{rounds + 1}轮] 关键词: {keywords}")
    return {"keywords": keywords, "rounds": rounds + 1}

def search(state: ResearchState) -> dict:
    # 这里用 mock 模拟搜索结果;真实场景换成 Tavily/SerpAPI 或自己的检索器
    results = [f"关于「{k}」的一条资料摘要" for k in state["keywords"]]
    print(f"[节点2] 搜到 {len(results)} 条结果")
    return {"search_results": results}   # 配合 add reducer 自动追加

def should_continue(state: ResearchState) -> str:
    n = len(state.get("search_results", []))
    rounds = state.get("rounds", 0)
    if n >= 6 or rounds >= 3:            # 攒够 6 条或跑满 3 轮就停
        return "enough"
    return "not_enough"

def write_report(state: ResearchState) -> dict:
    sources = "\n".join(f"- {r}" for r in state["search_results"])
    prompt = f"主题:{state['topic']}\n参考资料:\n{sources}\n请写一份 300 字的简明研究报告。"
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
    )
    print("[节点3] 报告已生成")
    return {"report": resp.choices[0].message.content}

graph = StateGraph(ResearchState)
graph.add_node("generate_keywords", generate_keywords)
graph.add_node("search", search)
graph.add_node("write_report", write_report)

graph.add_edge(START, "generate_keywords")
graph.add_edge("generate_keywords", "search")
graph.add_conditional_edges(
    "search", should_continue,
    {"enough": "write_report", "not_enough": "generate_keywords"},
)
graph.add_edge("write_report", END)

app = graph.compile()

if __name__ == "__main__":
    result = app.invoke({"topic": "大模型 Agent 的最新进展", "search_results": [], "rounds": 0})
    print(result["report"])
跑起来会发生什么:第一轮搜 3 条,should_continue 判定不够(3 小于 6),回到 generate_keywords 再来一轮;第二轮又搜 3 条,因为挂了 add reducer,列表自动变成 6 条,判定够了,进入 write_report 收尾。整个过程每一步在干什么、下一步去哪,全部由你定义的节点和边决定,这就是显式路线的力量。
三、让它配得上生产级:四个高级特性
光会循环和分支还不够,生产环境还要解决四个问题:人要能插手、断了能恢复、能并行、能拆小。
1. 人机协同(HITL)。 给客户发邮件、执行转账这类关键步骤不敢让 AI 自己干,可以用 interrupt_before:编译时指定在某个节点之前暂停,跑到那里图会自动停下,把当前 state 交给你,审完再从断点继续:
from langgraph.checkpoint.memory import MemorySaver

checkpointer = MemorySaver()
app = graph.compile(
    checkpointer=checkpointer,
    interrupt_before=["write_report"],   # 写报告前先暂停,等人确认
)
config = {"configurable": {"thread_id": "thread-001"}}
state = app.invoke({"topic": "LangGraph 怎么用", "search_results": [], "rounds": 0}, config)
final = app.invoke(None, config)         # 人审完,传 None 从断点继续
2. 持久化与断点恢复。 MemorySaver 是内存版检查点,进程一重启就没了。生产环境换成 SqliteSaver(存 SQLite 文件)或 PostgresSaver(存 Postgres),只要 thread_id 一样,程序崩了、服务器重启了,下次还能从中断的地方接着跑。在要跑半小时的研究、要等人审批这类长流程里,这是刚需。
3. 并行节点。 一个节点后面接多个节点,LangGraph 会并行执行它们(fan-out),再用一个节点把结果汇总(fan-back),比如同时用三个搜索引擎查、谁快用谁的结果。并发写 state 时靠 reducer 自动合并,你只要把边连出来就行。
4. 子图。 复杂系统一张图画不下,可以把某几个节点封装成子图,子图本身也是一个 StateGraph,作为父图的一个节点存在。大型多 Agent 系统首选 LangGraph,主要就是看中 State 加子图带来的层次化表达能力。
另外还有一道全局保险丝:recursion_limit(默认 25 步)。业务层忘了设上限,也绝对不会真的死循环到天荒地老,超过就抛错停住:
app.invoke(inputs, {"recursion_limit": 10, "configurable": {"thread_id": "t1"}})四、Dify:AI 应用界的 WordPress
代码派不是唯一答案。很多团队没有工程师,或者产品经理、运营想自己验证一个 AI 应用的想法,让他们去写 Python 不现实。低代码派的代表是 Dify:拖拖拽拽就能搭出一个带 RAG 知识库、带工具调用的 AI 应用,还能一键发布成 API。
十年前想搭个网站有两条路:硬核派自己写 HTML/CSS/JS、配 Nginx、搞数据库,能做但门槛高;WordPress 派装个 WordPress,点一点主题、拖一拖插件,一个像样的网站就上线了。Dify 之于 AI 应用,就是 WordPress 之于建站。
Dify 是一个开源的 LLM 应用开发平台(Apache 2.0 协议,GitHub 仓库 langgenius/dify)。它把开发一个 AI 应用需要的所有零件:大模型接入、Prompt 管理、RAG 知识库、工具调用、工作流编排、API 发布、用量统计,都做成了可视化模块。你可以用 Docker 自部署,数据完全留在自己的服务器上,对企业友好;也可以用官方云服务快速试用。
它和 LangChain、LangGraph 的根本区别一句话能说清:LangChain 是给程序员写代码用的库,Dify 是给所有人(包括产品、运营)拖拽用的平台。
五、十分钟搭一个知识库问答应用
5.1 Docker 自部署
装好 Docker 之后,四条命令搞定:
git clone https://github.com/langgenius/dify.git
cd dify/docker
cp .env.example .env
docker compose up -d
启动后浏览器打开 http://localhost,注册一个管理员账号就能用。所有数据(知识库、对话记录、向量)都存在本机的 Docker 卷里,不外传,这就是企业敢用的原因。不想自己部署,也可以直接用官方云 cloud.dify.ai,注册即用。
5.2 从一堆 PDF 到一个 API
假设要搭一个懂公司产品手册的客服机器人,流程五步:
- 建知识库:进"知识库",上传产品手册(PDF、Word、TXT、Markdown 都行,自带解析),选切片方式(自动分段或自定义分段)和 Embedding 模型(OpenAI、本地 BGE、通义都内置),点"保存并处理"。Dify 在后台完成切片、向量化、入库,全程不写一行代码。
- 建应用:进"工作室",创建空白应用,选"聊天助手"(也可以选"工作流"或"Agent")。
- 配 Prompt 和模型:在左侧"编排"里写系统 Prompt(比如"你是某公司的客服,只能基于知识库回答,不知道就说不知道");右侧选模型,GPT-4o-mini、Claude、DeepSeek、通义都内置,填各自的 API Key 就能切换;温度、最大 token、上下文长度都是表单项。
- 关联知识库:在"上下文"栏把第 1 步建的知识库挂上,配检索策略(Top-K、相似度阈值、是否 rerank)。RAG 的解析、切片、向量化、检索、重排环节,Dify 全部图形化了。
- 测试并发布:右侧有实时调试预览框,直接发问题试;调到满意了点"发布",会拿到一个 REST API 和一个 WebApp 链接,前者给前端后端调用,后者直接发给别人当网页用。
curl -X POST 'https://your-dify/v1/chat-messages' \
  -H 'Authorization: Bearer app-xxxxxxxxxxxx' \
  -H 'Content-Type: application/json' \
  -d '{"inputs": {}, "query": "你们的产品怎么退款?", "user": "user-001", "response_mode": "streaming"}'
从"有一堆 PDF"到"有一个能调用的 API",全程零代码,这就是低代码派的速度优势。
六、Dify 的六大核心能力
| 能力 | 干什么的 |
|---|---|
| Workflow 模式 | 拖拽画布编排多步流程(开始、LLM、检索、条件分支、结束),和 LangGraph 的"图"是同一个思想的图形化 |
| Agent 模式 | 让 LLM 自主决定调哪个工具(ReAct 心智模型),可视化配置工具列表和推理策略(Function Calling 或 ReAct) |
| RAG 知识库 | 上传文档、自动解析切片向量化、检索时挂到上下文,检索策略(向量、全文、混合)与 rerank 都可配 |
| 模型管理 | 一个后台接几十家模型(OpenAI、Anthropic、通义、DeepSeek、本地 Ollama),随时切换、对比 |
| Prompt 管理 | 把 Prompt 当资产版本化管理,团队共享、回滚、A/B 测试 |
| API 一键发布 | 编排好的应用一键生成 REST API 和 WebApp,自带鉴权、流式、用量统计 |
特别要注意 Workflow 模式和 Agent 模式的区别,它正好对应前面讲的"显式路线"与"自动驾驶":
- Workflow 模式:流程是你定的,确定性编排,适合输入稳定、流程固定的场景,比如"简历、抽取关键字段、打分、生成面试问题"。
- Agent 模式:流程是 LLM 定的,适合问题开放、需要灵活应变的场景,比如"帮我查下今天有什么新闻然后总结"。
七、代码派还是低代码派:选型决策表
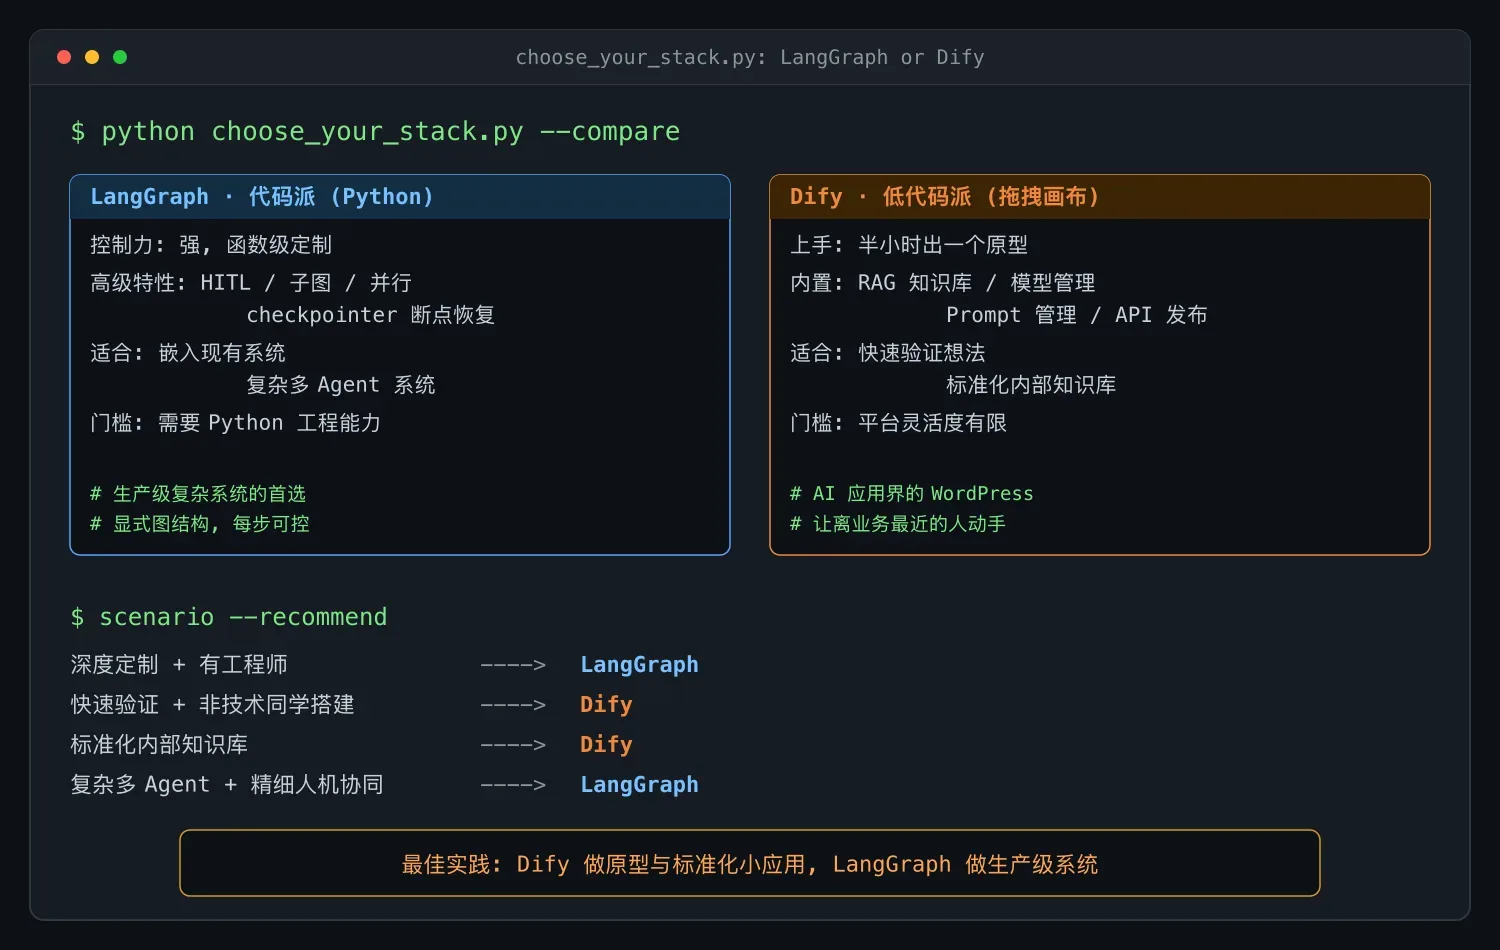
落到最实际的问题:做项目到底用 LangGraph 还是 Dify?四种典型场景:
| 你的场景 | 推荐方案 | 理由 |
|---|---|---|
| 团队有工程师,需要深度定制、嵌入现有系统、追求极致性能 | LangGraph | 代码级控制力,能接任何库、做任何优化;Dify 是平台,灵活度受限 |
| 产品或运营要自己搭,快速验证想法 | Dify | 零代码,半小时出活,让离业务最近的人直接动手,不用排工程师的期 |
| 企业内部知识库标准化(HR 文档、IT 工单、客服 FAQ) | Dify | 上手快、好维护,非技术人员也能改 Prompt 和知识库,自部署数据合规 |
| 复杂多 Agent 系统(多 Agent 协作、子图、精细 HITL、持久化恢复) | LangGraph | 画布表达不了太复杂的循环和子图,State 加子图就是为这种场景生的 |
这俩不是二选一,很多成熟团队是两个一起用的:想法验证阶段用 Dify,产品经理半小时搭个原型,拉用户测、收集反馈,这一步要的是快;方向确认后用 LangGraph 把它重写成可控、可观测、可扩展的生产系统,这一步要的是稳;标准化的小应用(周报生成器、会议纪要助手)就一直留在 Dify 上跑,没必要为它们养一套代码。这套组合拳的本质是:让低代码去做"快但不那么关键"的事,让代码去做"慢但很关键"的事。
八、要点小结
AgentExecutor是黑盒循环:不可控、难调试、易死循环,生产环境不敢直接用。- LangGraph 把工作流变成一张显式的图:State 用
TypedDict定义,Node 是返回部分字段的普通函数,Edge 分固定边add_edge和条件边add_conditional_edges,最后graph.compile()编译成可执行图。 Annotated[list, operator.add]reducer 让多轮结果自动累加而不是覆盖,循环场景必备。- 防死循环三板斧:业务层硬上限、条件边、全局
recursion_limit(默认 25 步)。 interrupt_before实现人机协同暂停;checkpointer(Memory、Sqlite、Postgres)实现断点恢复;并行节点与子图支撑大型多 Agent 系统。- Dify 是 AI 应用界的 WordPress:开源、可自部署、拖拽搭建、一键发布 API;六大能力是 Workflow、Agent、RAG 知识库、模型管理、Prompt 管理、API 发布。
- 选型口诀:深度定制加有工程师选 LangGraph,快速验证和标准化知识库选 Dify,复杂多 Agent 选 LangGraph。
- 最佳实践是组合拳:Dify 做原型和标准化小应用,LangGraph 做生产级复杂系统。
延伸阅读
- LangGraph 官方文档:https://langchain-ai.github.io/langgraph/
- LangGraph 持久化概念:https://langchain-ai.github.io/langgraph/concepts/persistence/
- LangGraph 人机协同教程:https://langchain-ai.github.io/langgraph/concepts/human_in_the_loop/
- Dify 官方文档(中文):https://docs.dify.ai/zh
- Dify GitHub 仓库:https://github.com/langgenius/dify
- Anthropic《Building Effective Agents》:https://www.anthropic.com/research/building-effective-agents (讲清"工作流与 Agent"的本质区别,正好对应 Dify 的两种模式)
动手练习
- 把第二节的代码跑起来,把"攒够 6 条"改成"攒够 9 条",观察它会跑几轮;再把
recursion_limit故意设成 3,看它怎么报错,感受保险丝是怎么拦住死循环的。 - 给研究助手加一个人工确认节点:在写报告前用
interrupt_before暂停,打印当前搜到的所有资料,终端输入 y 才继续、输入 n 就回去再搜一轮。 - 用 Docker 部署一个 Dify,上传一份 PDF 建知识库,创建聊天助手并关联,发布后用 curl 调它的 API,问 3 个只有那份文档能答的问题;再打开 Workflow 模式,加一个"条件分支"节点:问"价格"走 A 分支,问"技术"走 B 分支。