字节笔记本
2026年10月6日 · 约 67 分钟读完
AI 工作流专栏 10:流式输出 SSE 与函数调用全解
本文是 AI 工作流专栏的第 10 篇。调用大模型 API 最常见的写法,是发一次请求、等几秒后一次性拿回整段答案。这有两个硬伤:一是用户盯着空白页面干等,体验很差;二是模型只能"动嘴",查天气、查订单、调接口这些真正有用的事它一件都做不了。本篇解决这两个问题:流式输出(SSE) 让 AI 像 ChatGPT 一样"打字机式"逐字蹦字;Function Calling 让 AI 能调用你写好的函数。学完这一篇,你的 AI 助手就同时具备了"实时反馈"和"动手能力"这两项 ChatGPT 的招牌技能。
本篇你将学到:
- 为什么流式输出能从"体感上"把 AI 应用体验提升一个档次
- SSE(Server-Sent Events)的原理,以及它和 WebSocket 的本质区别与选型
- 用 OpenAI / DeepSeek SDK 做
stream=True流式调用,逐字拼接delta - 用 FastAPI 的
StreamingResponse加text/event-stream把流式能力包成 HTTP 接口 - 用浏览器原生
fetch+ReadableStream在前端消费 SSE(无需第三方库) - SSE 上线的三个大坑:反向代理缓冲、客户端断开、中途出错
- Function Calling 是什么,以及它和"让模型吐 JSON"的根本区别
- 用 JSON Schema 定义函数
tools,让模型"看得懂"你的工具 - 完整跑通 Function Calling 调用循环(含多轮 messages、mock 天气函数)
- 多函数并行调用的处理方式
- Function Calling / RAG / Agent 三者的边界与关系
一、为什么需要流式:从"干等"到"边生成边看"
1.1 生活类比:餐厅上菜
想象你去两家餐厅吃饭:
- A 餐厅:你点完菜,服务员说"请等 12 分钟",然后12 分钟后端着一桌菜一起上来。这期间你只能干坐着,不知道菜做到哪一步了,怀疑是不是把你忘了。
- B 餐厅:同样 12 分钟出餐,但服务员每隔几秒就端一盘菜到你桌上。第一盘 2 秒就到,你立刻能开吃,越吃越多,12 分钟后菜上齐。
总耗时一样,但B 餐厅的体感快 10 倍。为什么?因为人对"等待"的痛苦,主要来自"无反馈的空窗期"。一有动静,焦虑立刻消失。
大模型应用也是一模一样的道理。
1.2 传统调用 vs 流式调用
传统调用(一次性等完整结果):客户端发请求 → 等 LLM 把整段答案全部生成完 → 一次性返回。生成一段 500 字回答往往要 8–15 秒,这期间用户只能盯着一个转圈的 loading。
流式调用:客户端发请求 → LLM 一边生成一边把**已经生成的片段(delta)**实时推过来 → 前端拿到一个字就显示一个字,像 ChatGPT 那样"打字机"效果。第一个字通常 0.2–0.5 秒就到,用户立刻有反馈。
关键认知:流式不会让总生成时间变短(生成 500 字还是那 10 秒),但它把"首字节延迟(TTFB)"从 10 秒压到 0.3 秒。在交互设计里,TTFB 才是用户感知的"速度"。 这就是为什么 ChatGPT 一上线就把所有竞品甩开:不是因为模型更强,而是流式体验碾压。
1.3 流式还有两个隐藏好处
- 可以随时中断:用户看到答案跑偏了,点一下"停止"就能立刻打断,省 token 省钱。传统调用你只能干等它生成完。
- 支持渐进式渲染:如果输出是 Markdown,可以边收边渲染(标题、列表、代码块逐个出现),比一次性渲染更生动。
1.4 小结
| 维度 | 传统请求 | 流式请求 |
|---|---|---|
| 首字节延迟 | 高(等同总生成时间) | 极低(0.2–0.5s) |
| 用户体验 | 焦虑等待 | 即时反馈 |
| 总耗时 | 一样 | 一样 |
| 可中断 | 否 | 是 |
| 实现复杂度 | 简单 | 略复杂(要处理流) |
接下来看流式是怎么在底层"推"数据给你的。
二、SSE 原理:服务器主动"推"给你看
2.1 生活类比:广播电台 vs 对讲机
理解 SSE 和 WebSocket 的区别,最贴切的类比是广播电台和对讲机:
- SSE = 广播电台:电台单向播音,你的收音机只负责"听"。你打开就听,关掉就停。简单、稳定,一台发射塔能给十万人同时播。缺点:你不能对着电台说话(要说话得另开一条电话线)。
- WebSocket = 对讲机:双方都能随时说话(双向),适合需要频繁来回交互的场景(比如在线游戏)。缺点:协议复杂、要维持长连接、服务器压力大。
AI 流式输出的场景是:服务器单向、持续地把生成的字推给浏览器。浏览器不需要在生成过程中"回话"。所以 SSE 是这个场景的天选协议。
2.2 SSE 到底是什么
SSE(Server-Sent Events,服务器推送事件) 是 HTML5 标准里的一个协议,本质是基于 HTTP 的单向长连接:
- 客户端用普通 HTTP 请求(
GET或POST)发起连接 - 服务器不关闭连接,而是持续往这条连接里"写"数据
- 数据格式是纯文本,每条消息以
data:开头,以两个换行符\n\n结尾 - 客户端用
EventSource(浏览器原生)或fetch+ReadableStream持续读取
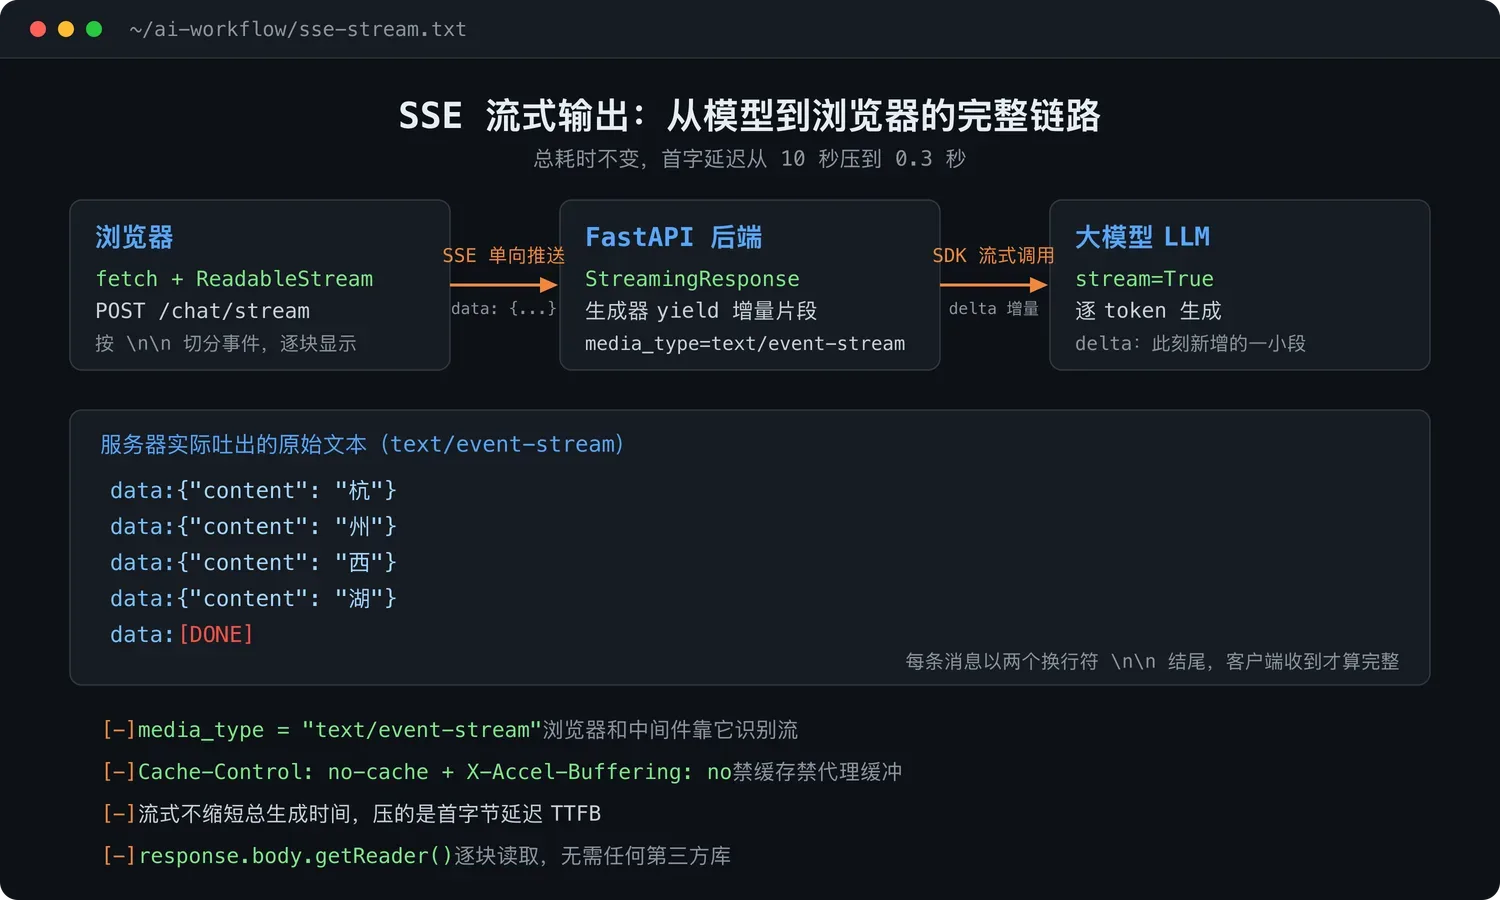
一个最朴素的 SSE 响应长这样(这是服务器实际吐出的原始文本):
data: 你

data: 好

data: ,世界

data: [DONE]
每一行 data: xxx 就是一个"事件",浏览器收到一个就触发一次回调。最后 [DONE] 是约定俗成的结束标记。
2.3 SSE vs WebSocket:怎么选
| 维度 | SSE | WebSocket |
|---|---|---|
| 协议 | 普通 HTTP | 独立的 ws:// 协议(先 HTTP 升级) |
| 方向 | 单向(服务器→客户端) | 双向 |
| 复杂度 | 低(就是 HTTP) | 高(要维护帧、心跳、重连) |
| 断线重连 | 浏览器自动重连 | 要自己写 |
| 代理 / 防火墙友好 | 好(标准 HTTP) | 偶尔被拦 |
| 适合场景 | LLM 流式、通知推送、股票行情 | 聊天室、在线游戏、协同编辑 |
结论:做 AI 应用,99% 用 SSE。只有当你需要客户端频繁往服务器推消息(比如实时语音对话)才考虑 WebSocket。
2.4 小结
SSE 是基于 HTTP 的单向长连接协议,服务器持续推、客户端只接收。它简单、稳定、对基础设施友好,是大模型流式输出的标准方案。理解了这一点,下面的代码就顺理成章了。
三、用 OpenAI / DeepSeek SDK 做流式调用
3.1 核心就一行:stream=True
普通的调用是"等完整结果",加一个 stream=True 就变成"边生成边拿":
# stream_basic.py:流式调用,逐字打印
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
    api_key=os.getenv("DEEPSEEK_API_KEY"),                 # 用 DeepSeek 演示
    base_url="https://api.deepseek.com/v1",                # 兼容 OpenAI 协议
)

# 关键:stream=True 让返回值变成一个"生成器",要遍历才拿得到数据
stream = client.chat.completions.create(
    model="deepseek-chat",
    messages=[{"role": "user", "content": "用 100 字介绍杭州西湖。"}],
    stream=True,                                           # 就这一行
    stream_options={"include_usage": True},                # 让最后一个 chunk 带 token 用量
)

full_text = ""
usage = None
for chunk in stream:                                       # 逐个 chunk 遍历
    # 每个 chunk 是模型生成的一小段(可能是一个字、一个词)
    delta = chunk.choices[0].delta.content if chunk.choices[0].delta.content else ""
    if delta:
        full_text += delta
        print(delta, end="", flush=True)                   # 立即打印,不换行
    # 最后一个 chunk 没有 choices,只有 usage
    if chunk.usage:
        usage = chunk.usage

print(f"\n\n--- 完整结果 ---\n{full_text}")
print(f"token 用量:输入 {usage.prompt_tokens} + 输出 {usage.completion_tokens}")
3.2 关键概念:delta(增量)
流式响应里,每个 chunk 的内容不是"完整答案",而是这一刻新生成的一小段,叫 delta(增量)。你要自己把所有 delta 拼接起来,才是最终完整文本。
类比一下:传统调用像快递员一次性送一整套乐高积木;流式调用像快递员每隔几秒寄一块积木给你,你得自己攒齐。攒的过程就是上面 for 循环里的 full_text += delta。
3.3 chunk 的结构
每个 chunk 大致长这样(伪结构):
ChatCompletionChunk(
    choices=[
        Choice(
            index=0,
            delta=ChoiceDelta(content="杭", role="assistant"),  # 这次新增的内容
            finish_reason=None,                                  # 还没结束
        )
    ],
    usage=None,  # 只有最后一个 chunk 才有 usage
)
最后一个 chunk 的 delta.content 通常是 None 或空,而 finish_reason="stop" 表示生成结束。
3.4 通用适配:流式版客户端函数
如果你的项目里已经有一层模型适配器,可以给它加一个 chat_stream() 方法。这里给一个独立可跑的简化版:
# stream_adapter.py:流式适配器(简化版)
import os
from typing import Iterator, Optional
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()


def chat_stream(
    messages: list[dict],
    model: str = "deepseek-chat",
    api_key: Optional[str] = None,
    base_url: Optional[str] = None,
    temperature: float = 0.7,
) -> Iterator[str]:
    """流式对话:yield 出每个增量片段,调用方负责拼接。"""
    client = OpenAI(
        api_key=api_key or os.getenv("DEEPSEEK_API_KEY"),
        base_url=base_url or "https://api.deepseek.com/v1",
    )
    stream = client.chat.completions.create(
        model=model,
        messages=messages,
        temperature=temperature,
        stream=True,
    )
    for chunk in stream:
        delta = chunk.choices[0].delta.content
        if delta:                       # 过滤掉空片段
            yield delta                 # 产出给调用方


# 用法
if __name__ == "__main__":
    for piece in chat_stream([{"role": "user", "content": "讲个程序员冷笑话"}]):
        print(piece, end="", flush=True)
为什么用 yield(生成器)? 这样调用方可以"拿到一个处理一个",天然就是流式的,不需要先把所有内容存进列表。这是 Python 处理流式数据的标准姿势。
3.5 小结
流式调用的核心是 stream=True,返回值从"一个完整对象"变成"一个可遍历的生成器"。每个 chunk 带 delta(增量),你要自己拼接。建议用 yield 封装成生成器函数,让流式能力可以复用。
四、用 FastAPI 把流式包成 HTTP 接口(SSE 完整闭环)
光会调用 SDK 还不够。真实项目里,前端浏览器没法直接调 LLM 的 SDK(那是后端的事,而且 Key 不能暴露给前端)。标准架构是:
浏览器 ←— SSE —→ 你的 FastAPI 后端 ←— SDK 流式 —→ LLM(OpenAI/DeepSeek)
后端做一个"中转":一边从 LLM 流式收数据,一边通过 SSE 流式推给浏览器。这一节我们把这个后端写出来。
4.1 装依赖
pip install fastapi "uvicorn[standard]" openai python-dotenv4.2 后端:FastAPI 的 StreamingResponse
FastAPI 提供了 StreamingResponse,专门用于把一个生成器变成流式 HTTP 响应:
# server.py:FastAPI SSE 服务端
import os
import json
import asyncio
from fastapi import FastAPI
from fastapi.middleware.cors import CORSMiddleware
from fastapi.responses import StreamingResponse
from pydantic import BaseModel
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

app = FastAPI()

# 允许前端跨域调用(开发时前端跑在别的端口)
app.add_middleware(
    CORSMiddleware,
    allow_origins=["*"],       # 生产环境请改成你的前端域名
    allow_methods=["*"],
    allow_headers=["*"],
)

client = OpenAI(
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com/v1",
)


class ChatRequest(BaseModel):
    message: str


def sse_format(text: str) -> str:
    """把文本包成标准 SSE 事件格式:data: xxx\n\n"""
    return f"data: {json.dumps({'content': text}, ensure_ascii=False)}\n\n"


@app.post("/chat/stream")
async def chat_stream(req: ChatRequest):
    """SSE 流式聊天接口"""

    def event_generator():
        """生成器:边从 LLM 收,边按 SSE 格式吐"""
        try:
            stream = client.chat.completions.create(
                model="deepseek-chat",
                messages=[
                    {"role": "system", "content": "你是一位友好的助手,回答简洁。"},
                    {"role": "user", "content": req.message},
                ],
                stream=True,
            )
            for chunk in stream:
                delta = chunk.choices[0].delta.content
                if delta:
                    yield sse_format(delta)          # 每个增量包成一个 SSE 事件

            # 正常结束,推一个结束标记
            yield "data: [DONE]\n\n"
        except Exception as e:
            # 中途出错也要通过 SSE 告诉前端,而不是默默断开
            yield sse_format(f"\n\n[生成出错:{e}]")
            yield "data: [DONE]\n\n"

    return StreamingResponse(
        event_generator(),
        media_type="text/event-stream",              # SSE 的 MIME 类型,关键!
        headers={
            "Cache-Control": "no-cache",             # 禁用缓存
            "X-Accel-Buffering": "no",               # 告诉 nginx 别缓冲(见后文第五节)
            "Connection": "keep-alive",
        },
    )


# 启动:uvicorn server:app --reload --port 8000
启动服务:
uvicorn server:app --reload --port 80004.3 三个关键点
media_type="text/event-stream":这是 SSE 的"身份证"。浏览器和一些中间件靠它识别"这是个流",从而不做缓冲。Cache-Control: no-cache:禁止任何环节缓存,否则数据会被攒成一坨。- 数据格式
data: ...\n\n:每个事件必须以两个换行符结尾,浏览器才会认为"这条消息完整了"。少一个换行,前端就收不到。
4.4 前端:用 fetch + ReadableStream 消费 SSE
浏览器原生有个 EventSource 对象能直接消费 SSE,但它只支持 GET 请求,且不能自定义 Header。AI 接口通常要 POST + 带 Token,所以业界标准做法是用 fetch + ReadableStream 手动解析流:
<!-- index.html:前端 SSE 消费(纯原生 JS,无需任何库) -->
<!DOCTYPE html>
<html lang="zh-CN">
<head><meta charset="UTF-8"><title>流式聊天 Demo</title></head>
<body>
  <div id="output" style="white-space: pre-wrap; font-size: 16px;"></div>
  <button id="ask">问一下杭州</button>

  <script>
    document.getElementById('ask').addEventListener('click', async () => {
      const output = document.getElementById('output');
      output.textContent = '';   // 清空旧内容

      // 用 fetch 发 POST,拿到的是一个流式 response
      const response = await fetch('http://localhost:8000/chat/stream', {
        method: 'POST',
        headers: { 'Content-Type': 'application/json' },
        body: JSON.stringify({ message: '用 100 字介绍杭州西湖' }),
      });

      // 拿到 response.body 这个 ReadableStream,逐块读取
      const reader = response.body.getReader();
      const decoder = new TextDecoder('utf-8');
      let buffer = '';

      while (true) {
        const { done, value } = await reader.read();
        if (done) break;

        buffer += decoder.decode(value, { stream: true });
        // SSE 事件以 \n\n 分隔,可能一次读到多个事件,要按 \n\n 切开
        const parts = buffer.split('\n\n');
        buffer = parts.pop();      // 最后一段可能不完整,留着下次拼

        for (const part of parts) {
          const line = part.trim();
          if (!line.startsWith('data: ')) continue;
          const data = line.slice(6);     // 去掉 "data: " 前缀
          if (data === '[DONE]') { output.textContent += '\n[结束]'; return; }
          try {
            const obj = JSON.parse(data);
            output.textContent += obj.content;   // 追加显示,形成打字机效果
          } catch (e) { /* 忽略非 JSON 行 */ }
        }
      }
    });
  </script>
</body>
</html>
直接双击打开这个 HTML(或用 python -m http.server 起个静态服务),点击按钮,你就能看到文字一个词一个词蹦出来,这就是 ChatGPT 同款效果。
4.5 小结
SSE 完整闭环 = FastAPI StreamingResponse(后端中转)+ fetch + ReadableStream(前端解析)。后端用生成器把 LLM 的增量包成 data: xxx\n\n 格式吐出,前端用 reader.read() 逐块读取并按 \n\n 切分。记住 text/event-stream、no-cache、\n\n 这三个关键点。
五、SSE 上线的三个大坑
流式代码本地能跑,上线却经常"不流了":数据憋半天一次性出来。原因几乎都是下面三个坑。
5.1 坑一:反向代理缓冲(最常见)
现象:本地开发流式正常,部署到线上(前面挂了 Nginx)后,要等十几秒答案才"一次性"全蹦出来。
原因:Nginx 默认开启 proxy_buffering,会把后端的响应攒到一定大小或响应结束才转发给客户端。它本意是提升吞吐,但对 SSE 是灾难:SSE 就是要"小包实时推",被一攒就废了。
修复:在 Nginx 配置里,对 SSE 接口关掉缓冲:
location /chat/stream {
    proxy_pass http://backend;
    proxy_buffering off;          # 关键:关闭缓冲
    proxy_cache off;              # 关闭缓存
    proxy_http_version 1.1;       # SSE 需要 HTTP/1.1 长连接
    proxy_set_header Connection "";
    proxy_read_timeout 300s;      # 流式响应可能很久,别让 Nginx 提前超时
    # 顺带禁用 gzip,避免压缩也导致攒包
    gzip off;
}补充手段:即使改不了 Nginx,后端也可以在响应头里加 X-Accel-Buffering: no(上一节代码已加),Nginx 看到这个头会对这一个响应关掉缓冲。这是个救命的后门。
5.2 坑二:客户端断开了,后端还在傻跑
现象:用户点了"停止生成"或关了页面,但后端的生成器还在调 LLM,白烧 token。
原因:FastAPI 的生成器不会自动感知客户端断开。
修复:在生成器里周期性检查客户端是否还连着。FastAPI 里可以用 asyncio 配合 request.is_disconnected():
from fastapi import Request

@app.post("/chat/stream")
async def chat_stream(req: ChatRequest, request: Request):
    async def event_generator():
        stream = client.chat.completions.create(
            model="deepseek-chat", messages=[{"role": "user", "content": req.message}],
            stream=True,
        )
        for chunk in stream:
            # 检查客户端是否已断开
            if await request.is_disconnected():
                print("客户端已断开,停止生成")
                break                      # 跳出循环,后端停止调 LLM
            delta = chunk.choices[0].delta.content
            if delta:
                yield sse_format(delta)
        yield "data: [DONE]\n\n"

    return StreamingResponse(event_generator(), media_type="text/event-stream")
注意把生成器改成 async def,并在耗时操作间 await asyncio.sleep(0) 让出事件循环,is_disconnected() 才能及时返回。
5.3 坑三:生成中途出错怎么办
现象:生成到一半,LLM 返回了 500 或网络断了。如果什么都不处理,前端会"卡在半句话",用户不知所措。
修复:用 try/except 兜住,通过 SSE 把错误信息推给前端,并务必推一个 [DONE] 让前端知道"结束了"(哪怕是错误结束):
try:
    for chunk in stream:
        ...
except Exception as e:
    yield sse_format(f"\n\n[生成中断:{str(e)[:100]}]")
finally:
yield "data: [DONE]\n\n" # 无论成功失败,都要发结束标记核心原则:SSE 流必须有一个明确的"结束信号"(约定 [DONE]),前端才能把"等待状态"切换成"完成状态"。中途出错也要优雅收尾,别让连接悬空。
5.4 小结
| 坑 | 现象 | 修复 |
|---|---|---|
| 反向代理缓冲 | 上线后不流式,憋一下全出来 | Nginx proxy_buffering off + 响应头 X-Accel-Buffering: no |
| 客户端断开 | 后端继续烧 token | request.is_disconnected() 检查后 break |
| 中途出错 | 前端卡在半句话 | try/except 把错误推给前端 + 必发 [DONE] |
六、Function Calling 是什么:让 AI 学会"动手"
前面把流式讲完了,你的 AI 已经会"实时说话"。但它还是个"光说不练"的嘴炮:你问"明天北京天气怎么样",它只会一本正经地编一个数字(幻觉)。真正有用的助手得能去查真实数据,这就是 Function Calling 登场的时刻。
6.1 生活类比:聪明的客服配了一部电话
想象一个前台客服(大模型),脑子很聪明、嘴很会说,但他被困在柜台后面,看不到外面的真实信息。你问他"我那个快递到哪了?",他只能凭经验瞎猜(幻觉)。
现在你给他配了一部电话,并对他说:"这是查快递的电话,需要快递单号;那是查天气的电话,需要城市名。当用户问到这些,你就拨对应电话查一下,再把结果告诉用户。"
- 客服本人 = 大模型(负责理解和组织语言)
- 电话 + 使用说明 = Function Calling 的
tools定义 - 拨电话查到的结果 = 你代码里函数的真实返回值
关键点:客服自己不直接知道快递在哪,他只是"知道该打电话查"。真正查数据的是电话那头的人(你的函数)。模型扮演的是"决策者":它判断"这个问题需要调哪个函数、传什么参数",但不负责执行,执行由你的代码完成。
6.2 专业定义
Function Calling(函数调用) 是大模型的一项原生能力:你用结构化的方式把"我有哪些函数、每个函数要什么参数"告诉模型,模型在回答用户时,如果判断需要用某个函数,就会输出一个结构化的"调用请求"(函数名 + 参数),而不是直接编答案。你的代码拿到这个请求后真正执行函数,把结果再喂回模型,模型最后生成回答。
6.3 和"让模型吐 JSON"的本质区别
很多人会问:我直接在 Prompt 里说"请输出 {"city": "北京"} 这样的 JSON",我自己解析后去查天气,不也行吗?为什么要 Function Calling?
行,但很脆弱。区别在于:
| 维度 | Prompt 让模型吐 JSON | Function Calling |
|---|---|---|
| 谁来保证格式 | 模型自觉(不可靠) | 模型原生能力(结构稳定) |
| 参数类型校验 | 没有,模型可能吐 "北京" 也可能吐 ["北京"] | 模型按 JSON Schema 生成,类型稳定 |
| 失败率 | 高(加几句多余解释、漏字段很常见) | 低(专为结构化训练) |
| 能否并行 | 难(要自己解析) | 原生支持(一次调多个函数) |
| 模型"知道"这是工具吗 | 不知道,只是输出文本 | 知道,会按工具语义决策 |
一句话:让模型吐 JSON 是"哄着它配合",Function Calling 是"模型天生就会这门手艺"。生产环境一律用 Function Calling,别用 Prompt 凑合。
6.4 小结
Function Calling 让大模型从"只会说"升级为"会指挥调用外部工具"。模型负责决策"调什么、传什么",你的代码负责执行,结果再回喂模型生成最终回答。它比"让模型吐 JSON"稳定得多,是生产级 AI 应用的标配。
七、定义函数 schema:用 JSON Schema 告诉模型"你有哪些工具"
7.1 生活类比:给客服一张"工具使用手册"
你给客服配电话时,光甩给他一部电话不够,还得给他一张使用手册,写清楚:
- 这个工具叫什么(name)
- 干什么用的(description,模型靠这个判断"该不该用")
- 用它需要提供什么信息(parameters,以及每个参数的类型、是否必填)
模型也是一样。你把这张"手册"用 JSON Schema 格式写好,通过 tools 参数传给它。
7.2 定义一个 get_weather 函数
# tools_define.py:定义模型可用的工具
tools = [
    {
        "type": "function",                          # 固定值,表示这是一个函数工具
        "function": {
            "name": "get_weather",                   # 函数名(你的代码里要有同名函数)
            "description": "查询指定城市的实时天气。"
                           "支持中国主要城市。"
                           "当用户询问天气、是否下雨、穿什么衣服时调用。",  # 关键!模型靠它决策
            "parameters": {                          # 参数的 JSON Schema
                "type": "object",
                "properties": {
                    "city": {
                        "type": "string",
                        "description": "城市名,如 '北京'、'上海'、'杭州'",
                    },
                    "unit": {
                        "type": "string",
                        "enum": ["celsius", "fahrenheit"],   # 枚举,限定取值
                        "description": "温度单位,默认摄氏度",
                    },
                },
                "required": ["city"],                # city 是必填,unit 可选
            },
        },
    },
]
7.3 写好 description 的三个技巧
description 字段是 Function Calling 成败的关键:模型完全靠它判断"什么时候该用这个工具"。写好它有三条经验:
- 说清"什么场景下用":别只写"查天气",要写"当用户询问天气、是否下雨、穿衣建议时调用"。把触发场景点出来。
- 说清"需要什么输入":在参数的 description 里给例子("如 '北京'"),模型模仿能力很强。
- 说清"不擅长什么"(可选):如"只支持中国城市,国外城市返回空"。帮模型提前规避错误调用。
7.4 小结
用 JSON Schema 在 tools 参数里描述你的函数:name(函数名)、description(模型决策依据,最重要)、parameters(参数结构 + 类型 + 是否必填)。description 写得好,模型调用就准;写得糊,模型就乱调或漏调。
八、完整调用循环:从提问到回答的全过程
这是本篇最核心的部分。Function Calling 不是"调一次 API 就完事",而是一个多步循环。我们用一个可跑的完整例子演示。
8.1 循环的全貌
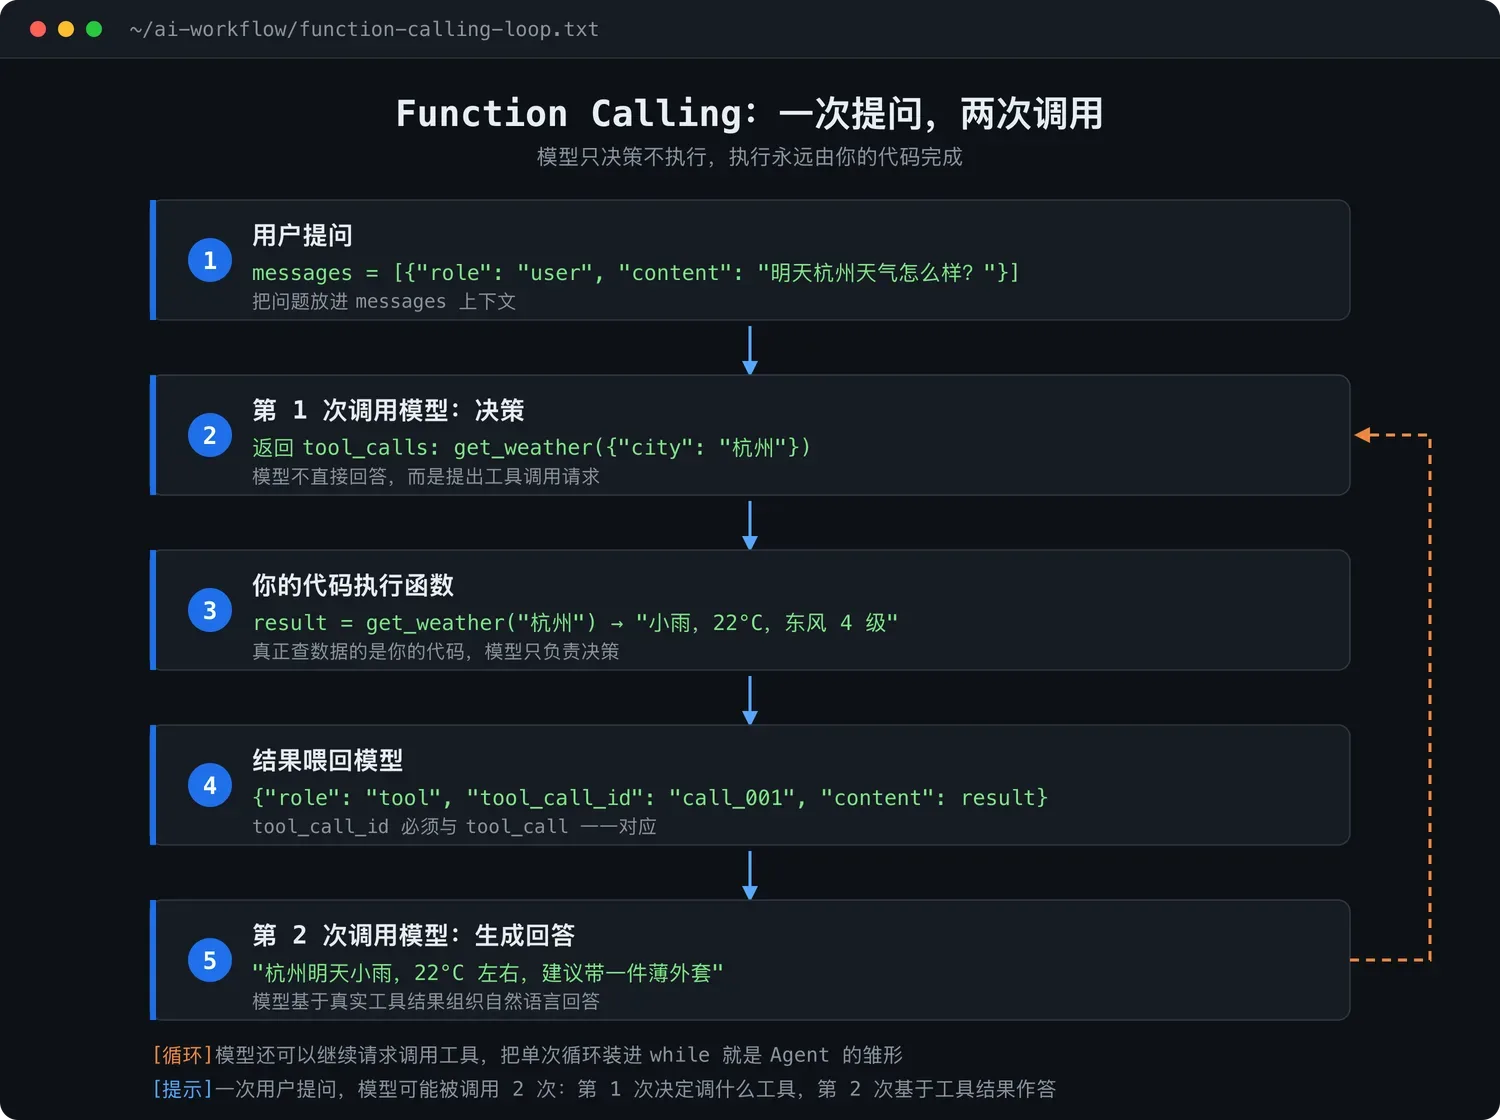
整个循环是这样的:
- 用户提问:把问题放进
messages - 第一次调模型:带上
tools参数,模型不直接回答,而是返回一个tool_calls("我要调 get_weather,参数是 city=杭州") - 你的代码执行函数:解析
tool_calls,调用真正的get_weather("杭州")函数,拿到结果 - 把结果喂回模型:把函数返回值作为一条
role="tool"的消息追加到 messages - 第二次调模型:模型现在有了"事实",生成最终的自然语言回答
注意:一次用户提问,可能要调模型 2 次(第一次决策调工具,第二次生成回答)。这是 Function Calling 和普通调用最大的区别。
8.2 完整可跑代码(含 mock 天气函数)
# function_calling_demo.py:完整 Function Calling 循环
import os
import json
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com/v1",
)

# ---- 第 1 步:定义工具 schema ----
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "查询指定城市的实时天气。当用户询问天气、是否下雨、穿衣建议时调用。",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {
                        "type": "string",
                        "description": "城市名,如 '北京'、'上海'、'杭州'",
                    },
                },
                "required": ["city"],
            },
        },
    }
]


# ---- 第 2 步:真正实现这个函数(这里用 mock,生产里换成真实天气 API) ----
def get_weather(city: str) -> str:
    """实际项目中这里会调用天气 API(如和风天气、心知天气)。
    为了演示可跑,我们返回写死的数据。"""
    mock_data = {
        "北京": "晴,25°C,西北风 3 级",
        "上海": "多云,28°C,东南风 2 级",
        "杭州": "小雨,22°C,东风 4 级",
    }
    return mock_data.get(city, f"暂无 {city} 的天气数据")


# 用函数名做映射,方便根据模型返回的函数名找到真实函数
available_functions = {"get_weather": get_weather}


# ---- 第 3 步:开始对话 ----
messages = [
    {"role": "system", "content": "你是一个贴心的生活助手,回答要基于真实的天气数据。"},
    {"role": "user", "content": "我明天去杭州出差,那边天气怎么样?需要带伞吗?"},
]

# ---- 第 4 步:第一次调模型,看它要不要用工具 ----
print("【第 1 次调用:模型决策】")
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=messages,
    tools=tools,                 # 把工具清单传给模型
    tool_choice="auto",          # auto = 让模型自己决定要不要调;也可强制 "none" / 指定函数
)
msg = response.choices[0].message

# ---- 第 5 步:检查模型是否要求调用工具 ----
if msg.tool_calls:
    # 重要:把模型这条"assistant"消息(含 tool_calls)原样加进 messages
    messages.append(msg)

    for tool_call in msg.tool_calls:
        func_name = tool_call.function.name
        func_args = json.loads(tool_call.function.arguments)   # 参数是 JSON 字符串,要解析
        print(f"  模型想调用:{func_name}({func_args})")

        # 执行真实函数
        func = available_functions.get(func_name)
        if func:
            result = func(**func_args)
        else:
            result = f"未知函数:{func_name}"
        print(f"  函数返回:{result}")

        # ---- 第 6 步:把函数结果作为 role=tool 消息喂回 ----
        messages.append({
            "role": "tool",                       # 关键:role 必须是 "tool"
            "tool_call_id": tool_call.tool_call_id,  # 必须对上刚才那个 tool_call 的 id
            "content": str(result),               # 函数返回值转成字符串
        })

    # ---- 第 7 步:第二次调模型,让它基于工具结果生成最终回答 ----
    print("\n【第 2 次调用:模型生成最终回答】")
    final_response = client.chat.completions.create(
        model="deepseek-chat",
        messages=messages,
        tools=tools,      # 也可以再带上,允许它继续调
    )
    print(final_response.choices[0].message.content)
else:
    # 模型没要求调工具,直接就是最终回答
    print(msg.content)
运行后你会看到类似这样的输出:
【第 1 次调用:模型决策】
  模型想调用:get_weather({'city': '杭州'})
  函数返回:小雨,22°C,东风 4 级

【第 2 次调用:模型生成最终回答】
杭州明天是小雨,气温 22°C 左右,东风 4 级。建议您带上雨伞,穿一件薄外套……
8.3 三个最容易踩的坑
- 忘了把 assistant 的
tool_calls消息加回 messages:那句messages.append(msg)绝不能漏。如果漏了,第二次调用时模型"不知道自己刚才要求调函数",会报错或重复要求。 tool_call_id没对上:一次可能产生多个 tool_call,每个都有唯一 id。喂回结果时tool_call_id必须和对应的 tool_call 一一对应,否则模型会混乱。- 参数
arguments是字符串不是字典:模型返回的tool_call.function.arguments是 JSON 字符串,必须json.loads()解析后才能用。直接当字典用会报错。
8.4 小结
Function Calling 是个"决策 → 执行 → 回喂 → 生成"的循环:第一次调用让模型决定调哪个工具,你的代码执行后把结果作为 role="tool" 消息(带正确的 tool_call_id)喂回,第二次调用让模型基于事实生成回答。务必把 assistant 的 tool_calls 消息也加进 messages。
九、多函数并行调用:一次问多个城市
9.1 场景
用户问:"帮我对比一下北京、上海、杭州三个城市的天气。" 如果模型一次只调一个函数,要来回 3 轮,很慢。GPT-4o、DeepSeek 等现代模型支持"并行函数调用",一次返回多个 tool_calls,你的代码可以并行执行它们,再一次性喂回。
9.2 处理方式
好消息是:上一节的循环代码天然就支持并行,msg.tool_calls 本来就是个列表,for 循环会处理多个。我们只需在执行阶段改成并发执行来提速:
# parallel_function_call.py:并行执行多个函数调用
import os
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(api_key=os.getenv("DEEPSEEK_API_KEY"), base_url="https://api.deepseek.com/v1")

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "查询指定城市的实时天气。",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string", "description": "城市名"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city: str) -> str:
    data = {"北京": "晴 25°C", "上海": "多云 28°C", "杭州": "雨 22°C"}
    return data.get(city, "未知")

messages = [
    {"role": "user", "content": "对比北京、上海、杭州三个城市的天气,哪里最适合明天出游?"},
]

resp = client.chat.completions.create(
    model="deepseek-chat", messages=messages, tools=tools, tool_choice="auto",
)
msg = resp.choices[0].message

if msg.tool_calls:
    messages.append(msg)

    # 用线程池并行执行所有 tool_calls(IO 密集型,线程池合适)
    def run_one(tc):
        args = json.loads(tc.function.arguments)
        result = get_weather(**args)
        return {"role": "tool", "tool_call_id": tc.tool_call_id, "content": str(result)}

    with ThreadPoolExecutor(max_workers=4) as pool:
        tool_messages = list(pool.map(run_one, msg.tool_calls))

    messages.extend(tool_messages)          # 一次性把所有结果喂回

    # 第二次调用,生成对比回答
    final = client.chat.completions.create(model="deepseek-chat", messages=messages, tools=tools)
print(final.choices[0].message.content)关键点:所有 tool 的结果要全部喂回后,再发起第二次模型调用,让模型基于完整信息一次性对比。如果喂一个调一次,反而更慢且容易乱。
注意模型支持度:并行函数调用需要模型支持(GPT-4o、GPT-4o-mini、Claude 3.5+、DeepSeek-chat 都支持;一些小模型或老版本可能一次只调一个)。可以通过
parallel_tool_calls=True/False参数显式控制。
9.3 小结
现代模型可一次返回多个 tool_calls,用线程池并行执行能显著提速。务必把所有结果都喂回后再做第二次调用。这是 Function Calling 走向 Agent(多步循环)的基础。
十、Function Calling vs RAG vs Agent:澄清三个最容易混的概念
这三个词在招聘 JD 和技术文章里经常混着用,很容易懵,这里一次性厘清。
10.1 一句话区分
- Function Calling(函数调用):让模型调用一个你写好的函数(查天气、查订单、发邮件)。单次、由模型决策。
- RAG(检索增强生成):先从你的文档库里检索相关内容,再让模型基于检索结果回答。解决的是"模型不知道你的私有知识"。单次检索 + 单次生成。
- Agent(智能体):把 Function Calling 放进一个循环,模型思考 → 调工具 → 看结果 → 再思考 → 再调工具,直到完成任务。多步、自主决策。
10.2 对比表
| 维度 | Function Calling | RAG | Agent |
|---|---|---|---|
| 解决什么 | 模型没有外部数据 / 不能执行动作 | 模型不知道你的私有知识 | 复杂任务需要多步推理 + 多个工具 |
| 调用次数 | 单次(决策→执行→回答) | 单次(检索→生成) | 多次(循环) |
| 谁来决策"下一步" | 模型决策调哪个函数 | 固定流程 | 模型自主决策每一步 |
| 复杂度 | 低 | 中 | 高 |
| 本质 | 一个"工具" | 一种"增强知识的方式" | 一个"会思考会行动的系统" |
10.3 它们其实是组合关系
真实 AI 应用往往是三者组合:一个 Agent 在循环中,把 RAG 当成它的一个工具(通过 Function Calling 调用检索函数),还能调用查天气、发邮件等其他工具。比如:
"帮我研究一下竞品公司最近的动态,整理成报告发给我。" → Agent 决策:先调
search_web(联网搜索)→ 看结果 → 调search_docs(RAG 检索内部资料)→ 综合后调send_email发送。
Function Calling 是基石,RAG 是知识增强,Agent 是把它们串起来的"大脑"。 Agent 怎么"自己思考"值得单独深挖,而本篇讲透的调用循环正是理解它的基石。
10.4 小结
FC 是单次工具调用,RAG 是检索增强知识,Agent 是 FC 的循环升级版(自主多步)。三者不是替代关系而是组合关系,成熟的 AI 应用通常 Agent + RAG(作为工具)+ 多个 Function Calling 一起用。
本章小结
Part A 流式输出(SSE):
- 为什么要流式:不缩短总时间,但把首字节延迟从十几秒压到 0.3 秒,体感快 10 倍,这是 ChatGPT 体验碾压的根源。
- SSE 原理:基于 HTTP 的单向长连接,服务器持续推
data: xxx\n\n格式的事件。比 WebSocket 简单、对基础设施友好,是 AI 流式首选。 - SDK 流式调用:
stream=True+ 遍历chunk.choices[0].delta.content,自己拼接增量。 - FastAPI 完整闭环:
StreamingResponse+media_type="text/event-stream"做后端中转,前端用fetch+ReadableStream按\n\n切分消费。 - 三大坑:反向代理缓冲(
proxy_buffering off)、客户端断开(is_disconnected)、中途出错(try/except + 必发[DONE])。
Part B Function Calling:
- 本质:让模型从"只会说"升级为"会指挥调用外部工具",模型决策、你的代码执行、结果回喂。
- vs 吐 JSON:FC 是模型原生能力,结构稳定、支持类型校验和并行,生产环境别用 Prompt 凑合。
- 定义工具:
tools参数 + JSON Schema,description是模型决策的关键,要写清触发场景。 - 完整循环:第一次调用模型决策调工具 → 执行函数 → 结果作为
role="tool"消息(带tool_call_id)回喂 → 第二次调用生成回答。别忘了把 assistant 的 tool_calls 也加进 messages。 - 并行调用:模型可一次返回多个 tool_calls,用线程池并行执行后一次性喂回。
- 三者关系:FC 是基石、RAG 是知识增强、Agent 是 FC 的循环升级版,成熟应用三者组合使用。
动手练习
练习 1(基础):把第三节的 stream_basic.py 跑通,观察"逐字打印"的效果。然后修改它,让流式生成的同时实时统计已生成的字符数,每隔 10 个字打印一次当前字数(提示:在 for 循环里维护计数器)。
练习 2(进阶):照着第四节搭一个完整的 SSE 服务:后端用 FastAPI(可以直接复用 server.py),前端用 index.html。然后故意制造坑一:如果你本地有 nginx,把它配成反向代理但不加 proxy_buffering off,观察"流式不流"的现象,再加上该配置对比效果。没有 nginx 的话,至少把后端代码里的 X-Accel-Buffering: no 头去掉和加上各跑一次,观察差异。
练习 3(挑战):扩展第八节的 Function Calling 代码,再加一个工具 get_time(返回当前时间),让模型能同时回答"现在几点?杭州天气怎么样?"。要求:一、自己写 get_time 函数和它的 JSON Schema;二、把它加进 tools 列表;三、验证模型能根据问题选择调用不同的函数(问时间调 get_time,问天气调 get_weather,两个都问就并行调两个)。这是迈向 Agent 的第一步。
延伸阅读
- OpenAI 流式文档:https://platform.openai.com/docs/api-reference/streaming
- OpenAI Function Calling 指南:https://platform.openai.com/docs/guides/function-calling
- MDN:使用服务器发送事件(SSE 前端权威文档):https://developer.mozilla.org/zh-CN/docs/Web/API/Server-sent_events
- FastAPI StreamingResponse 文档:https://fastapi.tiangolo.com/advanced/custom-response/#streamingresponse
- DeepSeek Function Calling 文档:https://api-docs.deepseek.com/zh-cn/guides/function_calling
- Nginx 反向代理缓冲配置:https://nginx.org/en/docs/http/ngx_http_proxy_module.html#proxy_buffering
- JSON Schema 官方文档(写 tools 参数必读):https://json-schema.org/learn/getting-started-step-by-step
- 概念深入:把本篇的单次函数调用装进 while 循环,让模型自己决定下一步调什么工具,就是 Agent 的雏形,建议吃透本篇后再去研究 Agent 编排
Function Calling 让模型能"调用函数",但很多时候我们只想要模型直接吐出结构化数据(一段干净的 JSON、一张表格)供程序处理,比如把一篇新闻解析成标题、作者、日期、摘要四个字段。要做到这一点,需要用 JSON Schema 或 Pydantic 去约束模型输出,这套技术叫结构化输出。它是数据管线和 RAG 的前置技能,推荐在本篇代码跑通之后继续深入。