字节笔记本
2026年10月6日 · 约 17 分钟读完
Agent 好不好,数据说了算:评估驱动开发实战
本文是 Agentic Coding 实战课系列的第 20 章。前几章讲过怎么搭环境、写规格、拆任务、建验证循环,这一章解决一个更根本的问题:你怎么知道一次改动,到底是让 Agent 变好了还是变差了。答案是用评估驱动开发(Eval-DD,Evaluation-Driven Development),量化 Agent、Prompt 和模型的实际表现,用数据代替感觉做决策。这是从业余到专业的分水岭。
为什么需要评估
一个很常见的场景:开发者优化了合同风险检测的 prompt,感觉效果好了一些,上线后客户反馈漏检率反而升高了。
为什么感觉不可靠:
- 看 3 个案例:好棒
- 上 100 个案例:发现 30% 漏检
- 上线 1000 个:发现新 prompt 在某类合同上彻底失效
没有评估,你不知道自己是变好了还是变差了。
Eval-DD 的核心理念:用一组固定的、有标准答案的测试集,每次改动后跑一遍,用数字说话。
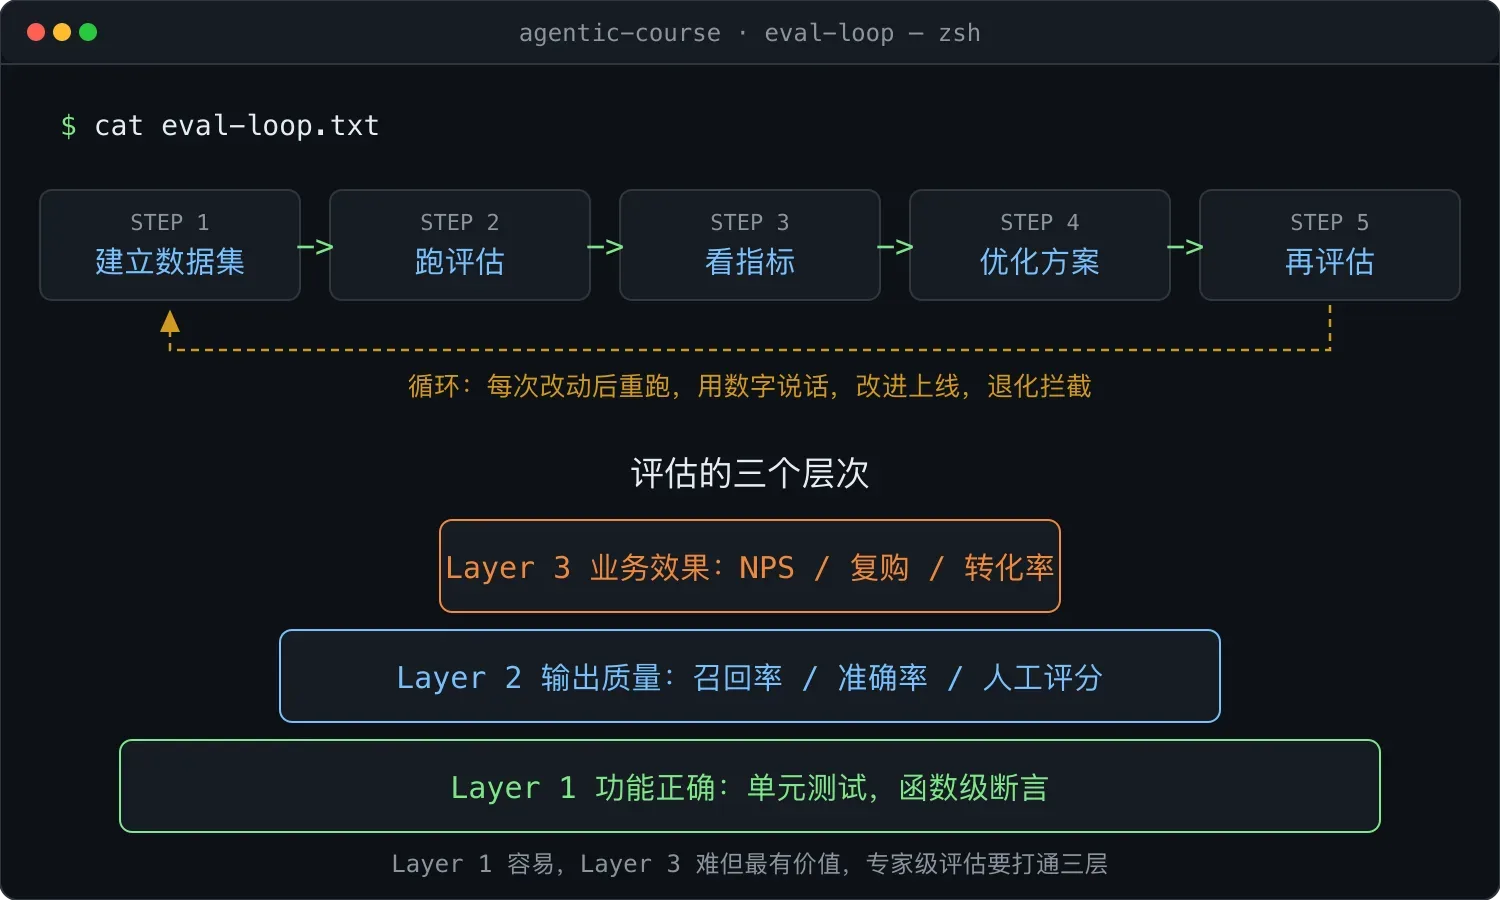
评估的三个层次
第一层是单元评估,检验功能对不对,就是常规的函数级测试。比如收入 100、成本 70,断言毛利函数返回 30:
def test_calc_margin():
    assert calc_margin(100, 70) == 30
第二层是质量评估,检验输出好不好,这是 LLM 项目的核心难点:输出"对"但"不好"怎么衡量?合同检测看召回率和准确率,文案生成看吸引力、一致性和转化率,翻译看 BLEU 分或人工评分。
第三层是业务评估,检验对业务有没有影响:合同检测看客户 NPS 和复购率,文案看实际点击率和转化率,翻译看用户停留时长。
第一层容易,第三层难但最有价值,专家级评估要打通三层。
建立你的评估数据集
评估的基础是数据集,三要素:输入(input)、标准答案(expected output)、标签(metadata,标注类型和难度)。
以一个合同风险检测项目为例,评估集长这样:
# eval_dataset.py
DATASET = [
    {
        "id": "E001",
        "input": "本合同期满自动续约 3 年,任何一方未书面通知视为同意。",
        "expected": [{"rule_id": "R001", "level": 3}],
        "tags": ["自动续约", "level3"]
    },
    {
        "id": "E002",
        "input": "乙方有权根据业务需要单方面修改本协议条款。",
        "expected": [{"rule_id": "R002", "level": 3}],
        "tags": ["单方变更", "level3"]
    },
    {
        "id": "E003",
        "input": "本合同一式两份,双方各执一份。",
        "expected": [],
        "tags": ["正常条款"]
    },
    # ... 至少 50 到 100 条
]
建立数据集有三条原则。
原则一:覆盖度大于数量。100 条都是"自动续约"的变体,不如 50 条覆盖全部规则类型加各种正常条款。
原则二:包含反例。必须有"无风险"的样本,用来测误报率:
{"input": "本合同经双方法定代表人签字并加盖公章后生效。", "expected": []}原则三:标注难度。每条样本标上 easy、medium 或 hard,分别对应明显的风险、需要业务理解的风险、隐晦或复合的风险,方便分层看指标。
数据集本身就是你的专业资产。整理 100 条带标签的合同样本,这种积累是 Agent 替代不了的。
四个关键指标
评估 LLM 类项目,盯四个指标:
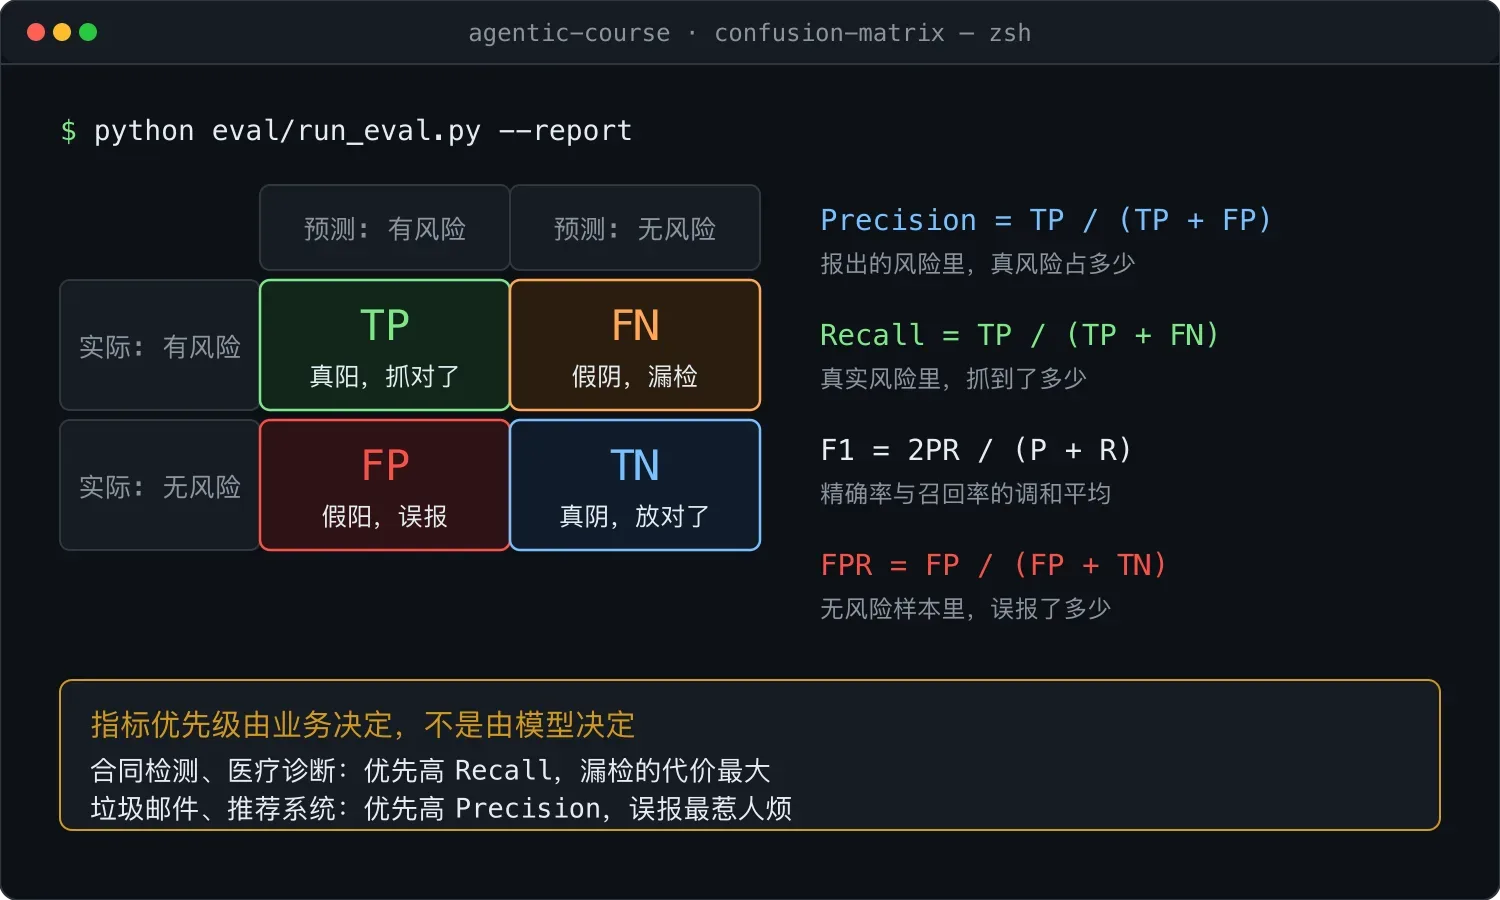
- Precision(准确率)= TP / (TP + FP):报出的风险里真风险占多少,高代表不乱报警。
- Recall(召回率)= TP / (TP + FN):真实风险里抓到了多少,高代表不漏检。
- F1 = 2 × P × R / (P + R):精确率和召回率的调和平均,是综合分。
- 误报率 FPR = FP / (FP + TN):无风险样本里误报了多少,低代表不烦人。
不同业务的指标优先级不同:
| 业务 | 优先高 Recall | 优先高 Precision |
|---|---|---|
| 合同检测 | 是,漏检等于法律风险 | 中,误报可人工筛 |
| 垃圾邮件 | 中 | 是,误报会漏掉重要邮件 |
| 医疗诊断 | 是,漏诊致命 | 中 |
| 推荐系统 | 中 | 是,推不准用户会烦 |
指标权重怎么定,是业务判断,不是模型问题,这是领域专家的价值所在。
评估代码实现
评估脚本的核心是逐条跑测试集、汇总混淆矩阵、算出指标:
# eval/run_eval.py
import json
from src.analyze import analyze_clause
from eval_dataset import DATASET

def run_eval():
    results = []
    for case in DATASET:
        predicted = analyze_clause(case["input"])
        predicted_rules = {p["rule_id"] for p in predicted}
        expected_rules = {p["rule_id"] for p in case["expected"]}
        results.append({
            "id": case["id"],
            "tp": len(predicted_rules & expected_rules),
            "fp": len(predicted_rules - expected_rules),
            "fn": len(expected_rules - predicted_rules),
            "tags": case.get("tags", []),
        })

    total_tp = sum(r["tp"] for r in results)
    total_fp = sum(r["fp"] for r in results)
    total_fn = sum(r["fn"] for r in results)
    precision = total_tp / (total_tp + total_fp) if (total_tp + total_fp) else 0
    recall = total_tp / (total_tp + total_fn) if (total_tp + total_fn) else 0
    f1 = 2 * precision * recall / (precision + recall) if (precision + recall) else 0
    return {"precision": precision, "recall": recall, "f1": f1, "cases": len(results)}

if __name__ == "__main__":
    print(json.dumps(run_eval(), indent=2, ensure_ascii=False))
跑一次 python eval/run_eval.py,输出:
{
  "precision": 0.85,
  "recall": 0.78,
  "f1": 0.81,
  "cases": 100
}
这就是你的基线,之后所有优化都和这组数字对比。
A/B 测试:用数据选方案
想优化 prompt,写了两版,到底哪个好?把两个版本各跑一遍评估,直接比数字:
# eval/ab_test.py

def ab_test(prompt_v1, prompt_v2):
    results = {}
    for name, prompt in [("v1", prompt_v1), ("v2", prompt_v2)]:
        set_active_prompt(prompt)
        results[name] = run_eval()
    return results
对比结果:
           v1      v2      delta
Precision  85.0%   88.0%   +3.0%
Recall     78.0%   82.0%   +4.0%
F1         81.0%   85.0%   +4.0%
v2 三项全胜,上线 v2。没有评估时,你可能凭感觉选错;有了评估,数字替你决策。
评估的四个反陷阱
陷阱一:过拟合评估集。一直优化同一个评估集,Agent 可能专门对这个集子表现好,实际效果差。解法:定期换一批新数据进评估集,再留一个不参与优化的私藏测试集定期跑。
陷阱二:指标不代表业务。准确率 99% 但用户还是不满意,说明指标没反映业务痛点。解法:定期做业务层评估,抽样真实用户反馈,跟踪 NPS 和复购率,看用户实际采用 Agent 输出的比例。
陷阱三:评估集太小。10 个样本跑出来的精度方差太大,没有统计意义。经验法则:每个类别至少 20 条,总数不少于 100 条。
陷阱四:标签错了。评估集本身标错,跑出来的指标全错。解法:重要标签多人交叉标注,定期审查标签质量,把有争议的标签记录下来讨论定夺。
LLM-as-Judge:用 AI 评 AI
有些任务的"标准答案"很难定义,比如文案质量。这时可以用一个 LLM 给另一个 LLM 的输出打分:
# eval/llm_judge.py
import json, anthropic

def judge_copy(generated_copy, criteria):
    client = anthropic.Anthropic()
    prompt = f"""你是文案评审专家。给下面的文案打分。
评审标准(每项 1-5 分):{criteria}
待评论文案:{generated_copy}
输出 JSON:{{"吸引力": 4, "一致性": 5, "ai_taste": 2, "comment": "..."}}"""
    response = client.messages.create(
        model="claude-sonnet-4-5",
        max_tokens=500,
        messages=[{"role": "user", "content": prompt}],
    )
    return json.loads(response.content[0].text)
注意,LLM-as-Judge 有偏见,同一个模型自评往往偏高。最佳实践是用更强的模型评较弱的模型,或者用不同厂商的模型交叉评。
把评估接进 CI
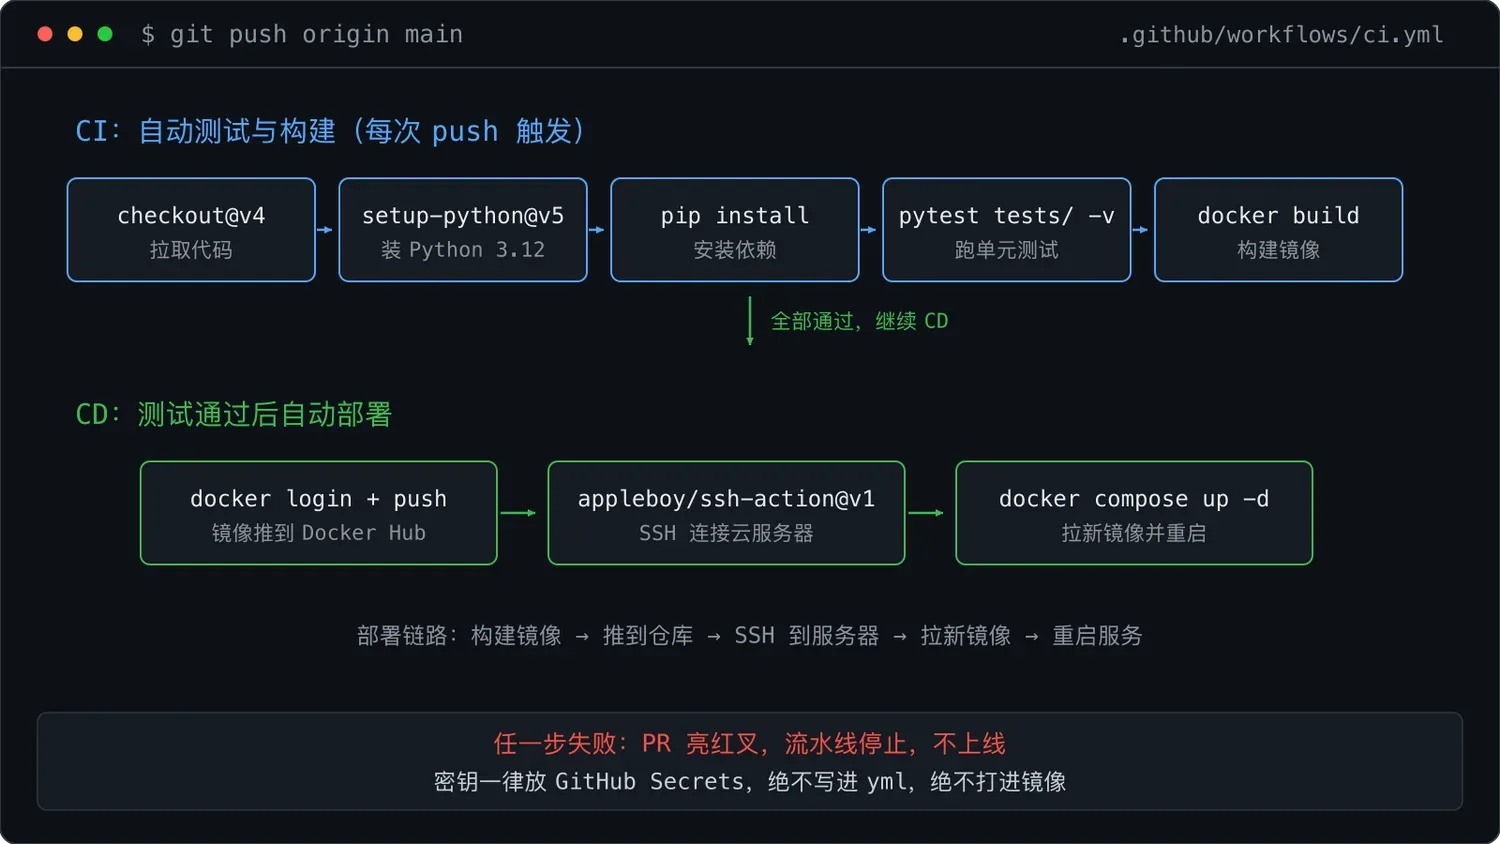
专业团队会把评估纳入 CI/CD,每次提交代码自动跑评估。GitHub Actions 配置:
# .github/workflows/eval.yml
name: Evaluation

on: [push, pull_request]

jobs:
  eval:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v4
        with:
          python-version: "3.11"
      - run: pip install -r requirements.txt
      - name: 跑评估
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: python eval/run_eval.py > eval_result.json
      - name: 检查指标不退化
        run: python eval/check_regression.py eval_result.json baseline.json
回归检查脚本:F1 比基线低 2% 以上就让 CI 失败,把退化拦在上线之前。
# eval/check_regression.py
import json, sys

new = json.load(open(sys.argv[1]))
baseline = json.load(open(sys.argv[2]))

if new["f1"] < baseline["f1"] - 0.02:
    print("[FAIL] F1 deg: {:.2%} -> {:.2%}".format(baseline["f1"], new["f1"]))
    sys.exit(1)

print("[PASS] F1 ok: {:.2%} -> {:.2%}".format(baseline["f1"], new["f1"]))
每次改 prompt 都自动验证:改进了通过,退化了拦截。这是专业级工作流的保险丝。
从"差不多"到"看数据"
评估文化分四个阶段:业余阶段凭感觉,"我觉得变好了";入门阶段偶尔评估,"上次跑了一次,好像不错";专业阶段每次都评估,"v2 比 v1 的 F1 高 4 个点,上线 v2";专家阶段业务加技术双评估,"线上数据看,转化率提升了 12%"。
养成三个习惯:每次改 prompt、模型或规则,必跑评估;每次上线,跟踪业务指标而不只是技术指标;定期扩充评估集,防止过拟合。
实操:给你的项目加评估
- 选一个你做过的项目。
- 建评估集,10 到 50 条起步,记得放反例。
- 写评估脚本,参考上文的 run_eval 实现。
- 跑出基线:
python eval/run_eval.py > baseline.json。 - A/B 测试:把两个 prompt 候选各跑一遍评估,比 F1,数字定胜负。
- 进阶:接入 GitHub Actions,每次 push 自动跑。
留一个思考题:用 10 条数据调 prompt,跑到 95% 准确率就上线,问题出在哪?一是样本太少,统计意义弱;二是可能过拟合;三是没看业务效果;四是没有留 holdout 测试集。
要点回顾
- 没有评估,就不知道是变好还是变差。
- 评估三层:单元、质量、业务,专家要打通三层。
- 数据集三要素:输入、标准答案、标签。
- 四个指标:Precision、Recall、F1、误报率。
- 业务决定指标优先级:合同检测看 Recall,推荐系统看 Precision。
- A/B 测试用数据选方案,凭感觉容易选错。
- 四个反陷阱:过拟合、指标不代表业务、集太小、标签错。
- LLM-as-Judge 适合主观任务,注意同模型自评偏高的偏见。
- CI 集成评估是防退化的保险。
- 从凭感觉到看数据,是从业余到专业的分水岭。
参考资料
- Eval-DD 思想参考 Anthropic 的 prompt evaluation 最佳实践
- LLM-as-Judge 模式源自 Zheng et al., 2023
- CI 集成评估参考 DVC、MLflow、Weights & Biases 的实践