字节笔记本
2026年10月6日 · 约 12 分钟读完
任务分解:把大象切成小块,Agentic 编程实战课 09
本文是《Agentic Coding 实战课》系列第 09 篇,主题是任务分解:怎么把一个大目标拆成 Agent 能稳定执行的小任务。这就像把大象装进冰箱,关键是先把它切成 Agent 一次吃得下的小块。规格写得再好,如果一次塞给 Agent 一个"建造一栋大楼"的任务,它依然会失控。学会分解,你才能从"做小工具"升级到"做真实项目"。
为什么 Agent 怕大任务
把大任务整个丢给 Agent,通常踩中三个坑。
风险一:上下文被耗光。 每个任务都要消耗上下文预算,一个"做完整 Web 应用"的任务可能吃掉全部预算,Agent 后半段开始"梦游"。
风险二:错了不知道哪错了。 Agent 一次做 10 件事,其中 3 件错了。你分不清是理解错了、实现错了,还是被前面的错误连带了。
风险三:返工成本爆炸。 如果 Agent 在第 1 步就理解错了,到第 8 步你才发现,前面 7 步全要重做。
一句话总结:
大任务等于高方差,你可能偶尔成功,但失败时损失惨重;小任务等于低方差,每步都可能有小偏差,但容易纠偏。
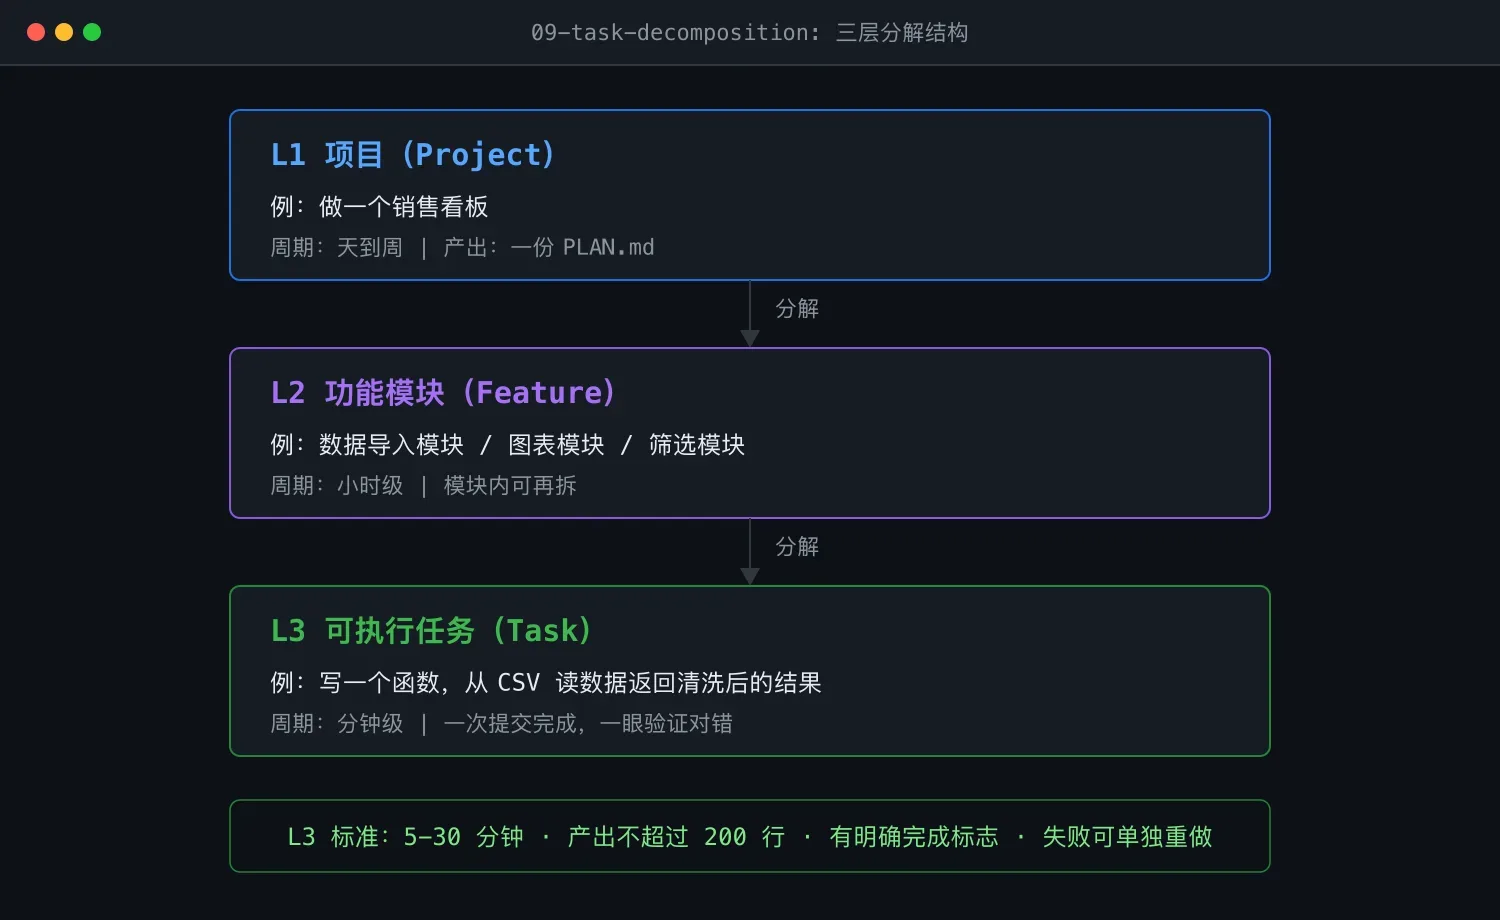
任务分解的三个层次
任务分解不是瞎拆,有一套层次结构:
- L1 项目(Project):例,"做一个销售看板",周期以天到周计;
- L2 功能模块(Feature):例,"数据导入模块、图表模块、筛选模块",周期以小时计;
- L3 可执行任务(Task):例,"写一个函数,从 CSV 读数据,返回清洗后的结果",周期以分钟计。
关键原则:L3 任务的大小标准,是能让 Agent 一次提交完成,且你能一眼验证对错。具体说:
- L3 任务耗时 5 到 30 分钟;
- L3 任务产出不超过 200 行代码;
- L3 任务有明确的"完成"标志;
- L3 任务失败可以单独重做。
三种分解模式
模式一:按流程切(线性任务)
适合有明确先后顺序的任务,如数据处理流水线:
项目:销售数据分析报告
├── Step 1:读取 sales.csv
├── Step 2:清洗数据(去重、补缺失、纠类型)
├── Step 3:按月聚合
├── Step 4:计算环比、同比
├── Step 5:生成图表
└── Step 6:导出 PDF 报告
每一步是一个 L3 任务,严格按顺序执行。
模式二:按模块切(系统任务)
适合有多个独立组件的系统,如 Web 应用:
项目:博客网站
├── 模块 A:数据库设计(独立)
├── 模块 B:后端 API(依赖 A)
├── 模块 C:前端页面(依赖 B)
│   ├── C1:首页
│   ├── C2:文章详情页
│   └── C3:后台管理
└── 模块 D:部署(依赖 B 和 C)
每个模块可以独立开发,模块内部有顺序。
模式三:按切片切(探索任务)
适合需求不完全清晰、需要边做边明确的场景:
项目:还没想清楚怎么做的小工具
├── 切片 1(MVP):最核心的功能,能用就行
├── 切片 2:加上必备但次要的功能
├── 切片 3:打磨体验(界面、性能)
└── 切片 4:补充边界情况
切片模式最适合新手:先做一个能跑的"最丑版本",再慢慢加功能。这就是 MVP(最小可行产品)思维。
实操案例:把"做销售看板"拆开
起点是一个坏示范,一句大任务指令:
> 帮我做一个销售看板,能导入数据、显示图表、能筛选
先拆 L2,再拆 L3
L2 模块分解:
1. 数据层:导入 CSV,做数据校验
2. 计算层:聚合、筛选
3. 展示层:图表和表格
4. 交互层:日期选择、维度切换
每个 L2 再拆成 L3 任务,以数据层为例:
Task 1.1:CSV 读取函数
- 输入:CSV 文件路径
- 输出:pandas DataFrame
- 要求:处理中文列名、日期解析
- 验收:用示例 sales_sample.csv 跑通

Task 1.2:数据校验函数
- 检查必填字段:日期、客户、金额
- 报告缺失、异常值
- 验收:故意传一个有缺失的 CSV,能识别问题

Task 1.3:异常值清洗
- 处理负数金额(退款)
- 处理重复行
- 验收:清洗后行数变化有报告
逐个执行:一次只做一个 L3
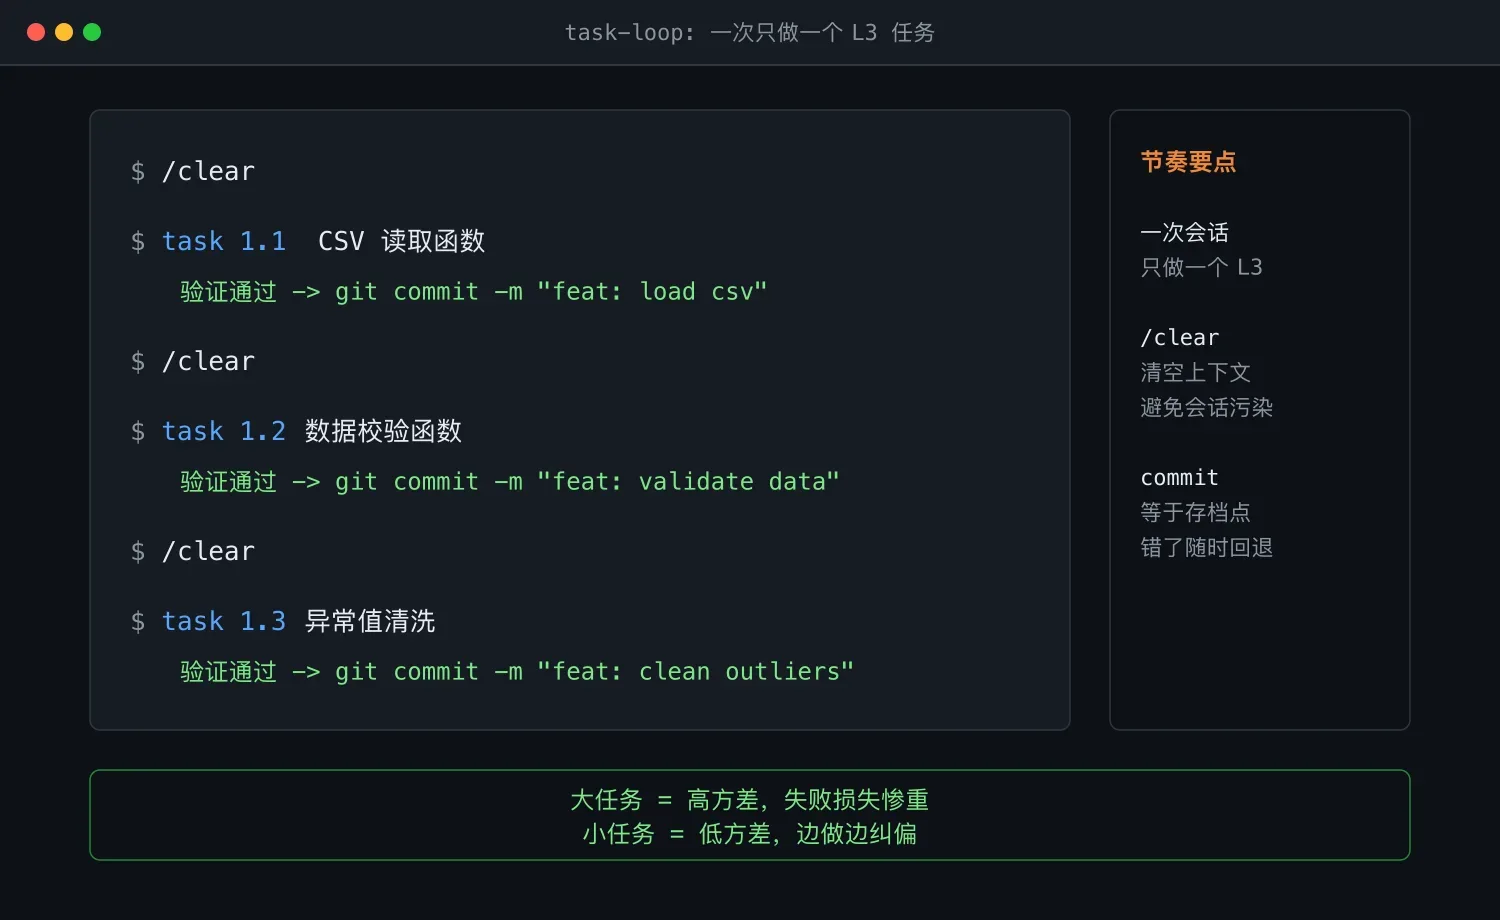
重要原则:一次只让 Agent 做一个 L3 任务。每次 /clear 让 Agent "重新开机",避免上下文污染;每次 commit 都是一个存档点,错了能回退。
以 Task 1.1 为例,给 Agent 的实际指令长这样:
任务:实现 CSV 读取函数

## 背景
项目:销售看板。我有一个销售数据 CSV,需要先把它读进来。

## 功能
- 函数名:load_sales_data(file_path)
- 输入:CSV 文件路径(字符串)
- 输出:pandas DataFrame

## 要求
1. 列名是中文(日期、客户名称、产品、数量、金额)
2. 日期列要解析为 datetime 类型
3. 金额列要是 float
4. 文件不存在时给清晰的错误提示

## 验收
我会在 test_load.py 里跑这个测试:
df = load_sales_data('sales_sample.csv')
assert len(df) > 0
assert df['日期'].dtype == 'datetime64[ns]'
assert df['金额'].dtype == 'float64'

请先创建 sales_sample.csv(10 行假数据),再实现函数,再跑通测试。
这个 L3 任务的规格足够精准:有函数名、输入输出、验收测试,Agent 一次到位。
一个可复用的分解清单模板
每次开始新项目,按这个清单走:
Step 1:写一句话目标(这个项目要解决什么)
Step 2:列出 L2 模块(3 到 7 个)
Step 3:每个 L2 拆 2 到 5 个 L3(选上文三种模式之一)
Step 4:标注依赖关系(哪个 L3 必须等另一个先做)
Step 5:找出最小切片 MVP(最少做哪几个 L3 能让东西跑起来)
Step 6:排执行顺序(先做 MVP,再加其他)
Step 7:执行(每个 L3 等于一次会话加一次 commit)
把这个模板存成 PLAN.md,每次开项目先填它,这是本系列强烈推荐的项目骨架。
三种常见分解错误
错误一:拆得太碎。 把"读取 CSV"拆成"打开文件、读行、解析字段、关闭文件"四个任务就是反例,这四件事本来就是一个原子任务,应该一起做。判断标准:如果一个任务拆开后,子任务之间没法独立测试,就别拆。
错误二:拆得太粗。 把"前端"整个当成一个 L3 任务太大,"首页""详情页""管理页"才分别是 L3。判断标准:如果一个任务预估超过 1 小时,继续拆。
错误三:忽略依赖。 同时启动"后端 API"和"前端调用",结果前端要调的接口后端还没写。正确做法是先 API 后前端,或者先约定接口文档(Mock)再并行。
[数据层] --> [API 层] --> [前端层]
               |
        [接口约定/Mock]
               |
        可让前端先开发
进阶:用 Agent 帮你分解任务
任务分解本身也可以让 Agent 帮忙,但要注意:Agent 帮你分解,你来拍板。
> 这是我的项目目标:[一句话]
> 这是约束:[技术栈、时间、不做什么]
>
> 请帮我:
> 1. 列出 3 到 7 个 L2 模块
> 2. 每个 L2 拆 2 到 5 个 L3 任务
> 3. 标注依赖关系
> 4. 推荐一个 MVP 切片
>
> 输出为 PLAN.md,我看完会修订。
关键在于:让 Agent 出方案,你修订后再执行。不要让 Agent 自己分解自己执行,那样会失控。Anthropic 在 2026 年的研究报告《Agentic Coding and Persistent Returns to Expertise》里也观察到了这一点:专家和高产者会让 Agent 辅助规划,但决策权始终在人手里,这正是"持久回报"的体现,因为只有专家能判断"这个分解合不合理"。
案例:从一团乱麻到清晰路径
一位学员要做一个日历提醒小程序,前后走了两条路。
失败路径是直接下指令:"帮我做一个微信小程序日历提醒应用。"结果 Agent 一顿操作生成 30 个文件,运行报错,他不知道哪里错了,崩溃放弃。
成功路径是先分解:
Step 1:L2 模块
1. 数据层:本地存储提醒
2. 逻辑层:日历计算 + 提醒触发
3. 界面层:列表页 / 详情页 / 设置页

Step 2:L3 任务与依赖
模块1:1.1 数据结构定义 -> 1.2 存取函数
模块2:2.1 日期计算(依赖1.1)-> 2.2 提醒触发
模块3:3.1 列表页(依赖1.2)-> 3.2 详情页 -> 3.3 设置页

Step 3:MVP 切片
最小可用 = 1.1 + 1.2 + 2.1 + 3.1
(能添加提醒、能在列表看到、能到时间触发)
然后每天做 1 到 2 个 L3 任务,5 天完成,全程没崩。
课后练习
练习一(必做):用上文模板把你自己手头的项目做一次完整分解,这是后续实战的执行清单。
练习二(必做):挑一个你已经用规格化方法写好需求的小工具(比如一份"书单管理器"),把它分解成 L3 任务清单并逐个执行,注意每完成一个 L3 就 /clear 加 commit。
练习三(推荐):找一个你以前没做完的项目,分析是不是没分解好。重新分解,看看是不是更容易推进了。
练习四(思考):这个任务怎么拆?"做一个能根据上传图片自动生成小红书风格文案的工具。"参考拆法:L2 可分为图像理解、文案生成、界面、集成四块;MVP 是先用一组固定标签加模板文案让流程跑通,不做图像理解;然后加图像理解;最后打磨文案质量。
本章要点回顾
- Agent 怕大任务:上下文被耗光、错了不知道哪错了、返工成本爆炸。
- 三层结构:项目、模块(L2)、可执行任务(L3)。
- 三种分解模式:流程式、模块式、切片式,新手推荐切片式 MVP。
- L3 标准:5 到 30 分钟、不超过 200 行代码、可单独验证。
- 一次一个 L3,配合 /clear 和 commit,是稳定推进的节奏。
- 分解可以让 Agent 辅助,但决策权在你。
下一篇预告:任务分好了、Agent 干完了,怎么知道做得对?下一讲是验证闭环,从"看代码"到"看结果",从"功能对"到"业务对"。
参考资料:任务分解借鉴软件工程 WBS(Work Breakdown Structure);MVP 概念源自 Eric Ries《精益创业》;Anthropic 2026 年研究报告《Agentic Coding and Persistent Returns to Expertise》。