字节笔记本
2026年10月6日 · 约 30 分钟读完
AI 工作流 05:SQL、索引与 Redis 缓存
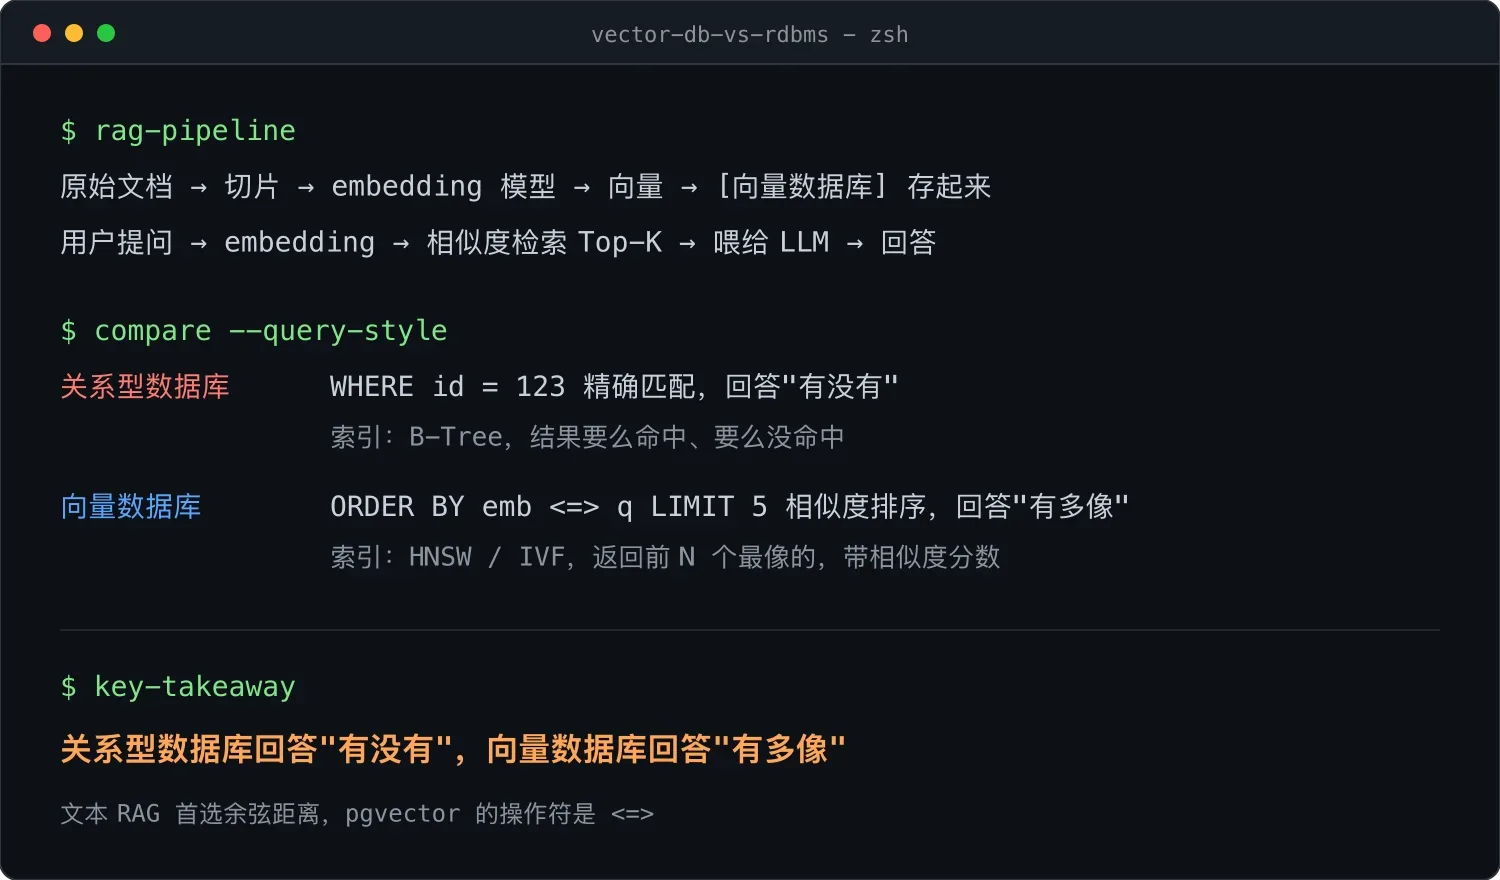
本文是「AI 工作流」系列的第 5 篇,主题是数据库。一个能调后端接口的全栈应用,如果把数据放在内存数组里,进程一重启就全没了;要真正可用,就得接上数据库。更重要的是,做 AI 同样绕不开它:RAG 的向量库 pgvector 就长在 PostgreSQL 上,企业知识库的文档和权限数据也存在关系型数据库里。本篇从零讲起,带你掌握 SQL、PostgreSQL、Redis 缓存三件套。
本篇你将学到:
- 关系型数据库与 SQL 的核心语法:建表、查询、索引
- PostgreSQL 上手,以及用 Python、Node 连接数据库
- 数据库设计原则:范式、外键、索引优化
- Redis 缓存的原理与实战
- 用 EXPLAIN 看懂慢查询
一、为什么 AI 工程师必须懂数据库
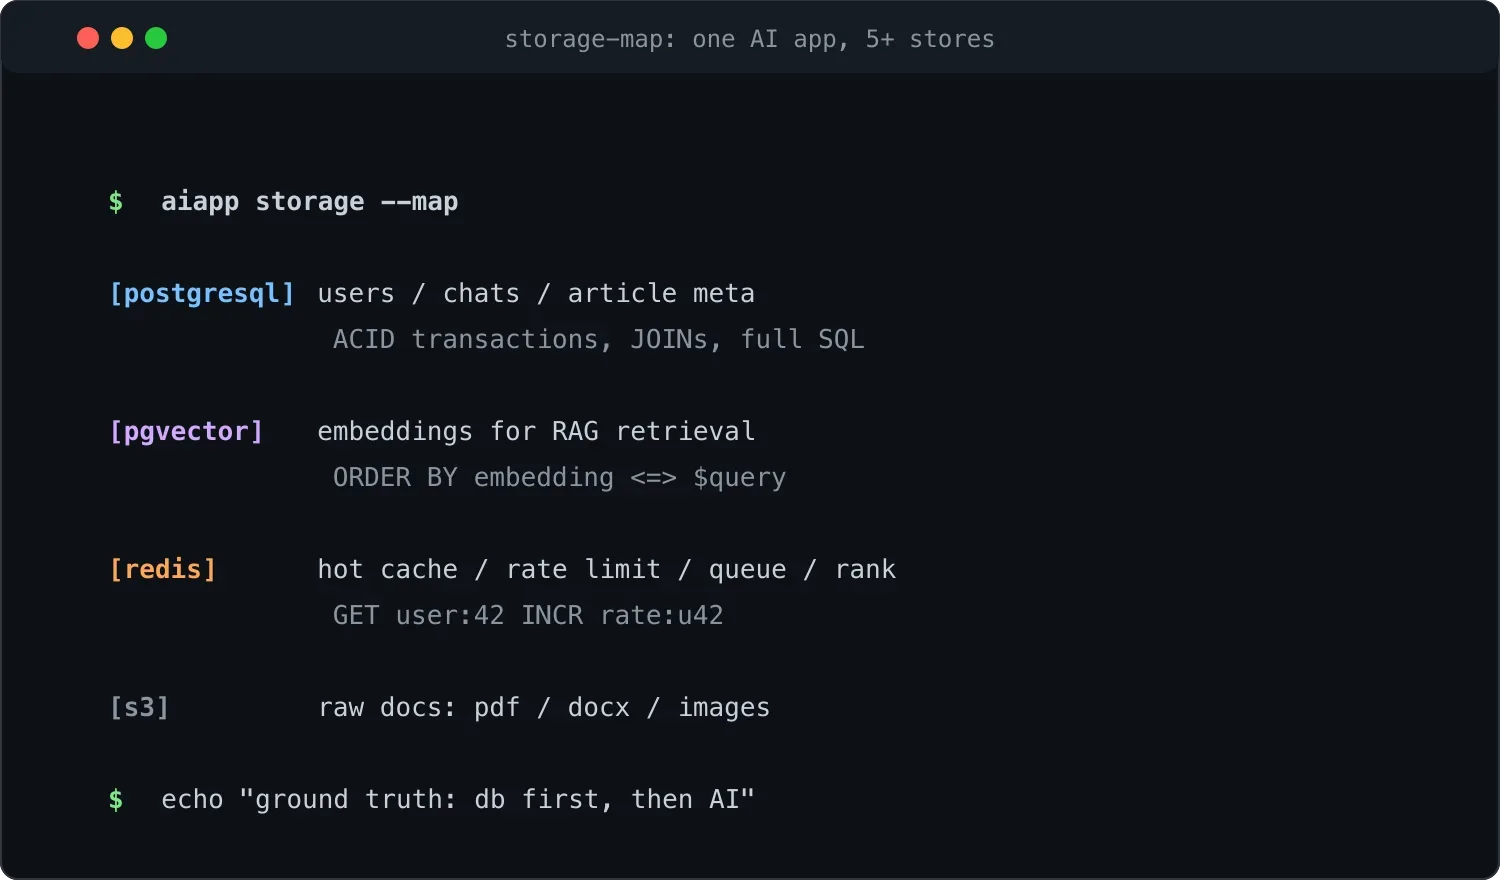
很多人以为"做 AI 就不用管数据库了",大错特错。看看一个真实的 RAG 系统用了哪些存储:
| 存什么 | 用什么 | 举例 |
|---|---|---|
| 用户账号、对话历史 | PostgreSQL / MySQL | "张三昨天问了什么" |
| 原始文档(PDF/Word) | 对象存储 (S3) + 数据库存元信息 | 文件名、上传时间、所属部门 |
| 文档的向量表示 | pgvector / Qdrant | 用于相似度检索 |
| 高频问答缓存 | Redis | 同一个问题别问两次大模型 |
| 限流计数 | Redis | "这个用户一分钟最多调 10 次" |
| 异步任务队列 | Redis / Kafka | 批量解析 100 个 PDF |
数一数:一个 AI 应用背后至少 5 种存储。数据库是你的"地基中的地基",地基不稳,整个系统会塌。
二、SQL:和数据库对话的语言
SQL(Structured Query Language)是操作关系型数据库的标准语言。不管是 PostgreSQL、MySQL、SQLite,SQL 语法几乎一样,学好一种通用。
2.1 SQL 的四大分类
| 分类 | 全称 | 干什么 | 关键字 | 日常频率 |
|---|---|---|---|---|
| DDL | 数据定义 | 建表、改结构 | CREATE / ALTER / DROP | 一般 |
| DML | 数据操作 | 增删改 | INSERT / UPDATE / DELETE | 高频 |
| DQL | 数据查询 | 查数据 | SELECT | 最高频 |
| DCL | 数据控制 | 权限管理 | GRANT / REVOKE | 偶尔 |
日常用得最多的是 DML 和 DQL,尤其 SELECT。
2.2 建表(DDL)
-- 创建用户表
CREATE TABLE users (
    id          SERIAL PRIMARY KEY,           -- 自增主键
    username    VARCHAR(50) UNIQUE NOT NULL,  -- 唯一非空
    email       VARCHAR(100) UNIQUE NOT NULL,
    age         INTEGER CHECK (age >= 0),     -- 带约束
    created_at  TIMESTAMP DEFAULT NOW()       -- 默认当前时间
);

-- 创建文章表(带外键关联 users)
CREATE TABLE articles (
    id          SERIAL PRIMARY KEY,
    title       VARCHAR(200) NOT NULL,
    content     TEXT,
    author_id   INTEGER REFERENCES users(id), -- 外键
    published   BOOLEAN DEFAULT FALSE,
    created_at  TIMESTAMP DEFAULT NOW()
);关键字解释:
SERIAL:自增整数(PostgreSQL 特有,MySQL 用AUTO_INCREMENT)PRIMARY KEY:主键,唯一标识一行NOT NULL:不能为空UNIQUE:不能重复REFERENCES:外键,指向另一张表
2.3 增删改(DML)
-- 插入数据
INSERT INTO users (username, email, age)
VALUES ('tom', 'tom@example.com', 25);

-- 批量插入
INSERT INTO users (username, email)
VALUES ('jerry', 'jerry@example.com'), ('spike', 'spike@example.com');

-- 修改数据(务必带 WHERE,否则全表改!)
UPDATE users SET age = 26 WHERE username = 'tom';

-- 删除数据(务必带 WHERE!)
DELETE FROM users WHERE username = 'spike';血泪警告:UPDATE 和 DELETE 不加 WHERE 会操作全表,生产环境的删库事故大多由此而来。养成习惯:先写 WHERE 再写 SET。
2.4 查询(DQL):SQL 的灵魂
查询是用得最多的,面试也最爱考。
-- 基础查询
SELECT username, email FROM users;
SELECT * FROM users;                                    -- * 表示所有列
SELECT * FROM users WHERE age >= 18;                    -- 条件
SELECT * FROM users WHERE age >= 18 AND username LIKE 't%';  -- 模糊匹配

-- 排序 + 分页(分页必背)
SELECT * FROM users ORDER BY created_at DESC LIMIT 10 OFFSET 0;   -- 第1页
SELECT * FROM users ORDER BY created_at DESC LIMIT 10 OFFSET 10;  -- 第2页

-- 聚合统计
SELECT COUNT(*) FROM users;                             -- 总数
SELECT age, COUNT(*) FROM users GROUP BY age;           -- 按年龄分组统计
SELECT AVG(age), MAX(age), MIN(age) FROM users;         -- 平均/最大/最小

-- JOIN 连表查询(重点!)
-- 需求:查所有文章标题 + 作者名
SELECT articles.title, users.username
FROM articles
JOIN users ON articles.author_id = users.id;

-- LEFT JOIN:左表全保留,右表匹配不上的填 NULL
SELECT users.username, COUNT(articles.id) AS article_count
FROM users
LEFT JOIN articles ON users.id = articles.author_id
GROUP BY users.id, users.username;
JOIN 是 SQL 的难点,画个图理解:
users 表                articles 表
┌────┬─────────┐       ┌────┬─────────┬───────────┐
│ id │ username│       │ id │ title   │ author_id │
├────┼─────────┤       ├────┼─────────┼───────────┤
│  1 │ tom     │<──────┤  1 │ 文章A   │     1     │
│  2 │ jerry   │<──────┤  2 │ 文章B   │     1     │
│  3 │ spike   │       │  3 │ 文章C   │     2     │
└────┴─────────┘       └────┴─────────┴───────────┘

JOIN 后:
┌─────────┬────────┐
│ title   │ author │
├─────────┼────────┤
│ 文章A   │ tom    │
│ 文章B   │ tom    │
│ 文章C   │ jerry  │
└─────────┴────────┘
spike 没写文章,所以不在结果里(INNER JOIN)
用 LEFT JOIN 的话 spike 会出现,article_count = 0
三、PostgreSQL 上手 + 用代码连数据库
3.1 安装 PostgreSQL
macOS:brew install postgresql@16 && brew services start postgresql@16
Windows:官网下载安装包
Docker(推荐,最省事):
docker run -d --name my-pg \
  -e POSTGRES_PASSWORD=123456 \
  -e POSTGRES_DB=myapp \
  -p 5432:5432 \
  postgres:16
3.2 用 GUI 工具:DBeaver / TablePlus
不要用命令行管理数据库,装个 DBeaver(免费)或 TablePlus(好用收费),可视化看表、写 SQL、看数据,效率提升一个量级。
3.3 Python 连 PostgreSQL(推荐 asyncpg 或 psycopg)
pip install psycopg2-binaryimport psycopg2
# 连接数据库
conn = psycopg2.connect(
host="localhost",
port=5432,
dbname="myapp",
user="postgres",
password="123456",
)
cur = conn.cursor()
# 建表
cur.execute("""
CREATE TABLE IF NOT EXISTS todos (
id SERIAL PRIMARY KEY,
text VARCHAR(200) NOT NULL,
done BOOLEAN DEFAULT FALSE,
created_at TIMESTAMP DEFAULT NOW()
)
""")
# 插入
cur.execute("INSERT INTO todos (text) VALUES (%s) RETURNING id", ("学 SQL",))
new_id = cur.fetchone()[0]
# 查询
cur.execute("SELECT id, text, done FROM todos ORDER BY id")
rows = cur.fetchall()
for row in rows:
print(row)
conn.commit() # 提交事务
cur.close()
conn.close()3.4 Node.js 连 PostgreSQL
npm install pgconst { Pool } = require("pg");
const pool = new Pool({
host: "localhost",
port: 5432,
database: "myapp",
user: "postgres",
password: "123456",
});
// 查询
async function getTodos() {
const res = await pool.query("SELECT * FROM todos ORDER BY id");
return res.rows;
}
// 插入
async function addTodo(text) {
const res = await pool.query(
"INSERT INTO todos (text) VALUES ($1) RETURNING *",
[text]
);
return res.rows[0];
}SQL 注入防范:永远用参数化查询(%s / $1 这种占位符),绝不用字符串拼接。比如 f"INSERT INTO ... VALUES ('{text}')" 是大忌:用户输入 '; DROP TABLE users;-- 就能删库。参数化查询是这条红线的唯一解法。
四、数据库设计:建表是门学问
4.1 设计原则:三大范式(小白版)
| 范式 | 一句话 | 反例与正解 |
|---|---|---|
| 1NF | 每列不可再分 | "姓名电话"一列塞下"张三,13800000000",正解是拆成两列 |
| 2NF | 非主键列必须依赖完整主键 | 订单明细表里直接存商品名,应该只存商品 id |
| 3NF | 非主键列之间不能互相依赖 | 订单表存"商品id、商品名、单价",商品名依赖商品 id 而不依赖订单,应移到商品表 |
实战中做到 3NF 即可,过度范式化会导致查询变慢(要 JOIN 太多次)。有时候为了性能会反范式化(故意冗余)。
4.2 一个真实例子:博客系统建表
-- 用户表
CREATE TABLE users (
    id SERIAL PRIMARY KEY,
    username VARCHAR(50) UNIQUE NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    password_hash VARCHAR(200) NOT NULL,    -- 存哈希不存明文!
    created_at TIMESTAMP DEFAULT NOW()
);

-- 文章表
CREATE TABLE articles (
    id SERIAL PRIMARY KEY,
    title VARCHAR(200) NOT NULL,
    content TEXT,
    author_id INTEGER REFERENCES users(id) ON DELETE CASCADE,  -- 作者删了文章也删
    view_count INTEGER DEFAULT 0,
    created_at TIMESTAMP DEFAULT NOW(),
    updated_at TIMESTAMP DEFAULT NOW()
);

-- 标签表(多对多)
CREATE TABLE tags (
    id SERIAL PRIMARY KEY,
    name VARCHAR(50) UNIQUE NOT NULL
);

-- 文章-标签关联表(多对多关系靠中间表)
CREATE TABLE article_tags (
    article_id INTEGER REFERENCES articles(id) ON DELETE CASCADE,
    tag_id INTEGER REFERENCES tags(id) ON DELETE CASCADE,
    PRIMARY KEY (article_id, tag_id)        -- 联合主键
);记住几个字段命名约定:
- 主键统一叫
id - 外键叫
xxx_id(如author_id) - 时间字段叫
created_at/updated_at - 布尔字段用
is_xxx/has_xxx(如is_published)
五、索引:让查询快 100 倍
5.1 索引是什么?
索引 = 给表加目录,让查询不用从头扫到尾。 就像查字典:没有目录只能一页页翻,有目录直接按拼音跳页。
-- 没有 index,查 username='tom' 要扫全表
SELECT * FROM users WHERE username = 'tom';

-- 加索引后,瞬间定位
CREATE INDEX idx_users_username ON users(username);

-- 现在同样的查询快 100 倍
5.2 什么时候该加索引?
| 场景 | 该不该加索引 |
|---|---|
WHERE username = 'tom' | 加 |
WHERE created_at > '2025-01-01' | 加 |
ORDER BY view_count DESC | 加 |
| 表只有 100 行 | 不用加(全表扫更快) |
| 频繁更新的字段 | 慎加(索引也要更新,写变慢) |
WHERE LOWER(name) LIKE '%tom%'(前缀模糊) | 普通索引无效,要专门的全文索引 |
5.3 复合索引的"最左前缀"原则
-- 复合索引
CREATE INDEX idx ON articles(author_id, created_at);

-- 这几个查询能用上索引吗?
WHERE author_id = 1                              -- 能(最左前缀)
WHERE author_id = 1 AND created_at > '2025-01-01' -- 能(完整匹配)
WHERE created_at > '2025-01-01'                   -- 不能(缺了 author_id)
记忆口诀:复合索引像电话簿,先按姓排再按名排,你不能跳过姓直接查名。
六、用 EXPLAIN 看懂慢查询
写 SQL 时永远问自己:"这个查询快不快?" 用 EXPLAIN 看数据库怎么执行:
-- 看执行计划
EXPLAIN SELECT * FROM users WHERE username = 'tom';

-- 输出(没索引时):
-- Seq Scan on users  (cost=0.00..25.00 rows=1 width=...)
--   Filter: (username = 'tom'::text)
-- Seq Scan = 顺序全表扫描,慢!

-- 加索引后再 EXPLAIN:
-- Index Scan using idx_users_username on users  (cost=0.00..8.00 rows=1)
-- Index Scan = 用索引,快!

-- 加 ANALYZE 真的执行一次,看实际耗时
EXPLAIN ANALYZE SELECT * FROM users WHERE username = 'tom';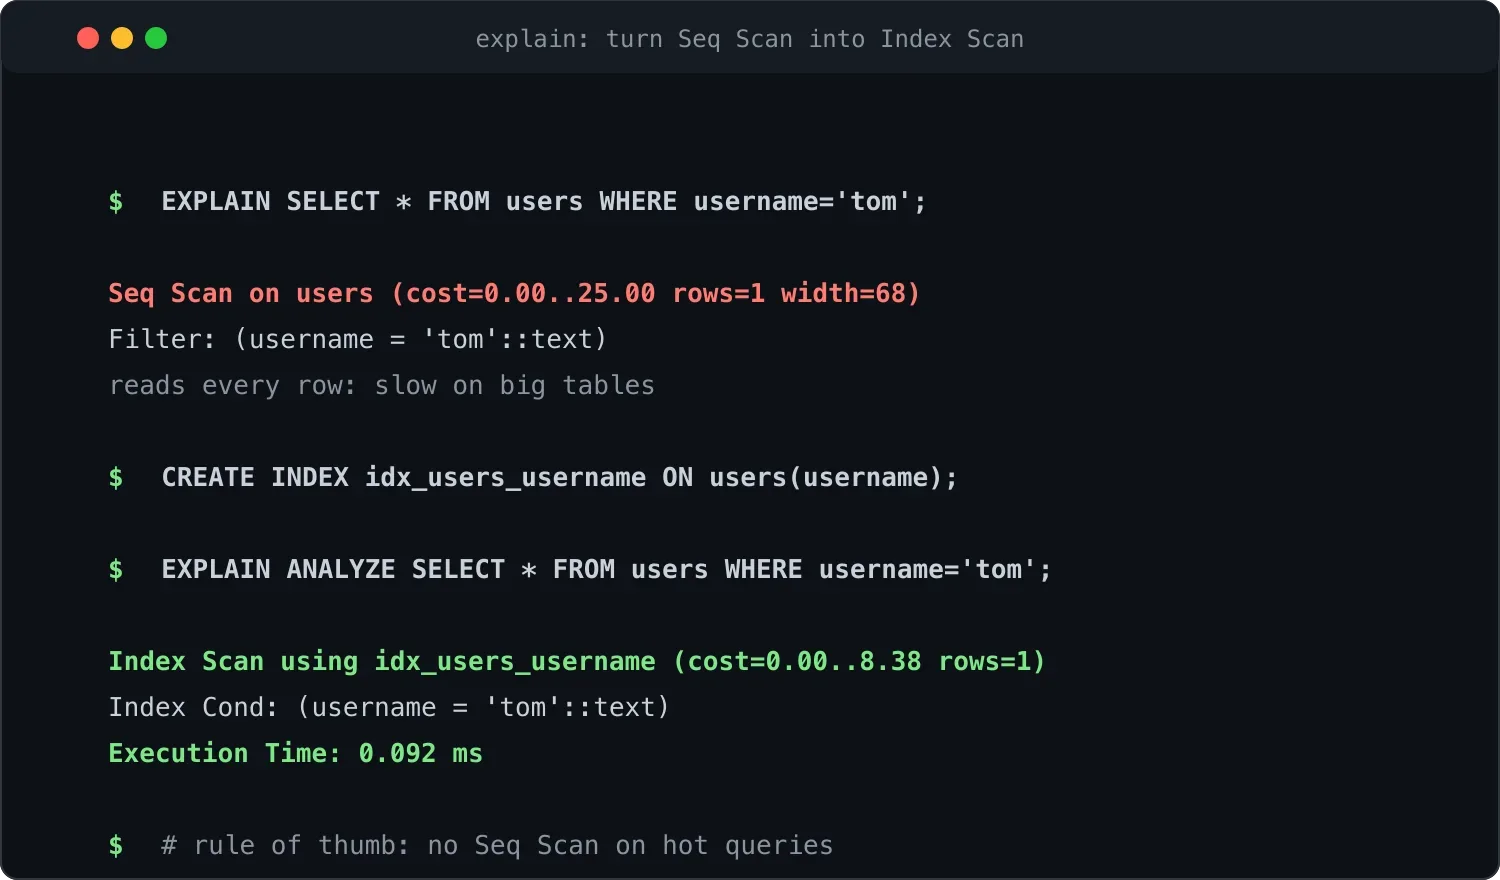
看 EXPLAIN 的核心:找 Seq Scan,把它变成 Index Scan。
七、Redis 缓存:让高频查询再快 10 倍
7.1 为什么需要缓存?
数据库再快也有极限(毫秒级)。如果一个查询被调用一万次/秒,每次都查数据库,数据库会被打爆。
解法:把热点数据放在内存里(Redis),查询先查内存,没有再查数据库,查到后写回缓存。
7.2 Redis 上手
# Docker 一键启动
docker run -d --name my-redis -p 6379:6379 redis:7# 命令行连进去玩
docker exec -it my-redis redis-cli
# 基础命令
SET name "tom" # 存字符串
GET name # 取
DEL name # 删
SET count 0
INCR count # 自增(原子操作,限流必备)
EXPIRE count 60 # 60秒后过期
# 哈希(存对象)
HSET user:1 name tom age 25
HGET user:1 name
HGETALL user:17.3 Python 用 Redis 做缓存
pip install redisimport redis
import json
import psycopg2
r = redis.Redis(host="localhost", port=6379, db=0, decode_responses=True)
def get_user(user_id):
# 1. 先查缓存
cache_key = f"user:{user_id}"
cached = r.get(cache_key)
if cached:
return json.loads(cached) # 缓存命中,直接返回
# 2. 缓存没有,查数据库
conn = psycopg2.connect(...)
cur = conn.cursor()
cur.execute("SELECT id, username, email FROM users WHERE id = %s", (user_id,))
row = cur.fetchone()
cur.close()
conn.close()
if not row:
return None
user = {"id": row[0], "username": row[1], "email": row[2]}
# 3. 写入缓存,设置过期时间(防止数据不一致太久)
r.setex(cache_key, 300, json.dumps(user)) # 5 分钟过期
return user7.4 Redis 在 AI 应用里的典型用法
| 用途 | 命令 | 例子 |
|---|---|---|
| 缓存高频问答 | SET/GET | 同一个问题别问两次大模型(省钱) |
| 限流 | INCR + EXPIRE | "用户 1 分钟最多调 10 次 API" |
| 会话存储 | SET | 存用户的对话上下文(多轮对话) |
| 异步队列 | LPUSH/RPOP | 把"待解析的 PDF"放进队列慢慢处理 |
| 排行榜 | ZADD/ZREVRANGE | "热门问题 Top 10" |
重点讲限流(AI 应用必备,防烧钱):
def check_rate_limit(user_id, max_calls=10, window=60):
    """每分钟最多调 max_calls 次"""
    key = f"rate:{user_id}"
    count = r.incr(key)
    if count == 1:
        r.expire(key, window)   # 第一次访问,设置窗口
    if count > max_calls:
        return False    # 超限
    return True
八、本章小结
- 关系型数据库用表格存数据,表之间靠外键关联,SQL 是和它对话的语言。
- SQL 四大类:DDL(建表)、DML(增删改)、DQL(查询,最常用)、DCL(权限)。
- SELECT 是灵魂,掌握 WHERE / ORDER BY / LIMIT / JOIN / GROUP BY 能干 80% 的活。
- PostgreSQL 是 AI 工程师首选(pgvector 向量库就长在它上面)。
- 用 DBeaver/TablePlus 这种 GUI 工具管理数据库,效率更高。
- 永远用参数化查询防 SQL 注入,永远给 UPDATE/DELETE 加 WHERE。
- 索引让查询快 100 倍,但会拖慢写入;复合索引遵循"最左前缀"原则。
- EXPLAIN 是看慢查询的利器,目标是把 Seq Scan 变成 Index Scan。
- Redis 缓存让高频查询快 10 倍,AI 应用里常用于缓存问答、限流、会话、队列。
九、动手练习
练习 1(基础):用 Docker 启动 PostgreSQL,建一个 todos 表(id, text, done, created_at),手动插入 5 条数据。
练习 2(联调):把你练手项目里的待办清单后端(内存数组版)改成连 PostgreSQL,重启后端,数据应该还在。
练习 3(进阶):给你的 articles 表加上合理的索引,然后写一个慢查询(不带 WHERE 的 LIKE),用 EXPLAIN 看看执行计划。再改成带索引的查询,对比 EXPLAIN 输出。
练习 4(缓存):给"获取文章详情"接口加 Redis 缓存,缓存 5 分钟。打印日志看命中率(命中了几次,没命中几次)。
十、延伸阅读
- PostgreSQL 官方文档:https://www.postgresql.org/docs/
- Redis 命令速查:https://redis.io/commands/
- 书:《数据库系统概念》,经典教材,想深入必读
- 书:《高性能 MySQL》,索引和优化的经典,PostgreSQL 也通用
- B 站搜「PostgreSQL 教程」「Redis 入门」有大量免费课
数据库只是应用的地基。再往上一层,Docker 负责把整个应用打包成开箱即跑的盒子,CI/CD 让代码推到仓库后自动测试、自动部署。这两块拼图凑齐,才有真正意义上的独立交付。