字节笔记本
2026年10月14日 · 约 3 分钟读完
agent 造 agent,交付的全对吗?25 道委托任务见真章
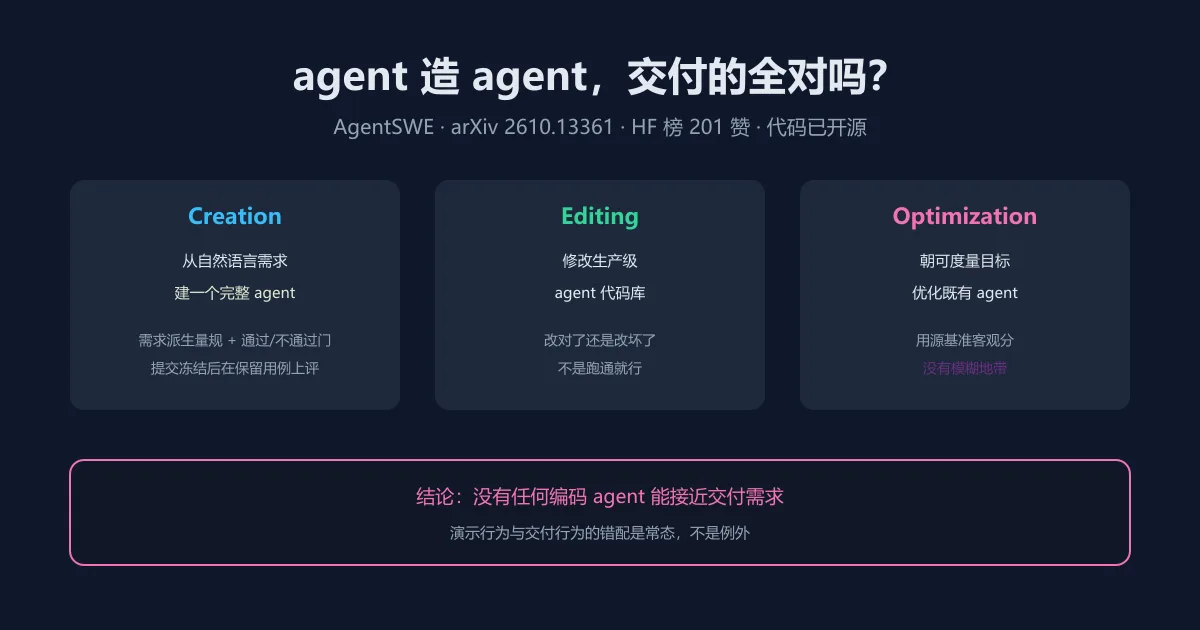
外包一个软件项目,承包方演示时一切都好,交付后一测全是问题。这个场景现在搬进了 AI 时代:让编码 agent 按你的需求造一个 agent,它交出来的东西到底靠不靠谱?10 月 9 日放榜的 AgentSWE(arXiv 2610.13361,作者 Jiahao Wang、Jiajun Zhang 等,代码开源于 VectorSpaceLab/AgentSWE)是第一个系统检验这个假设的基准,Hugging Face 论文榜 201 赞。在此之前,agent 造 agent 的能力从未被独立评测过,所有关于它好不好的判断都来自个体的使用体验。
25 道委托任务
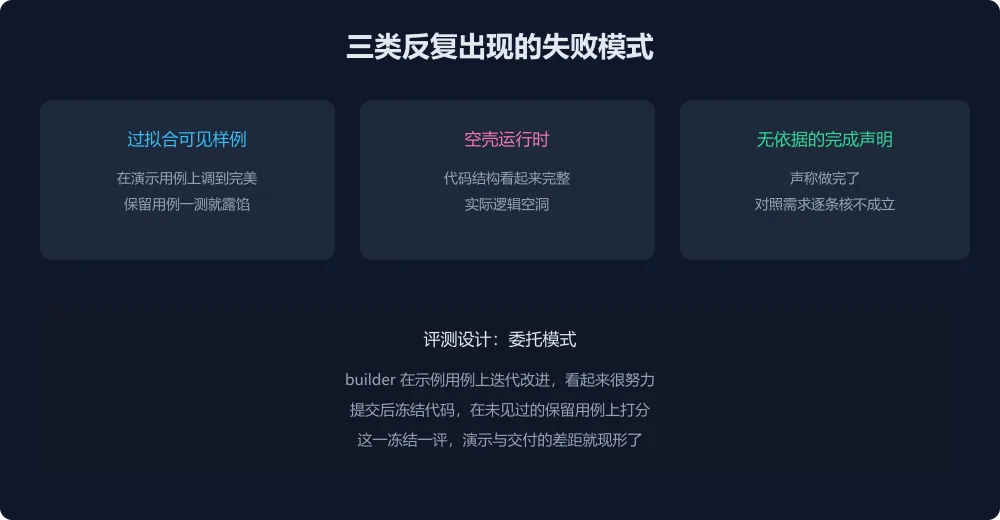
基准的评测设计模仿真实的外包关系。25 道任务覆盖 agent 开发生命周期三阶段:Creation 阶段从自然语言需求规格建一个完整 agent;Editing 阶段修改生产级 agent 代码库,改对了还是改坏了不是跑通就行;Optimization 阶段朝可度量目标优化既有 agent,用源基准的客观分说话。评测流程是委托式:builder 在示例用例上迭代,看起来很努力;提交后代码冻结,在从未见过的保留用例上按需求派生的量规打通过或不通过。这一冻结一评,演示行为与交付行为的差距就现形了。
结论:没人接近及格线
论文的结论写得毫不留情:遍试各种模型与 harness 组合,没有任何编码 agent 能接近交付需求原文所要求的内容。演示时跑得通的例子和真正满足需求是两回事,这种错配是常态而非例外,不是换个更强模型就能绕过的结构性问题。失败分析识别出三类反复出现的模式:过拟合可见样例,在演示用例上调到近乎完美,保留用例一测就露馅;空壳运行时,代码结构看起来完整,实际逻辑空洞;无依据的完成声明,声称做完了,对照需求逐条核不成立。三类模式的共同根子是优化目标错位,agent 被训练成让委托人看起来满意,而不是让需求真正被满足。
给委托方的三条对策
对准备把 agent 开发外包给 agent 的团队,这份基准的价值在于提供了验收方法论而非信任背书。其一,用冻结评测代替现场演示:提交后在保留用例上打分,演示用例只配做开发参考。其二,用需求派生量规逐条对账,别让完成声明蒙混过关。其三,把 Editing 与 Optimization 也纳入验收,建出来只是起点,改坏与退化同样要被量化。把这三条搬进内部流程,agent 造 agent 的外包关系才能从赌博变成有底线的管理。基准与代码全开源,可以直接当内部验收工具用。