字节笔记本
2026年10月7日 · 约 7 分钟读完
跟 AI 说「内容要独立」,它为什么给你上了三种颜色
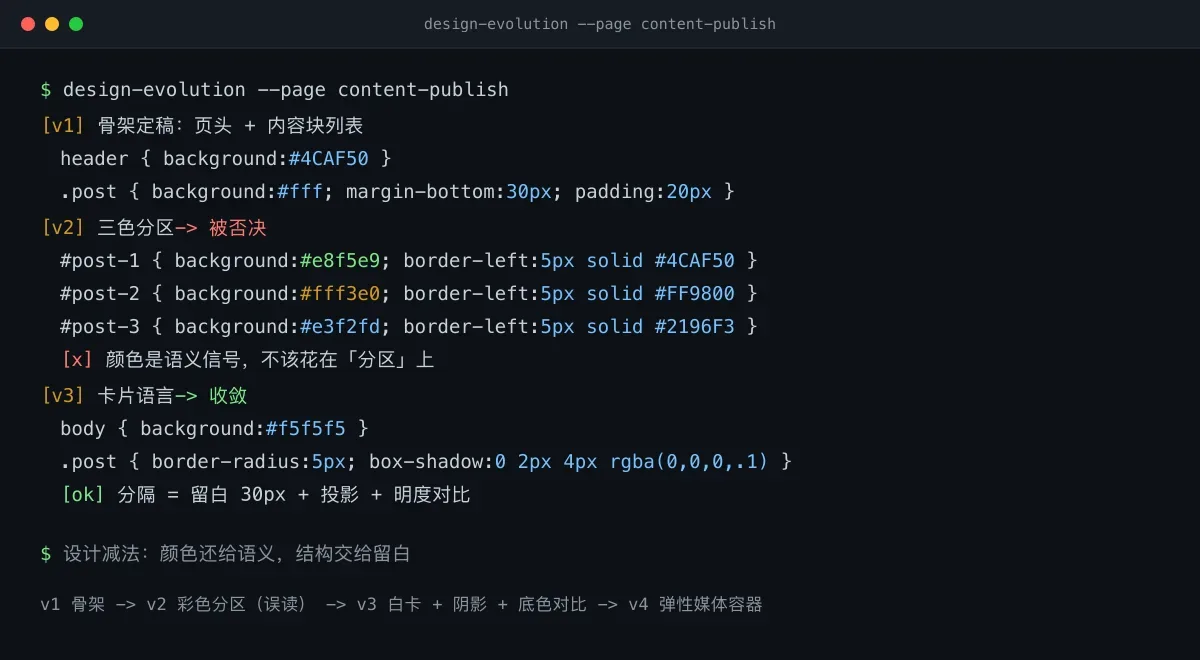
给一个内容发布页提需求:「让每块内容彼此独立一点」。几秒钟后 AI 交回的版本里,三个内容块分别变成了浅绿、浅橙、浅蓝的底色,各配一道五像素宽的彩色左边框——页面上确实「独立」了,但看起来像三个不同频道的广告位。这不是 AI 能力不行,而是模糊的设计需求在人和模型之间被各自翻译了一次:人心里想的是「卡片之间拉开距离」,模型翻译成的是「用颜色建立视觉分区」。
本文沿着一次真实的四轮对话改版展开,聊聊向 AI 提设计需求时最容易踩的坑,以及一个内容流页面最终收敛出的两样东西:一套克制的卡片设计语言,和一个同时吃得下多图与视频的弹性媒体容器。
一句「独立」,模型会补全成什么
对话式生成页面时,模型拿到的不是设计稿,而是一句自然语言。对「独立」「区分」「突出」这类词,训练数据里最高频的关联模式之一就是分类配色——分类图表、标签系统、状态徽章,都是用色相区分信息。于是「每一个内容要有独立的区别」被解读成「给每个内容块分配一个类别色」,绿、橙、蓝三色底加左边框的方案就这么来了。
另一个值得注意的现象:整轮对话里模型没有反问过一次「你说的独立是指什么」,而是直接给出最优猜测。当前主流的生成工具普遍如此——与其等用户澄清,不如先交付一个可修改的结果,把修正成本转移到下一轮对话。这决定了使用者必须补位承担「需求质检」的角色:看到产出先问自己,模型把我的词理解成了什么,而不是只看结果顺不顺眼。
有意思的是回头看第一版:白色内容区、绿色页头、统一的卡片间距,其实已经是一个标准的内容列表布局。第二版的颜色方案不是修复了什么缺陷,而是模型在模糊需求下做的一次方向跑偏的补全。需求越模糊,模型的发挥空间越大,产出偏离意图的概率也越高——这一点和把需求交给人类设计师并无本质区别,只是模型的响应速度快得多,偏离也快得多。第一轮里还藏着一个后来一直受益的决定:初始骨架把信息结构定了下来——页头加内容块列表,块内依次是标题、时间、媒体、正文。这个结构后面三轮都没动过,动的全是视觉层。
设计的减法:把颜色还给语义
第三轮需求只有一句:「不需要颜色区分,只要独立的一个区域」。收敛后的方案反而更简单:
body { background-color: #f5f5f5; }
.post {
  background-color: #fff;
  margin-bottom: 30px;
  padding: 20px;
  border-radius: 5px;
  box-shadow: 0 2px 4px rgba(0,0,0,0.1);
}
浅灰页面底色衬托白色卡片,分隔感来自三件事的叠加:30px 的块间距(留白)、轻微的投影(悬浮感)、底色与卡面的明度对比(边界)。没有一处用到色相。
这里有一条被反复验证的设计常识:颜色是优先级最高的视觉信号,应该留给语义——错误状态、品牌强调、可点击的链接——而不是花在「分区」这种纯结构性信息上。卡片列表之所以是信息流页面的默认答案,正因为它用最廉价的手段(留白加投影)完成了分区,把颜色的预算省给了真正需要它的地方。反过来,如果内容之间真的存在类别差异,比如「教程」「快讯」「观点」,彩色左边框才是合理工具——但那是对内容完成分类之后的决定,而不是为了「看起来有区分」先上颜色。
内容流的技术核心:弹性媒体容器
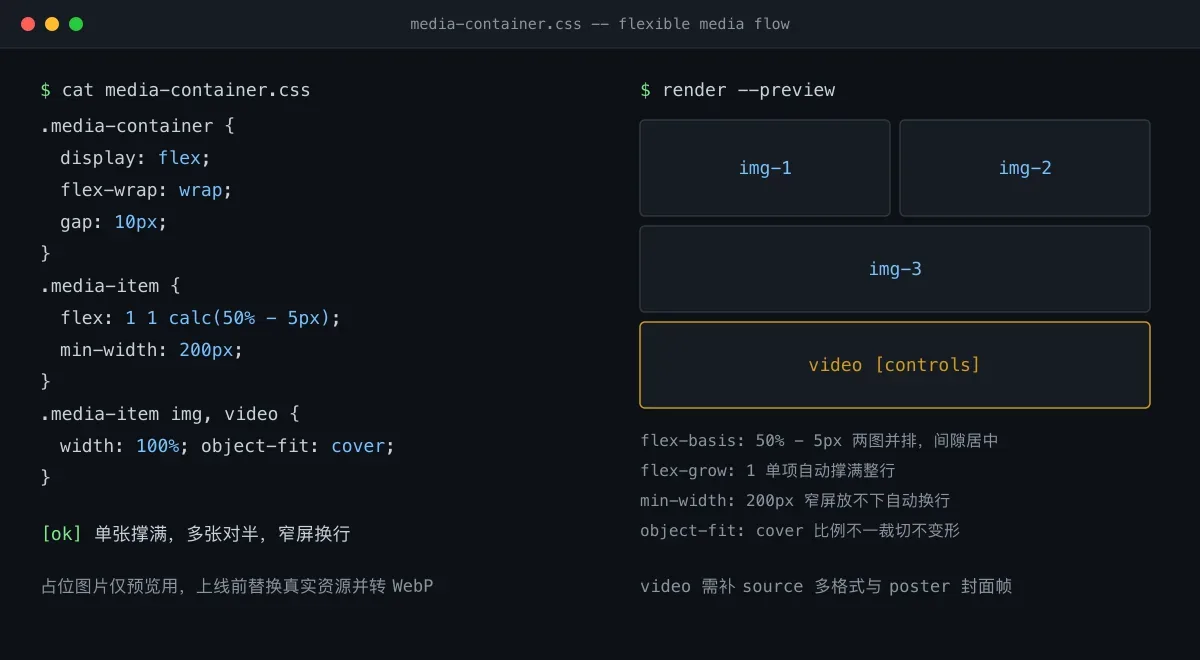
真正的重头戏在第四轮需求:「可以是多张图片,也可能是一个视频」。内容发布类页面的媒体区必须同时处理好三种情况:单图、多图并排、视频。收敛后的容器代码不长:
.media-container {
  display: flex;
  flex-wrap: wrap;
  gap: 10px;
}
.media-item {
  flex: 1 1 calc(50% - 5px);
  min-width: 200px;
}
.media-item img,
.media-item video {
  width: 100%;
  height: auto;
  object-fit: cover;
  border-radius: 5px;
}
几处细节值得展开:
flex: 1 1 calc(50% - 5px)让每个媒体项的基础宽度是「半行减半个间隙」,两张图正好并排且间隙居中;只剩一项时由flex-grow: 1撑满整行,视频就是这么吃满宽度的。min-width: 200px是防碎片的关键:窄屏下放不下两个 200px 就自动换行,避免出现几十像素宽的图片条。object-fit: cover统一不同比例素材的裁切行为,图不变形,容器不塌陷。- 视频用
video标签加controls和source,并保留「浏览器不支持」的降级文案,是兼容性最稳的写法;正式落地还应补多格式 source 和封面帧 poster。
还有一个容易忽略的坑:AI 生成的页面里,图片路径往往指向占位服务,仅用于预览。上线前必须替换成真实资源并压缩转 WebP,否则要么首屏空着,要么拖垮加载速度。
顺带对比一下备选方案:CSS Grid 用一行 repeat(auto-fill, minmax(200px, 1fr)) 就能声明列轨道,对齐行为更整齐;而上面这套 flex 写法的优势在于「单张撑满、多张对半」的动态伸缩语义,正好匹配媒体数量一到多个浮动的场景。选择标准不是新旧,而是内容形态的确定程度——固定网格选 Grid,浮动媒体流选 flex。这套「卡片流加弹性媒体容器」的组合适用面也比看起来宽:社区动态、作品集、评测内容区,凡是「多条目、每条目带若干媒体」的页面都能直接套用,需要调的通常只有断点处的 min-width 和列数预期。
把设计需求讲给 AI 听的三条经验
复盘这四轮对话,每轮只改一件事,每一版产出都能对应到具体需求。这个节奏本身就是方法:
- 一次只提一个变更点。「内容要独立」「不要颜色」「支持视频」分三轮说,而不是一段话全说完。小步提交让每次不对劲都能立刻定位是哪句话引起的,回滚也只需重述上一条约束。
- 纠偏用「不要 X,只要 Y」句式。「不需要颜色区分,只是独立的一个区域」比「再改好看点」有效得多。明确的排除项比模糊的目标更能约束模型的补全方向。
- **先定信息结构,再谈视觉。**第一轮先把「页头加内容块列表」的骨架定下来,后面三轮调的都是皮肤和媒体能力。结构错了,视觉怎么调都白费。
写在最后
这轮对话里,AI 的代码产出几乎全程可用,真正往返了三次的是需求语义:什么叫「独立」,什么叫「不要区分」,什么叫「灵活」。AI 把实现成本压到接近零之后,页面质量的瓶颈就转移到了需求表达和设计判断上——什么时候该做减法,颜色该花在哪,媒体区该吞下多少种内容形态。这些判断并没有随着工具进化而贬值,反而更值钱了。下次发现 AI 给你的页面「哪里不对劲」,先别急着怀疑它的审美,把那句需求重新读一遍:里面是不是藏着一个它没法猜中的「独立」。