字节笔记本
2026年10月6日 · 约 25 分钟读完
2026 年如何成为 AI 工程师:不需要 CS 学位
大多数人以为做 AI 必须有计算机科学学位。不需要。
最近海外技术社区有一篇讲 2026 年 AI 工程师职业路径的长文流传很广,观点和我不谋而合。它不是那种"劝退文",也不是"速成鸡汤"。我想把一个事实说清楚:2026 年的 AI 工程师岗位,本质上是软件工程 + 产品能力 + 和已有模型打交道。 它奖励的不是学历,是交付能力。
原文里有一句话我特别认同:
"The AI engineer takes models that already exist and builds useful things with them. That work rewards software skill, product sense, and shipping discipline."
翻译一下:AI 工程师做的事是拿现成的模型造有用的东西。这份工作奖励的是软件能力、产品感觉、和持续交付的纪律。
不是搞研究。不是发论文。不是从头训练模型。
是造东西,解决真实问题,让产品上线。
先纠正一个认知偏差
很多人对 AI 工程师有一个错误画像:坐在实验室里调参数、写数学公式、用 PyTorch 从零搭 Transformer。
这是 AI Researcher,不是 AI Engineer。
Flatiron School 的 2026 行业报告给了一个很实在的比例:
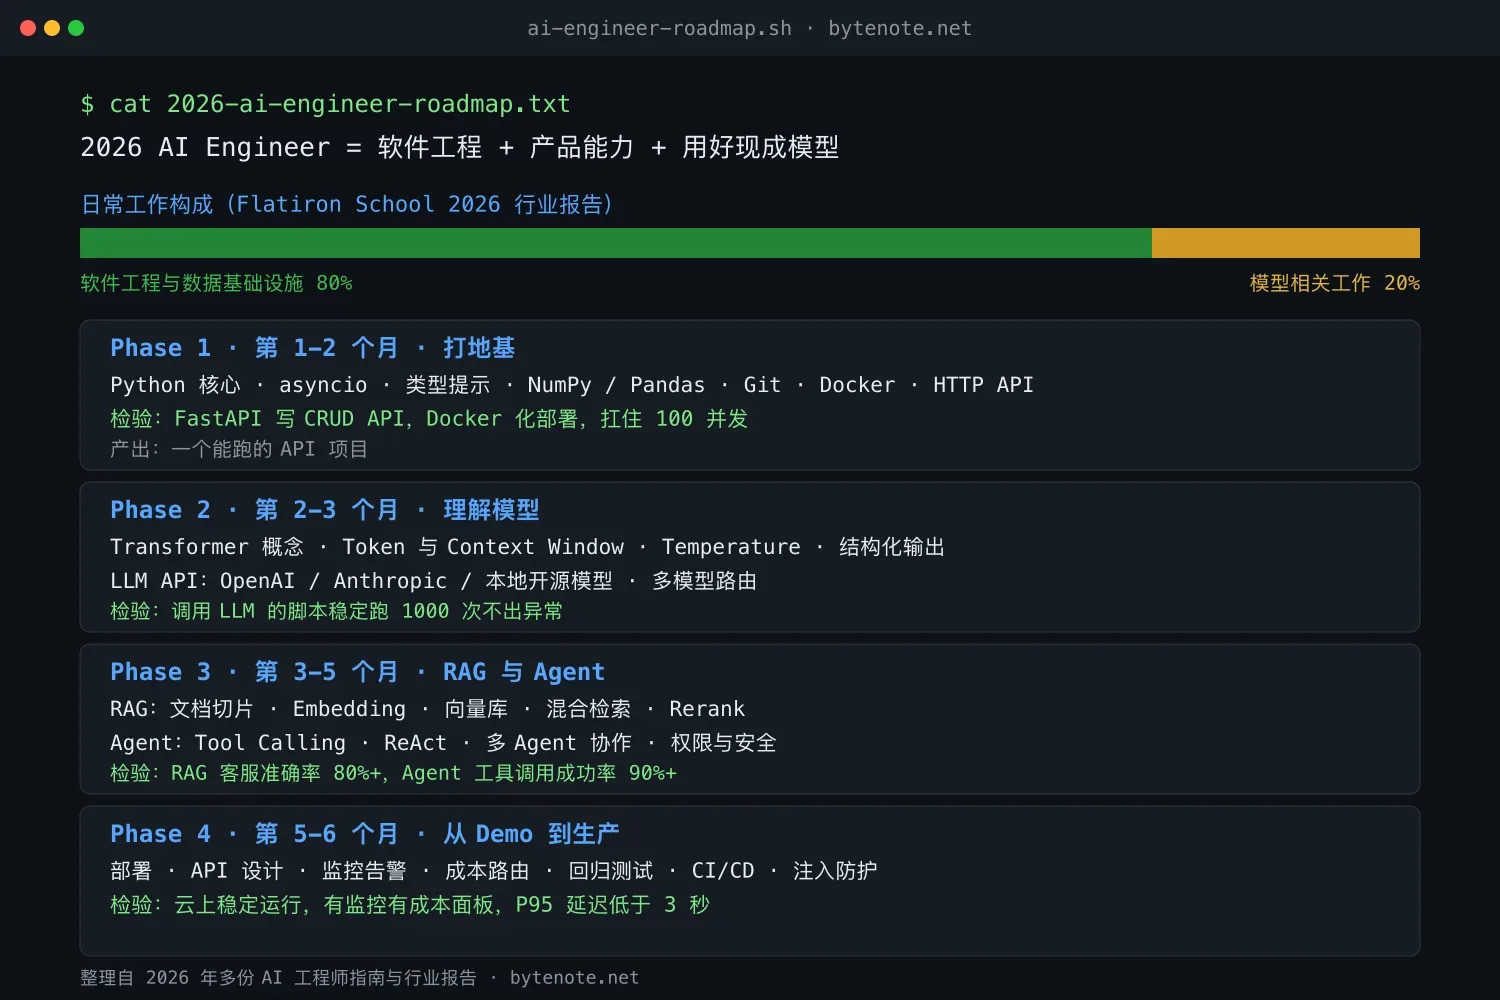
AI 工程师日常工作的大约 80% 是软件工程和数据基础设施,只有大约 20% 是直接和模型打交道。
这意味着什么?意味着如果你已经会写代码,你已经完成了这个岗位 80% 的技能要求。
AI 工程师的薪资现实
在聊怎么学之前,先看看市场给什么价。2026 年美国的 AI 工程师薪资(参考多个来源交叉验证):
| 级别 | 经验 | Base Salary | 总包(含股权) |
|---|---|---|---|
| Junior | 0-2 年 | $120K–$170K | $150K–$220K |
| Mid-level | 3-5 年 | $170K–$240K | $230K–$380K |
| Senior | 5 年+ | $250K+ | $300K–$500K+ |
Senior Agentic AI Software Engineer(会做 AI Agent 系统的)在 2026 年的招聘市场上尤其紧俏,岗位挂出的 base 在 $250K–$300K + equity。
原文提到的真实路径是:先做一个 AI-augmented 的软件工程师,再转成完整的 AI 工程师。 不是一上来就找 AI Engineer 岗位,而是先在现有岗位上加入 AI 能力,然后带着真实的 AI 交付经验跳过去。
这条路更现实,也更赚钱。
六个月路线图:从写代码到做 AI
以下是我结合这篇长文的路线图、Towards AI 的四阶段模型、Data Science Collective 的实践路线,以及我自己带团队、招人的经验,整理出的一个六个月学习路径。
前提:你会基本的 Python。 不会的话,在 Phase 1 多花两周补上。
Phase 1:打地基(第 1-2 个月)
目标:能写 production-quality 的 Python 代码。
很多人跳过这步直接去学 LLM API 调用。这是个错误。AI 系统出的问题,90% 不是模型的问题,是工程的问题:内存泄漏、并发没处理好、数据库连接池没配、错误没兜住。
你需要会的:
Python 核心
├── 基本语法(不需要精通 OOP 设计模式)
├── 数据结构(list, dict, set, 怎么选)
├── 异步编程(asyncio, aiohttp — 这点极其重要)
├── 类型提示(TypeHints — AI 代码协作的基础)
└── 包管理(uv 或 poetry)

数据处理
├── NumPy 基础(数组操作)
├── Pandas(DataFrame 读、洗、写)
└── JSON 处理(API 数据的标准格式)

工程基础
├── Git(branch, PR, code review)
├── Docker 基础(写 Dockerfile,docker compose up)
├── 基本的 Linux 命令行
└── HTTP API 设计(REST,理解 status code)
推荐资源:
- Python:Python for Everybody (Coursera) 或 Corey Schafer 的 YouTube 频道
- 异步编程:FastAPI 官方文档的异步章节,比任何教程都好
- Docker:Docker 官方 Get Started 教程
Phase 1 的检验标准: 你能用 FastAPI 写一个 CRUD API,Docker 化部署,能处理 100 并发请求不崩。不需要完美,但要能跑。
Phase 2:理解模型(第 2-3 个月)
目标:不需要你从头训练模型,但你需要理解模型在干什么。
原文把这个阶段叫 "Master the LLM"。我觉得更准确的说法是:理解 LLM 的能力边界,知道什么它擅长、什么它不擅长。
你需要会的:
LLM 基础
├── Transformer 架构(不需要从数学推导,但要知道 attention 是什么)
├── Token 和 context window(为什么有长度限制,超了怎么办)
├── Temperature, top_p, top_k(调参不是玄学,知道在调什么)
└── System prompt vs User prompt(谁优先级高,为什么)

Prompt Engineering
├── Few-shot vs Zero-shot
├── Chain-of-Thought(CoT)
├── 结构化输出(JSON mode — 生产环境必备)
└── Prompt 模板管理(提示词版本控制)

调用 LLM API
├── OpenAI API(GPT-4o / GPT-4.1)
├── Anthropic API(Claude 4)
├── 开源模型本地调用(ollama, vLLM)
└── 多模型路由(什么时候用哪个模型)
关键认知: 你不需要知道怎么从头搭一个 Transformer。你需要知道的是:给模型什么输入、能得到什么输出、什么情况下输出不可靠、怎么兜底。
推荐资源:
- Anthropic 的 Prompt Engineering Interactive Tutorial(免费,动手做)
- OpenAI Cookbook(GitHub)
- Hugging Face NLP Course(免费)
Phase 2 的检验标准: 你能写一个脚本,接收用户输入 → 构建 prompt → 调用 LLM → 解析结构化输出 → 错误重试。这个流程能稳定跑 1000 次不出异常。
Phase 3:造轮子,RAG 与 Agent(第 3-5 个月)
目标:能用 LLM 解决实际问题,而不是只会调 API。
这是 2026 年 AI 工程师最核心的技能区间。两个方向:RAG(检索增强生成)和 Agent(自主决策执行)。
RAG 方向
RAG Pipeline
├── 文档处理(PDF/HTML/Markdown → chunks)
├── Embedding(文本 → 向量)
├── 向量数据库(ChromaDB, Pinecone, Weaviate)
├── 检索策略(语义检索 + 关键词检索混合)
├── Reranking(重排序提高相关性)
└── 上下文注入(把检索结果塞进 prompt)
一个最小的 RAG 系统:
from openai import OpenAI
from chromadb import Client

client = OpenAI()
chroma = Client()

# 1. 存储文档
documents = [
    "我们的退款政策:购买后 30 天内可无理由退款",
    "客服工作时间:周一到周五 9:00-18:00",
    "VIP 用户享受 9 折优惠,满 1000 元免运费",
]
collection = chroma.create_collection("docs")
for i, doc in enumerate(documents):
    collection.add(documents=[doc], ids=[str(i)])

# 2. 检索 + 生成
def ask(question):
    results = collection.query(query_texts=[question], n_results=2)
    context = "\n".join(results["documents"][0])

    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": f"根据以下公司政策回答问题:\n{context}"},
            {"role": "user", "content": question}
        ]
    )
    return response.choices[0].message.content
这就是 RAG 的最小可用形态。生产环境需要加的东西:chunk 策略优化、混合检索、reranking、缓存、监控,但核心逻辑就这么简单。
Agent 方向
Agent 系统
├── Tool Calling(让 LLM 调用外部工具/API)
├── ReAct 模式(思考 → 行动 → 观察 → 循环)
├── Agent 框架(LangGraph, CrewAI, 或自己实现)
├── 多 Agent 协作(主 Agent + 专业子 Agent)
└── Agent 安全(权限控制、输出校验、人类审批)
一个最小的 Agent(不用框架):
import json

def run_agent(query, tools):
    tools_desc = "\n".join([
        f"- {t['name']}: {t['description']}"
        for t in tools
    ])

    messages = [
        {"role": "system", "content": f"你可以使用以下工具:\n{tools_desc}\n\n"
         "用 JSON 格式回复工具调用:{{\"tool\": \"name\", \"args\": {{...}}}}"},
        {"role": "user", "content": query}
    ]

    while True:
        response = client.chat.completions.create(
            model="gpt-4o",
            messages=messages,
            response_format={"type": "json_object"}
        )

        result = json.loads(response.choices[0].message.content)

        if "tool" not in result:
            return result.get("answer", response)

        # 执行工具
        for tool in tools:
            if tool["name"] == result["tool"]:
                output = tool["execute"](**result["args"])
                messages.append({"role": "assistant", "content": json.dumps(result)})
                messages.append({"role": "user", "content": f"工具返回:{output}"})
                break
70 行代码,一个能调用工具、循环推理的 Agent。不需要 LangChain,不需要 CrewAI。
我建议你在 Phase 3 至少实现一次不依赖框架的 RAG 和不依赖框架的 Agent。不是因为框架不好,而是因为理解底层机制才能在出问题时知道怎么修。
推荐资源:
- LangChain 官方文档(学概念,但不要一开始就依赖它)
- LangGraph(做 Agent 状态机最好用)
- Lilian Weng 的博客 LLM Powered Autonomous Agents(Agent 系统设计的经典参考)
Phase 3 的检验标准: 你能做一个 RAG 客服机器人,吃进公司文档、回答客户问题、准确率在 80% 以上。或者你能做一个 Agent,帮用户查天气、订餐厅、发邮件,工具调用成功率在 90% 以上。
Phase 4:工程化,从 Demo 到生产(第 5-6 个月)
目标:你的 AI 系统能在真实流量下稳定运行。
这是拉开差距的阶段。会调 API 的人满大街都是,能把 AI 系统工程化部署的人稀缺。
工程化能力
├── 部署(Docker + K8s 或 Vercel/Fly.io/Render)
├── API 设计(版本管理、限流、认证)
├── 监控(LLM 调用延迟、token 消耗、错误率)
├── 成本控制(模型选择策略:简单任务用便宜模型)
├── 测试(prompt 回归测试、golden dataset)
├── CI/CD(自动部署、自动测试)
└── 安全(prompt injection 防护、PII 过滤)
一个生产级的成本控制策略:
def route_request(query, complexity_score):
    """根据请求复杂度路由到不同模型"""
    if complexity_score < 3:
        # 简单问题:用便宜模型
        return "gpt-4o-mini"  # $0.15/1M input tokens
    elif complexity_score < 7:
        # 中等复杂度
        return "claude-3-5-haiku"  # 性价比最优
    else:
        # 复杂推理
        return "claude-sonnet-4-20250514"  # $3/1M input tokens
这个策略能帮你把 LLM API 成本降低 60-80%。简单问题不需要用最贵的模型。
推荐资源:
- Anthropic: Effective context engineering for AI agents(工程化 AI Agent 的必读)
- OpenAI 的 Production best practices
Phase 4 的检验标准: 你的 AI 应用部署在云上,有域名、有监控、有错误告警、有成本面板。能扛住 1000 QPS(或者你的实际业务流量),P95 延迟 < 3 秒。
跳板策略:先成为 AI-augmented 软件工程师
原文里最实用的建议是这条:
"The realistic entry path is often an AI-augmented software engineering role first, then a full AI engineer role."
翻译:现实的路径是先做一个"AI 增强型"软件工程师,再转成完整的 AI 工程师。
如果你现在是一个后端工程师、前端工程师、全栈工程师,不要辞职去学 AI 然后从零找 AI Engineer 岗位。那太低效了。
在你现有的岗位上加入 AI 能力:
你现在做什么          →  加入什么 AI 能力
──────────────────────────────────────────
写 CRUD API           →  加一个 AI 辅助的数据校验层
做前端页面            →  加一个 AI Chat 组件
维护数据管道          →  加一个 AI 异常检测
写自动化测试          →  用 LLM 生成测试用例
做 DevOps             →  加一个 AI 驱动的日志分析
三到六个月后,你的简历上就不是"软件工程师"了,而是"有 AI 交付经验的工程师"。跳槽到 AI Engineer 岗位时,你拿的是真实的、上线的 AI 项目,不是培训班的项目作业。
2026 年 AI 工程师的核心技能树
根据我的观察和多个 2026 薪资报告的交叉验证,以下是当前市场最看重的技能,按重要性排序:
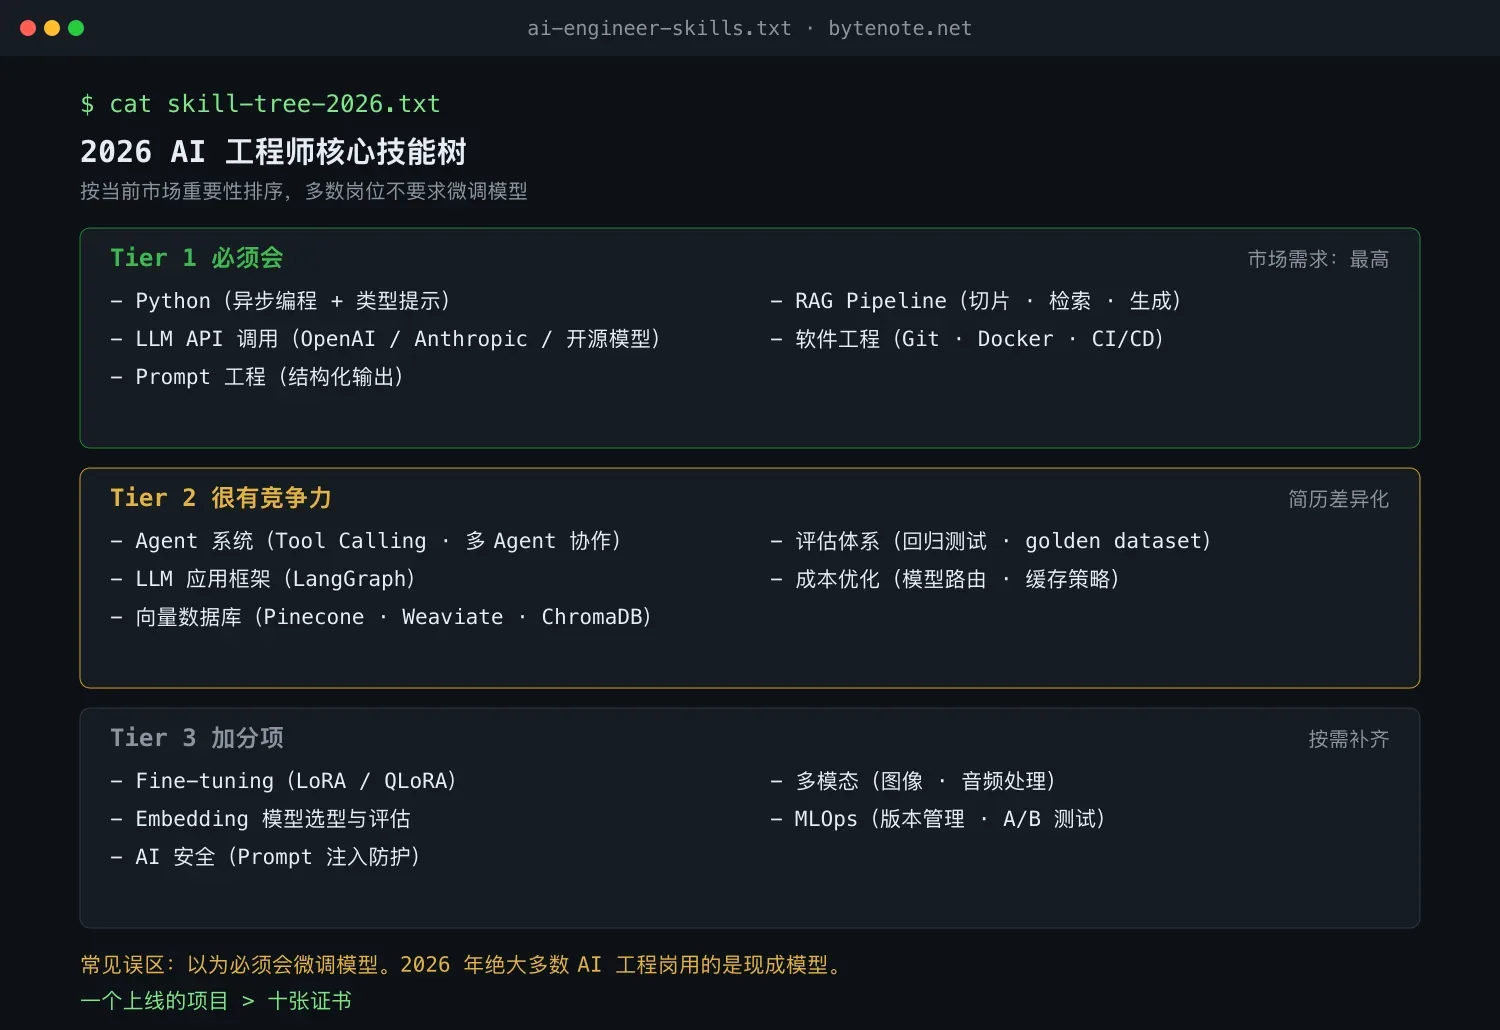
- Tier 1(必须会):Python 异步编程与类型提示、LLM API 调用、Prompt 结构化输出、RAG Pipeline、Git/Docker/CI/CD 等软件工程能力
- Tier 2(很有竞争力):Agent 系统、LangGraph 等应用框架、向量数据库、评估体系、成本优化
- Tier 3(加分项):Fine-tuning(LoRA/QLoRA)、Embedding 模型选型和评估、AI 安全、多模态、MLOps
注意 Fine-tuning 在 Tier 3。这是很多人理解上的误区:以为 AI 工程师必须会微调模型。实际上 2026 年的绝大多数 AI 工程岗位不需要你微调模型。 你需要的是会用现成模型解决实际问题。
我不推荐的学习路径
最后说说几个坑,都是我见过太多人踩的:
- 一上来学数学。 线性代数、概率论、微积分,如果你是从零开始,先不要碰这些。它们对 AI Researcher 重要,对 AI Engineer 不重要。等你需要用到的时候再补。
- 花三个月学 PyTorch 从头训练模型。 2026 年 AI 工程师的核心工作不是训练模型,是用模型造产品。除非你的目标是 AI Researcher,否则这三个月的 ROI 极低。
- 依赖框架而不理解底层。 LangChain、CrewAI、AutoGen,先用,但要理解底层在干什么。框架会过时,底层原理不会。我见过太多人在 LangChain API 改了之后手足无措,因为他们从来不理解 RAG 的检索逻辑本身。
- 追求证书而不是项目。 Google 的 AI 证书、AWS 的 ML 证书,不是没价值,但面试官看的是你的 GitHub、你的 demo、你能讲清楚你造的东西。一个上线的项目 > 十张证书。
- 花太多时间在"学"而不是"造"。 最好的学习方式是造东西。每学一个概念,立刻做一个最小的 demo。Phase 1 结束时你应该有一个 API;Phase 2 结束时你应该有一个能调用 LLM 的工具;Phase 3 结束时你应该有一个 RAG 或 Agent demo;Phase 4 结束时你应该有一个部署在云上的 AI 应用。
别等"学完再开始做"。永远学不完。边做边学。
参考来源:
- How to Become a $1.5 Million AI Engineer in 2026(Towards AI)
- How I Would Become an AI Engineer in 2026 If I Had to Start Over(Data Science Collective)
- AI Engineer Salary Guide 2026(AYAutomate)
- From Non-Technical to AI Engineer(Flatiron School)
- Effective context engineering for AI agents(Anthropic)
- X 平台长文《How To Become An AI Engineer in 2026 (Without a CS Degree)》