字节笔记本
2026年10月7日 · 约 7 分钟读完
用 AI 把设计截图还原成 HTML:三轮迭代复盘
把一张界面截图丢给 AI,让它输出能用的 HTML,是现在前端和独立开发者最常做的尝试之一。它属于「设计转代码」这个老命题的新形态:过去要从 Figma 里逐层标注、按标注稿切图,现在一张截图就能起手,几分钟拿到可运行的页面,用来做原型验证、竞品分析或者和设计师对齐沟通都够用。很多人的预期是一次到位,实际体验往往是:结构大差不差,细节一塌糊涂。本文复盘一次典型的截图还原任务,目标是一个求职类 App 的个人中心页面,前后迭代三轮才达到可交付的还原度。三轮分别对应三个层次的修正:结构、细节、氛围。把这条路径看清楚,比背十条提示词模板更有用。
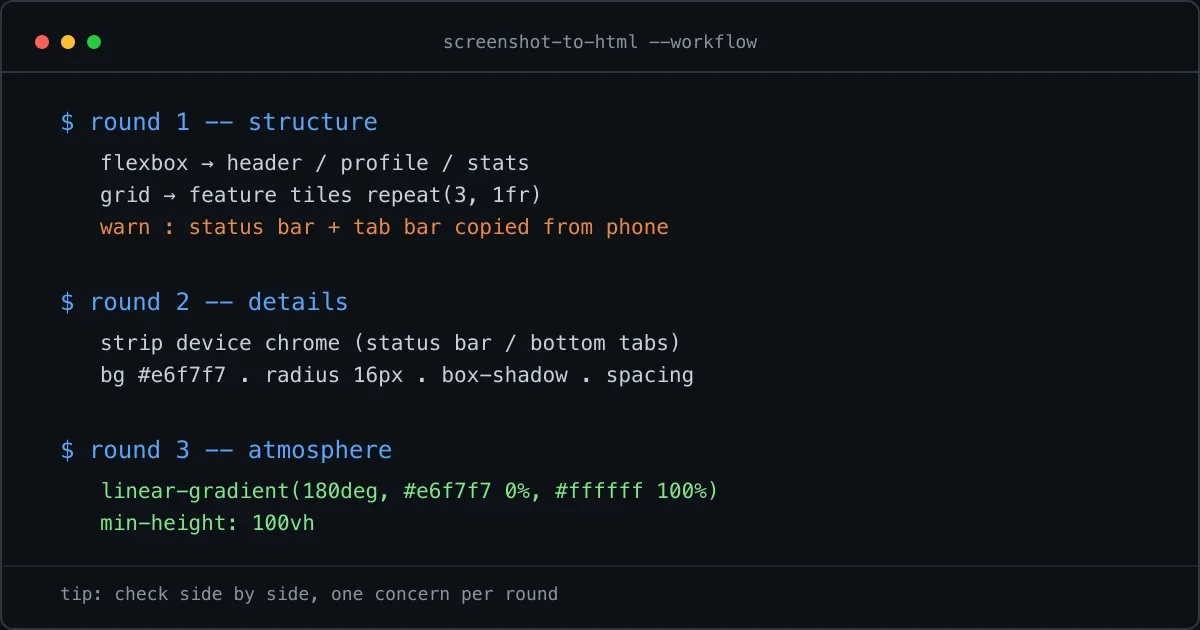
第一轮:要骨架,但 AI 会把「手机」也抄进来
第一轮的指令只有一句话:用 HTML 完成这个页面。AI 交出的第一版结构其实相当合格:
- 顶部用户信息区用 flexbox 做横向对齐,头像、昵称、等级、签到按钮各就各位;
- 收藏、投递、被查看、有意向四个数据项用 flex 均分;
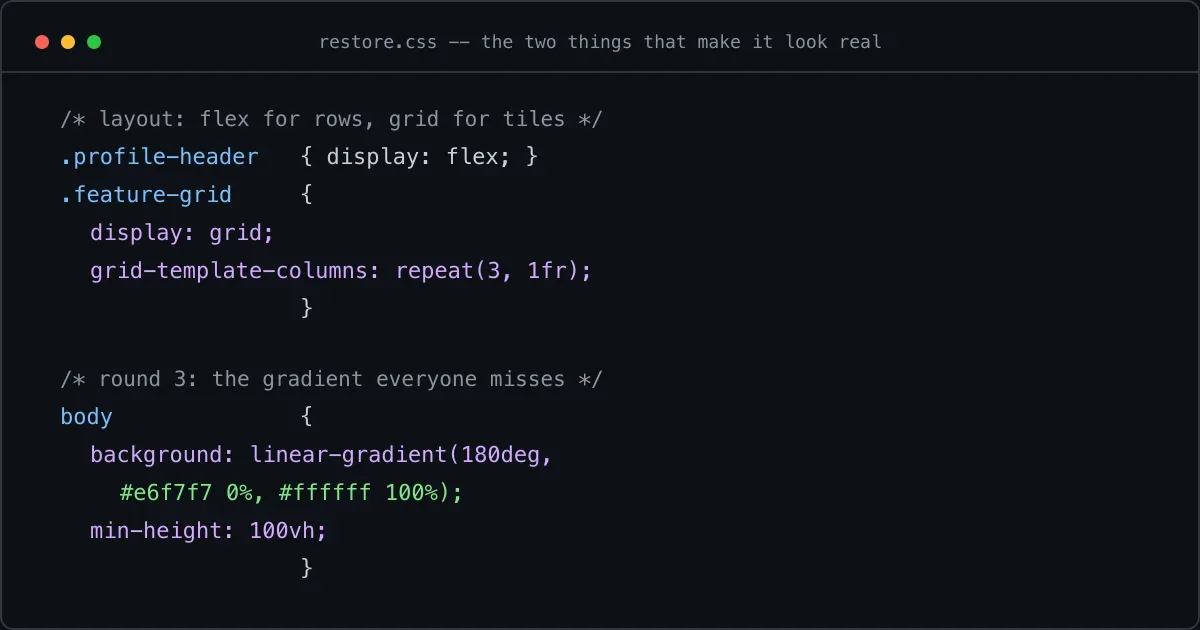
- 权益、常用功能、其他功能三组宫格用 CSS Grid 的 repeat(3, 1fr) 三等分;
- 移动端优先,样式内联在 style 标签里,单文件就能直接预览。
这版布局的分工本身值得说道:flex 擅长一维排列,一行里谁挨着谁、怎么对齐,交给它最省事;Grid 擅长二维切分,像宫格这种行列关系明确的结构,repeat(3, 1fr) 一句就等分完毕。AI 默认按这个常识分工,说明基础布局能力已经不是瓶颈。另一个容易被忽视的优点是它顺手写出了语义化的层级:卡片、分组标题、宫格项各自独立成块,后面无论是继续调样式,还是把整页拆成 React、Vue 组件,都有现成的结构可以依赖。第一轮的正确心态是接受粗粝,先让骨架立住。
真正的坑在别处:截图顶部的状态栏(时间、电量)和底部的五项 Tab 导航,被原样复刻成了页面元素。这不是能力问题,而是语义问题:AI 看到什么画什么,它并不知道哪些像素属于 App 内容,哪些属于手机系统外壳。这是截图还原的第一个决策点,设备 chrome 在 Web 版本里要不要出现?除非你做的就是一个手机演示页,答案通常是否定的。这个判断 AI 自己做不了主,必须由人来把关。
第二轮:剥离外壳,把细节抠回来
第二轮的修正有两层:去掉状态栏和底部 Tab,同时把还原精度提上来,尤其是配色。这一版的变化值得逐条看:
- 配色落地。第一版的背景只是随手一个浅色,第二轮明确取到截图的浅青色 #e6f7f7。实操上,用系统取色器或浏览器开发者工具的吸管在原图上点一下就能拿到色值。经验是,「注意还原背景色」这类要求要具体到点名色值,否则 AI 默认不会主动去采样。
- 卡片质感。白色卡片加了 16px 圆角和 box-shadow: 0 2px 10px rgba(0,0,0,0.1),视觉层次立刻从贴在纸上变成浮在桌面上。阴影的透明度控制在 0.1 左右是关键,太重会显脏。移动端信息流的层次感,主要就靠圆角和阴影这两件小事。
- 图标占位。真实图标没法从截图里抠出来,就用圆形色块加 emoji 字符顶位,先保布局、后换资产,最后统一替换成 iconfont 或 SVG。占位符保证结构成立,资产替换放到收尾,这是还原任务的标准节奏。
- 留白与字号。卡片间距、标题字号、等级标签的橙色,都逐项向原图靠拢,间距尽量落在 4 或 8 的倍数上,方便后续维护。
这一轮的共同点是:每项修正都把一个模糊的观感词翻译成了确定的数值。颜色是色值,圆润是像素,层次是阴影参数,呼吸感是间距。所谓「还原精度」,本质就是把这些数值逐个钉死。到这一版,页面已经看起来像了,但还差最后一层。
第三轮:最容易被漏掉的背景渐变
第三轮的反馈只有六个字:还缺少背景渐变。这是整次还原里最有教学价值的一轮。截图的背景并不是纯色,而是从顶部浅青色过渡到底部白色的纵向渐变,前两轮都把它压成了平涂色块。修正只需要两行 CSS:
body {
  background: linear-gradient(180deg, #e6f7f7 0%, #ffffff 100%);
  min-height: 100vh;
}
min-height: 100vh 在这里不是装饰。body 的高度默认由内容撑开,如果内容不足一屏,渐变只覆盖到内容底部,下方会露出突兀的断色;加上 min-height,渐变至少铺满整个视口,内容超出一屏时则随内容自然拉伸。如果希望渐变固定占满视口、不随滚动变化,可以改用 background-attachment: fixed。另外在移动端浏览器里,100vh 会把地址栏算进高度导致底部被裁,如今更稳的写法是 100dvh。
渐变属于平面截图里最难被记住的特征:人眼对色相敏感,对过渡不敏感。AI 生成时丢掉的往往正是它,而人验收时最先挑出来的也常常是它。
沉淀成方法:一条可复现的路径
把这次还原抽象一下,截图转 HTML 有一条比较稳的路径:
- 第一轮只要结构。明确告诉 AI 先输出语义化骨架,配色细节后续再调,降低单轮目标,输出反而更稳定。
- 第二轮点名细节。逐项列出背景色值、圆角、阴影、间距、字号。AI 对清单式指令的响应,远好于「再像一点」这种模糊反馈。
- 第三轮专盯氛围特征。渐变、噪点、光影这类装饰性特征最容易被丢,值得单独一轮来验收。
- 每轮并排对比。把浏览器渲染结果和原图并排放,逐块肉眼比对,比在对话里反复拉扯效率高得多。修改指令也尽量带定位:「右上角签到按钮」「第二组宫格」,配合截图标注,AI 改起来更准。
这套节奏同时是一个提示词工程的样本:与其争论哪家模型还原得更像,不如把一次大任务拆成三次小验收,每一轮只解决一类问题。同样的拆法也适用于目前各类截图生成页面的工具,无论底层模型多强,「结构先行、细节跟进、氛围收尾」的次序都成立。
最后说说适用边界和那个诚实的结论。这套流程最适合内容型静态页面:个人中心、设置页、落地页,还原度可以做到很高;一旦涉及复杂交互状态、多端响应式断点和无障碍支持,截图里没有的信息 AI 也补不出来,还得回到设计文档和手写代码。而在静态还原的范畴里,AI 承担的是像素搬运劳动,哪些像素不该搬(设备外壳、真实头像、版权图标)、哪个细节最影响观感(渐变、层次、间距),判断权仍然在人。三轮迭代不是 AI 不行,而是这套人机分工的正常形态。把它当成流程设计出来,截图还原就从碰运气变成了一道可复现的工序。