字节笔记本
2026年10月6日 · 约 61 分钟读完
AI 工作流专栏 14:Embedding 与文档处理实战
本文是《从零成为 AI 工作流工程师》系列第 14 篇,主题是 Embedding 与文档处理:向量从哪里来、模型怎么选,以及怎么把真实世界的杂乱文档变成 AI 能检索的干净文本和向量。
RAG 的五大环节是解析、切片、向量化、检索、生成,但它们都有一个共同前提:文本已经准备好了,干净、规整、拿来就能用。现实哪有这么好的事?你拿到的资料是扫描版 PDF(带页眉页脚和乱码)、是 Word 文档(里面有表格)、是网页(塞满了导航栏和广告)、是图片(图表里全是数字)。这些"脏数据"直接喂给 AI,要么喂不进去,要么喂进去也检索不准。RAG 系统最容易被低估、却最决定成败的,正是输入端。
本篇从 Embedding 模型选型讲到文档解析、清洗、切片,最后用一份完整流水线脚本把 PDF 到入库的全链路串起来,也是日后做 RAG 项目时回头翻得最多的一类内容:
- Embedding 模型怎么选:OpenAI、BGE-M3、Cohere、通义对比
- 怎么用 OpenAI 和本地 BGE 跑 Embedding(两套代码)
- Embedding 维度与存储成本的权衡
- 多语言文档(中英混排)的 Embedding 注意事项
- PDF 解析三件套:PyPDF2、pdfplumber、Unstructured
- Word、Excel、PPT 解析:python-docx、openpyxl、python-pptx
- 网页正文提取:BeautifulSoup 与 trafilatura
- 表格和图片怎么转成文本(Markdown 表格、OCR、视觉大模型)
- 文档清洗:去空白、去页眉页脚、去乱码、保留结构
- 切片策略进阶:固定、按标题、递归、表格代码特殊处理,以及 chunk_size 与 overlap 怎么取舍
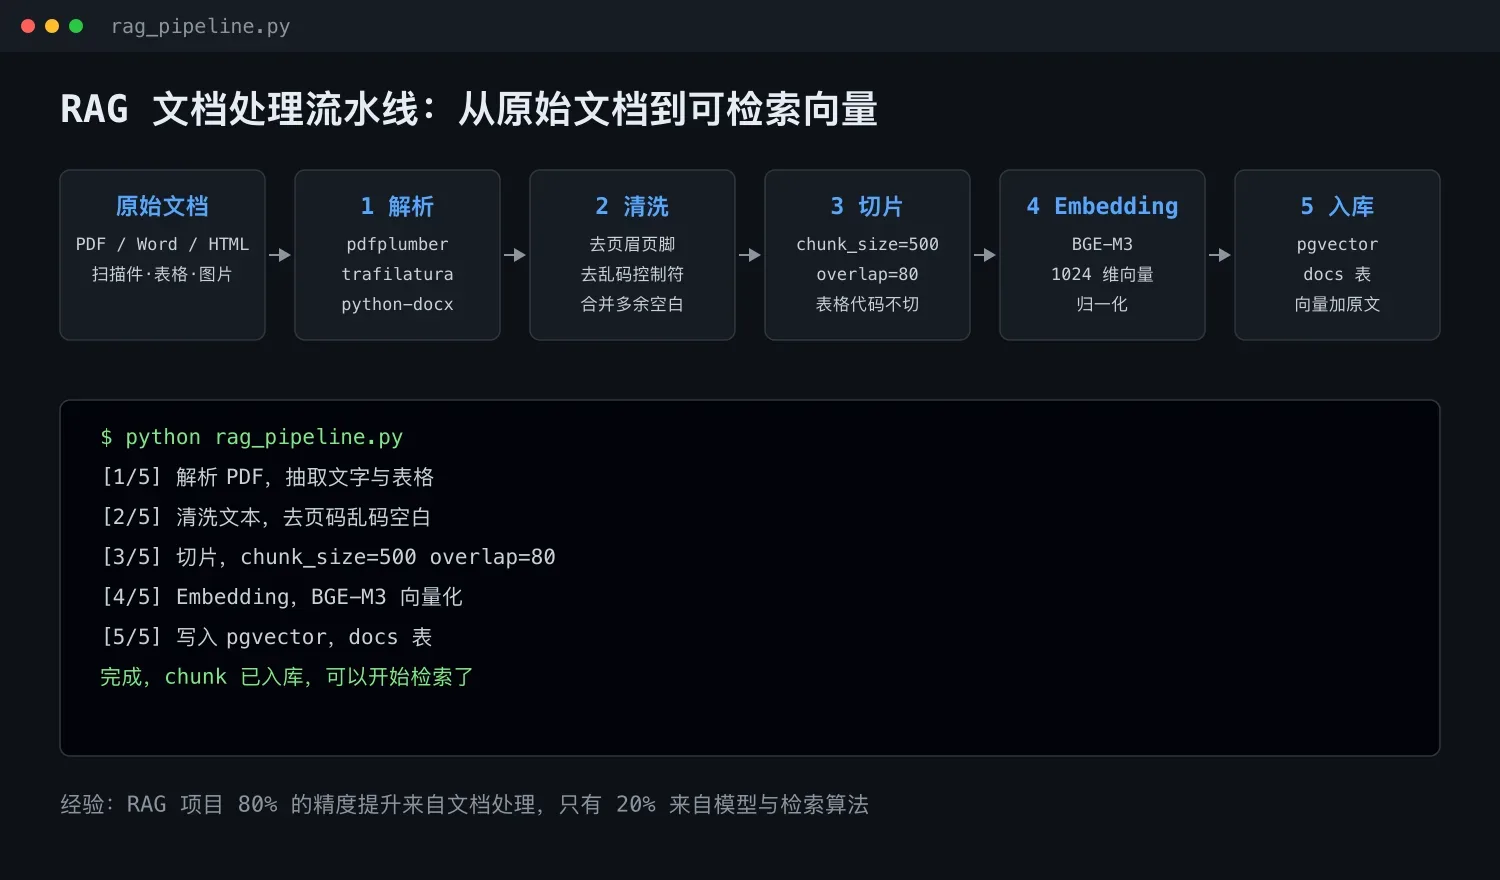
- 完整流水线:一份 PDF 从解析、清洗、切片、Embedding 到存进 pgvector 串成一个脚本
一、Embedding 是什么:给文字一个语义坐标
1.1 生活类比:图书馆的主题坐标
想象你走进一家超大图书馆,找一本讲"机器学习"的书。如果书架是按书名首字母排的,你得在 M 区翻几百本,因为《Machine Learning》《魔法数学》《猫咪护理》全挤在一块,名字相近但内容天差地别。
但聪明的图书馆会按主题分区:人工智能在 3 楼东区,宠物护理在 1 楼西区。两本书只要"讲的东西差不多",物理位置就挨得近,哪怕书名一个字都不一样。《机器学习》和《深度学习》虽然名字不同,但都会摆在 3 楼东区相邻的位置。
Embedding 干的就是这件事:它把任意一段文字,转换成一组数字(一个"主题坐标")。语义相近的文字,坐标也相近;语义无关的文字,坐标离得老远。这样我们就能用"算距离"的方式,从几百万段文字里秒速找出"和问题最相关的那几段"。
1.2 专业定义
Embedding(嵌入):用一个固定长度的浮点数向量(比如 1536 维)来表示一段文本的语义。两段文本的语义相似度,通常用**余弦相似度(cosine similarity)**衡量,值越接近 1 越相似,越接近 0 越无关。
向量检索的核心,是拿"问题向量"和"文档向量"算余弦。本篇要回答的是:这个向量是谁产生的?怎么产生?选哪个模型?
1.3 一个最小例子,先建立直觉
# embedding_intuition.py: 先"看见"Embedding 长什么样
import os
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

texts = [
    "我爱吃火锅",            # 1
    "火锅是我的最爱",         # 2, 语义和 1 几乎一样
    "今天股市大跌",          # 3, 语义和 1 完全无关
]

resp = client.embeddings.create(
    model="text-embedding-3-small",
    input=texts,
)
v1, v2, v3 = [d.embedding for d in resp.data]

# 余弦相似度(手写版,理解原理)
import math
def cosine(a, b):
    dot = sum(x*y for x, y in zip(a, b))
    na = math.sqrt(sum(x*x for x in a))
    nb = math.sqrt(sum(y*y for y in b))
    return dot / (na * nb)

print(f"火锅 vs 火锅: {cosine(v1, v2):.3f}")   # ≈ 0.92,很相似
print(f"火锅 vs 股市: {cosine(v1, v3):.3f}")   # ≈ 0.45,不相关
同样讲火锅的两句话,相似度 0.92;火锅和股市,只有 0.45。这就是 Embedding 的魔力:它"读懂了意思",而不是只比对字面。
二、Embedding 模型选型:OpenAI、BGE、Cohere、通义怎么选
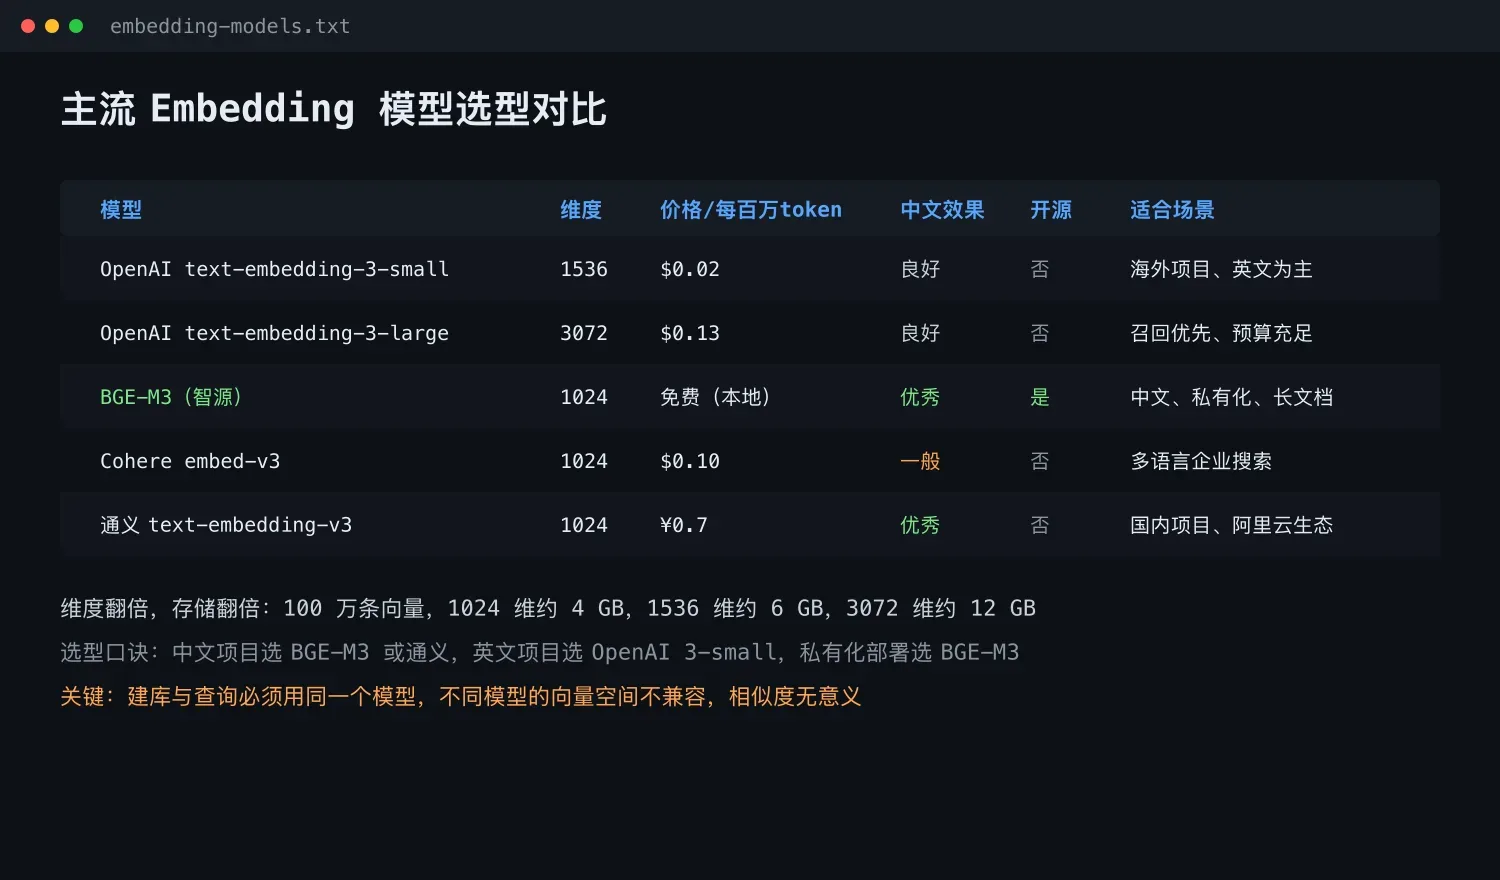
选 Embedding 模型就像选车:有人要省心(直接调 API,OpenAI),有人要省钱(本地跑,BGE),有人要中文最好(通义、BGE),有人要多语言通吃(Cohere、BGE-M3)。下表是实战中最常被拿来对比的四家:
2.1 主流模型对比
| 模型 | 维度 | 价格(约) | 中文效果 | 多语言 | 是否开源 | 适合场景 |
|---|---|---|---|---|---|---|
OpenAI text-embedding-3-small | 1536 | $0.02 / 1M tokens | 良好 | 是 | 否 | 海外项目、要省心、英文为主 |
OpenAI text-embedding-3-large | 3072 | $0.13 / 1M tokens | 良好 | 是 | 否 | 对召回质量极致要求、预算充足 |
| BGE-M3(智源) | 1024 | 免费(本地跑) | 优秀 | 是(100+ 语言) | 是 | 中文项目、私有化部署、长文档 |
Cohere embed-v3 | 1024 | $0.10 / 1M tokens | 一般 | 是 | 否 | 多语言企业搜索、海外 SaaS |
通义 text-embedding-v3 | 1024 | ¥0.7 / 1M tokens | 优秀 | 是 | 否 | 国内项目、阿里云生态 |
一句话选型口诀:
- 国内 + 中文为主 → 通义 v3 或 BGE-M3(BGE 免费可本地,通义效果稳)
- 海外 + 英文为主 → OpenAI 3-small(便宜好用)
- 要私有化 / 离线 → BGE-M3(开源、能本地、中文强,性价比之王)
- 预算无限 + 召回为王 → OpenAI 3-large
2.2 维度与存储成本:越高越准,但越贵
生活类比:买手机摄像头,800 万像素够发朋友圈,1 亿像素能放大数睫毛,但一张照片从 2MB 变成 20MB,相册很快就满了。Embedding 维度也是这个道理。
- 1024 维:1 条向量约 4 KB(float32)。100 万条约 4 GB。
- 1536 维(OpenAI small):100 万条约 6 GB。
- 3072 维(OpenAI large):100 万条约 12 GB。
维度翻倍,存储翻倍,检索时算余弦的 CPU 也翻倍,但召回质量的提升通常是边际递减的:从 1024 到 1536 提升明显,从 1536 到 3072 往往只提升 1-2 个百分点。
实战建议:先用 1024/1536 维跑通,跑出来召回不行再上高维。别一上来就 large,你的数据库和钱包都会哭。
2.3 多语言 Embedding:中英混排怎么办
处理"中英混排"的文档(比如技术博客里中文夹着英文术语 Transformer、attention),必须选多语言模型,否则模型会把中文的"苹果"和英文的"apple"当成两个完全无关的词。
三个坑:
- 别用单语模型处理混排:老的中文专用模型遇到英文术语会"失明"。
- 统一用同一个模型:建库时用 BGE-M3,查询时也得用 BGE-M3,不能混用(不同模型的向量空间不兼容,算出来的相似度毫无意义)。
- 代码、公式要小心:多数 Embedding 模型对代码片段理解一般,纯代码文档建议加文字注释再做 embedding。
三、上手跑 Embedding:OpenAI 与本地 BGE 两套代码
3.1 方案一:OpenAI API(云端,最省心)
# embedding_openai.py: 用 OpenAI 跑 Embedding
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

def embed_openai(texts: list[str], model="text-embedding-3-small") -> list[list[float]]:
    """批量 Embedding,OpenAI 单次最多 2048 条"""
    all_vecs = []
    for i in range(0, len(texts), 2048):
        batch = texts[i:i+2048]
        resp = client.embeddings.create(model=model, input=batch)
        # 返回顺序和输入一致,保险起见按 index 排个序
        all_vecs.extend([d.embedding for d in sorted(resp.data, key=lambda x: x.index)])
    return all_vecs

if __name__ == "__main__":
    vecs = embed_openai(["RAG 是检索增强生成", "Retrieval-Augmented Generation"])
print(f"维度: {len(vecs[0])}, 第一条前 5 维: {vecs[0][:5]}")优点:零部署、稳定、英文强。缺点:要付费、有网络门槛、数据出域(金融医疗等敏感行业不能用)。
3.2 方案二:本地跑 BGE-M3(开源、免费、中文强)
# embedding_bge.py: 用 sentence-transformers 本地跑 BGE-M3
# 先装:pip install sentence-transformers
from sentence_transformers import SentenceTransformer
import numpy as np

# 首次运行会自动下载模型(约 2GB),之后从本地加载
model = SentenceTransformer(
    "BAAI/bge-m3",                # 智源 BGE-M3
    device="cpu",                 # 没 GPU 就用 cpu;有 cuda 写 "cuda"
)

def embed_bge(texts: list[str]) -> np.ndarray:
    """本地批量 Embedding,返回 numpy 数组"""
    vecs = model.encode(
        texts,
        batch_size=32,
        normalize_embeddings=True,  # 归一化后点积 = 余弦相似度,检索更快
        show_progress_bar=False,
    )
    return vecs

if __name__ == "__main__":
    vecs = embed_bge(["RAG 是检索增强生成", "Retrieval-Augmented Generation"])
    print(f"维度: {vecs.shape[1]}")  # 1024
print(f"两句话余弦相似度: {float(vecs[0] @ vecs[1]):.3f}") # 归一化后点积即余弦优点:免费、数据不出域、中文效果顶级、支持长文本(最多 8192 token)。缺点:首次下载模型大、CPU 推理慢(百万级文档建议上 GPU)。
3.3 小结:Embedding 选型三步法
- 看场景定云端 vs 本地(合规、成本、数据量)。
- 看主语言定模型(中文 BGE/通义,英文 OpenAI)。
- 看召回质量定维度(先用 1024/1536,不够再升)。
四、文档处理:RAG 的半壁江山
4.1 生活类比:榨汁机榨果汁
你想喝一杯橙汁。橙子从果园摘下来,带泥、带叶子、带皮。你不会把整颗带皮橙子直接塞嘴里,你得洗净、剥皮、切块,再喂进榨汁机,才能得到一杯干净的果汁。
RAG 的文档处理就是这套"洗切榨"流程:
- 洗净 = 解析:把 PDF/Word/网页里的文字"抠"出来。
- 剥皮去籽 = 清洗:去掉页眉页脚、乱码、多余空白。
- 切块 = 切片:切成适合模型吃的小块(chunk)。
- 榨汁 = Embedding:把每块转成向量。
榨汁机(Embedding 模型)再贵再好,橙子没洗干净、没切好,榨出来的也是带皮的苦汁。业界有句经验之谈:"RAG 项目 80% 的精度提升来自文档处理,只有 20% 来自模型和检索算法。"记住这句话,你就懂为什么本篇这么重要。
五、PDF 解析三件套:PyPDF2、pdfplumber、Unstructured
PDF 是 RAG 项目里最常见也最难搞的格式:它是为"打印好看"设计的,不是为"程序读取"设计的,文字坐标、表格、图片全混在一起。
5.1 方案对比
| 工具 | 能力 | 速度 | 推荐度 | 一句话评价 |
|---|---|---|---|---|
| PyPDF2 / pypdf | 纯文字 | 快 | 一般 | 只能抠纯文字,表格全废,应急用 |
| pdfplumber | 文字 + 表格 | 中 | 首选 | 表格提取一绝,可控性强 |
| Unstructured | 文字+表格+图片+版式 | 慢 | 推荐 | 万能瑞士军刀,但要装一堆系统依赖 |
5.2 pdfplumber 实战:提取一份 PDF 的文字和表格
# parse_pdf.py: 用 pdfplumber 提取 PDF
# 先装:pip install pdfplumber
import pdfplumber

def extract_pdf(pdf_path: str):
    """提取 PDF 全部文字 + 表格,返回 (full_text, tables)"""
    full_text = []
    all_tables = []
    with pdfplumber.open(pdf_path) as pdf:
        for page_idx, page in enumerate(pdf.pages):
            # 1) 提取纯文字
            text = page.extract_text() or ""
            full_text.append(f"\n--- 第 {page_idx+1} 页 ---\n{text}")

            # 2) 提取表格(pdfplumber 的杀手锏)
            for table in page.extract_tables():
                all_tables.append({"page": page_idx + 1, "rows": table})

    return "\n".join(full_text), all_tables

if __name__ == "__main__":
    text, tables = extract_pdf("sample.pdf")
    print(f"文字总长度: {len(text)} 字符")
    print(f"表格数量: {len(tables)}")
    if tables:
        print(f"第一个表格第一行: {tables[0]['rows'][0]}")
pdfplumber 的坑:
- 多栏排版(论文常见的双栏)会读成"左栏第一行 + 右栏第一行"乱序,需要按坐标分栏处理。
- 扫描版 PDF(图片拼接,没有文字层)
extract_text返回空,得用 OCR(见后文表格与图片一节)。 - 公式、化学结构式提取出来是乱码,建议这类文档直接走视觉大模型。
5.3 Unstructured:万能但笨重
当你遇到"什么格式都有"的需求(PDF、Word、PPT、邮箱 .eml、HTML 一锅端),Unstructured 是终极方案:
# parse_unstructured.py: Unstructured 万能解析
# 先装:pip install "unstructured[all-docs]"
from unstructured.partition.auto import partition

elements = partition("sample.pdf")   # 自动识别格式
for el in elements:
    print(el.category, ":", str(el)[:80])
# 输出形如:
# Title : 第一章 项目背景
# Narrative : 本项目旨在...
# Table : [['月份','销量'], ['1月','1200'], ...]它会把文档切成带类别标签(Title、Narrative、Table、ListItem 等)的元素,对保留结构很有用。缺点是依赖重(要装 poppler、tesseract、libmagic 等系统包),第一次部署容易踩坑。
六、Word、Excel、PPT 解析
6.1 Word:python-docx
# parse_docx.py
# pip install python-docx
from docx import Document

def extract_docx(path: str) -> str:
    doc = Document(path)
    parts = []
    for para in doc.paragraphs:
        # 保留标题层级信息(Heading 1/2/3)
        style = para.style.name if para.style else "Normal"
        prefix = ""
        if style.startswith("Heading"):
            level = style.replace("Heading ", "")
            prefix = "#" * int(level) + " " if level.isdigit() else ""
        if para.text.strip():
            parts.append(prefix + para.text.strip())
return "\n\n".join(parts)注意:Word 里的表格不在 paragraphs 里,要单独遍历 doc.tables,每个 table.rows 取单元格 cell.text。
6.2 Excel:openpyxl
# parse_xlsx.py
# pip install openpyxl
from openpyxl import load_workbook

def extract_xlsx(path: str) -> list[dict]:
    """每个 sheet 转成一个 Markdown 表格字符串"""
    wb = load_workbook(path, data_only=True)  # data_only 取计算后的值
    sheets = []
    for ws in wb.worksheets:
        rows = list(ws.iter_rows(values_only=True))
        if not rows:
            continue
        # 转成 Markdown 表格
        header = rows[0]
        md = ["| " + " | ".join(str(c) if c is not None else "" for c in header) + " |"]
        md.append("| " + " | ".join("---" for _ in header) + " |")
        for row in rows[1:]:
            md.append("| " + " | ".join(str(c) if c is not None else "" for c in row) + " |")
        sheets.append({"sheet": ws.title, "markdown": "\n".join(md)})
    return sheets
为什么转 Markdown 而不是 JSON:因为大模型读 Markdown 表格的理解能力远好于嵌套 JSON(对比见后文表格一节)。
6.3 PPT:python-pptx
# parse_pptx.py
# pip install python-pptx
from pptx import Presentation

def extract_pptx(path: str) -> str:
    prs = Presentation(path)
    parts = []
    for i, slide in enumerate(prs.slides, 1):
        parts.append(f"\n## 幻灯片 {i}")
        for shape in slide.shapes:
            if shape.has_text_frame:
                for para in shape.text_frame.paragraphs:
                    txt = para.text.strip()
                    if txt:
                        parts.append(txt)
            elif shape.has_table:   # PPT 里的表格
                for row in shape.table.rows:
                    parts.append(" | ".join(c.text for c in row.cells))
    return "\n".join(parts)
七、网页解析:BeautifulSoup 与 trafilatura
网页最难搞的是正文被导航栏、广告、侧边栏、推荐位包围,直接 requests + BeautifulSoup 拿到的 HTML 里 80% 是噪声。
7.1 BeautifulSoup(手动,可控但要写规则)
# parse_html_bs4.py
# pip install beautifulsoup4 lxml
import requests
from bs4 import BeautifulSoup

def extract_html_manual(url: str) -> str:
    html = requests.get(url, timeout=10).text
    soup = BeautifulSoup(html, "lxml")

    # 1) 砍掉噪声标签
    for tag in soup(["script", "style", "nav", "footer", "header", "aside", "form"]):
        tag.decompose()

    # 2) 拿正文(article / main / 最长的 div,经验法则)
    main = soup.find("article") or soup.find("main") or soup.body
    text = main.get_text(separator="\n", strip=True) if main else ""

    # 3) 合并多余空行
    lines = [ln.strip() for ln in text.splitlines() if ln.strip()]
return "\n".join(lines)痛点:每个网站结构不一样,规则得手写。100 个网站等于 100 套规则,维护到吐。
7.2 trafilatura(自动,强烈推荐)
# parse_html_trafilatura.py
# pip install trafilatura
import trafilatura

def extract_html_auto(url: str) -> str:
    html = trafilatura.fetch_url(url)
    # include_tables=True 保留表格,include_links=True 保留链接
    text = trafilatura.extract(
        html,
        include_tables=True,
        include_links=False,
        favor_recall=True,        # 偏向召回,多抓点正文
    )
    return text or ""
trafilatura 内置了基于机器学习的"正文识别"模型,绝大多数新闻、博客页面开箱即用,无需写规则。RAG 项目抓网页,优先用它。
实战建议:trafilatura 打底(覆盖 90% 场景),BeautifulSoup 兜底(特殊网站手动抠)。
八、表格和图片:怎么变成文本
8.1 表格转文本:Markdown 与 JSON
表格是结构化数据,但 Embedding 和 LLM 只认文本,所以得"翻译"。两种译法:
Markdown 表格:
| 月份 | 销量 | 同比 |
|------|------|------|
| 1月  | 1200 | +15% |
| 2月  | 1350 | +12% |
JSON 格式:
[{"月份": "1月", "销量": 1200, "同比": "+15%"},
{"月份": "2月", "销量": 1350, "同比": "+12%"}]| 维度 | Markdown 表格 | JSON |
|---|---|---|
| LLM 理解度 | 极好(训练时见过海量 MD 表) | 中等(行数据丢失"表头全局"语境) |
| Embedding 召回 | 好 | 一般(每行单独 embed 时丢失列名) |
| 程序解析 | 弱(要正则) | 极好(json.loads 秒解) |
| 推荐场景 | 给 LLM 看 / 入向量库 | 给下游程序消费 |
结论:进 RAG 体系一律用 Markdown 表格;要导出给 Excel、数据库才用 JSON。
8.2 图片:OCR 还是视觉大模型?
文档里的图片分两类:
a) 文字型图片(扫描件、合同截图、表格截图)→ OCR
- Tesseract(开源,免费,中文要装 chi_sim 语言包,效果一般)。
- PaddleOCR(百度开源,中文 OCR 顶级,强烈推荐)。
# ocr_paddle.py
# pip install paddlepaddle paddleocr
from paddleocr import PaddleOCR

ocr = PaddleOCR(use_angle_cls=True, lang="ch")  # 中文
result = ocr.ocr("invoice.png", cls=True)
for line in result[0]:
    print(line[1][0])   # line[1][0] 是识别出的文字
b) 图表、流程图、信息图(不是文字,是图像语义)→ 视觉大模型
OCR 对饼图、流程图这种"图形化信息"无能为力(它只能抠出图里的零星文字标签)。这时候要让 GPT-4o、Claude、通义千问 VL 这类多模态模型来"看图说话":
# image_to_text_vlm.py: 视觉大模型读图
import os, base64
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

def image_to_text(image_path: str) -> str:
    with open(image_path, "rb") as f:
        b64 = base64.b64encode(f.read()).decode()

    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": "详细描述这张图的内容,尤其是图表中的数据和趋势,输出纯文本,便于检索。"},
                {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{b64}"}},
            ],
        }],
    )
return resp.choices[0].message.content选型口诀:抠文字用 OCR(PaddleOCR),读图意用 VLM(GPT-4o、通义 VL)。
九、文档清洗:别让脏数据毁了召回
9.1 生活类比:淘金
淘金者从河里捞上来一盆沙,里面掺着泥土、小石子、树叶。不洗干净直接炼,出来的金子里全是杂质。文档清洗就是这道"淘洗"工序,去掉一切干扰检索的噪声。
9.2 清洗的五大动作
# clean_text.py: 文档清洗通用函数
import re

def clean_text(text: str) -> str:
    # 1) 统一换行符(Windows 的 \r\n → \n)
    text = text.replace("\r\n", "\n").replace("\r", "\n")

    # 2) 去页眉页脚的常见模式(页码、"第 X 页")
    text = re.sub(r"-?\s*\d+\s*-?\s*\n", "\n", text)       # 单独一行的页码
    text = re.sub(r"第\s*\d+\s*页.*?\n", "", text)          # 中文页码
    text = re.sub(r"Page\s+\d+\s+of\s+\d+", "", text)       # 英文页码

    # 3) 去乱码(非打印字符、Unicode 替换符)
    text = text.replace("\ufffd", "")                       # 替换符
    text = re.sub(r"[\x00-\x08\x0b\x0c\x0e-\x1f]", "", text)  # 控制字符

    # 4) 合并多余空白:连续空格 → 单空格,连续空行 → 单空行
    text = re.sub(r"[ \t]+", " ", text)
    text = re.sub(r"\n{3,}", "\n\n", text)

    # 5) 修复断行:行尾是中文或小写字母且下一行不是新段落,拼回去
    text = re.sub(r"([^\n。!?.!?])\n([^\n])", r"\1\2", text)

    return text.strip()
9.3 保留结构:标题层级别丢
清洗最容易犯的错是把结构信息一起洗掉了。一篇文档里"第二章 定价策略"是 H2 标题,它对检索极有价值(查询"定价"时这段优先级更高)。所以清洗时:
- 保留 Markdown 标题语法(
#、##、###)。 - 保留列表项(
-、1.)。 - 保留表格的 Markdown 结构。
- 只删纯噪声(页码、乱码、连续空白),别动语义。
十、切片策略进阶:把长文本切成"刚好一口"的块
切片是 RAG 里调一个参数就能涨点、掉点的关键旋钮,值得花一整节细讲。
10.1 四种切片策略对比
a) 固定字符切片(最粗暴)
def chunk_fixed(text: str, size=500, overlap=50) -> list[str]:
    chunks = []
    start = 0
    while start < len(text):
        chunks.append(text[start:start+size])
        start += size - overlap      # 滑动窗口,留 overlap 重叠
return chunks优点:简单。缺点:会把一句话从中间切断,破坏语义。只适合:纯文本、无结构的聊天记录。
b) 按段落、标题切片(保留结构)
# pip install langchain-text-splitters
from langchain_text_splitters import MarkdownHeaderTextSplitter

def chunk_by_header(md_text: str) -> list[str]:
    splitter = MarkdownHeaderTextSplitter(
        headers_to_split_on=[("#", "h1"), ("##", "h2"), ("###", "h3")]
    )
    docs = splitter.split_text(md_text)
    # 每段 doc 自带 metadata(属于哪个标题),对检索超有用
return [f"[{d.metadata}]\n{d.page_content}" for d in docs]优点:语义完整、保留层级。缺点:章节长短不一时,有的 chunk 几十字、有的几万字。适合:产品手册、技术文档、Wiki。
c) 递归字符切片(LangChain 经典,最常用)
from langchain_text_splitters import RecursiveCharacterTextSplitter

def chunk_recursive(text: str, chunk_size=500, overlap=80) -> list[str]:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=chunk_size,
        chunk_overlap=overlap,
        separators=["\n\n", "\n", "。", ".", " ", ""],  # 按优先级递归
    )
return splitter.split_text(text)原理:先尝试用 \n\n(段落)切,切出来的还太长就降级用 \n(行),再长用 。(句号),最后才用空字符硬切。尽可能保留语义边界,实在不行才硬切。这是 90% RAG 项目的默认选择。
d) 表格、代码的特殊切片
- 表格:一个完整表格永远不要切(切成两半就废了)。表格作为一个独立 chunk,并在前面加一行自然语言描述("以下是 2024 年 Q1 销售数据表")提升召回。
- 代码:用
Language.PYTHON的RecursiveCharacterTextSplitter,按函数、类边界切,别从函数中间断开。
from langchain_text_splitters import RecursiveCharacterTextSplitter, Language

code_splitter = RecursiveCharacterTextSplitter.from_language(
    language=Language.PYTHON,
    chunk_size=800,
    chunk_overlap=100,
)
code_chunks = code_splitter.split_text(python_source)
10.2 chunk_size 与 overlap 怎么取
这是新人最常问的问题。直接给一条经验曲线:chunk_size 太小(小于 300)信息不足,召回的片段答不了问题;太大(大于 1000)一个块里塞了太多主题,噪声变多,检索准确率反而下降。中间的 300 到 800 是甜区。
| 参数 | 推荐值 | 取舍逻辑 |
|---|---|---|
chunk_size | 300-800 字符(中文按字,英文按 token) | 太小:单块信息不全,召回的片段答不了问题;太大:一个 chunk 塞太多主题,检索噪声大,还浪费上下文窗口 |
overlap | 50-150 字符(约 chunk_size 的 10%-20%) | 防止关键句被切到两块的交界处丢失;太大就重复太多,浪费存储 |
调参心法:
- 事实型问答("公司成立年份?")→ chunk 偏小(300-500),精准命中。
- 论述型问答("分析一下定价策略")→ chunk 偏大(600-1000),要上下文。
- 先跑基线(500/80),再用评估集和 Recall@K 这类指标调。
10.3 小结:切片四原则
- 优先保语义完整(递归、按标题)。
- 表格、代码永远不切。
- chunk_size 先 500,overlap 先 80,再按评估调。
- 切片后给每个 chunk 加 metadata(来源文件、页码、标题路径),便于溯源和过滤。
十一、完整流水线:PDF 到 pgvector 一条龙
把前面所有零件拼起来。这是本篇精华,建议照着跑一遍。
11.1 环境准备
# Python 依赖
pip install pdfplumber langchain-text-splitters sentence-transformers \
            psycopg[binary] pgvector python-dotenv

# PostgreSQL 要装 pgvector 扩展
# docker run -d --name pg -e POSTGRES_PASSWORD=postgres -p 5432:5432 pgvector/pgvector:pg16
11.2 一条龙脚本
# rag_pipeline.py: RAG 文档处理完整流水线
"""
把一份 PDF:解析 → 清洗 → 切片 → Embedding → 存进 pgvector
跑通后,检索端就能直接用这个库。
"""
import os, re, hashlib
import pdfplumber
import psycopg
from dotenv import load_dotenv
from sentence_transformers import SentenceTransformer
from langchain_text_splitters import RecursiveCharacterTextSplitter

load_dotenv()

# ---------- 第 1 步:解析 PDF ----------
def parse_pdf(pdf_path: str) -> str:
    parts = []
    with pdfplumber.open(pdf_path) as pdf:
        for i, page in enumerate(pdf.pages, 1):
            text = page.extract_text() or ""
            parts.append(f"\n## 第 {i} 页\n{text}")
            for table in page.extract_tables():
                md = table_to_markdown(table)
                parts.append(md)
    return "\n\n".join(parts)

def table_to_markdown(table) -> str:
    """把 pdfplumber 的二维列表转 Markdown 表格"""
    if not table:
        return ""
    rows = [[(c or "").strip() for c in row] for row in table]
    header = rows[0]
    md = ["| " + " | ".join(header) + " |",
          "| " + " | ".join("---" for _ in header) + " |"]
    for row in rows[1:]:
        md.append("| " + " | ".join(row) + " |")
    return "\n".join(md)

# ---------- 第 2 步:清洗 ----------
def clean_text(text: str) -> str:
    text = text.replace("\r\n", "\n").replace("\r", "\n")
    text = re.sub(r"-?\s*\d+\s*-?\s*\n", "\n", text)       # 页码
    text = text.replace("\ufffd", "")
    text = re.sub(r"[\x00-\x08\x0b\x0c\x0e-\x1f]", "", text)
    text = re.sub(r"[ \t]+", " ", text)
    text = re.sub(r"\n{3,}", "\n\n", text)
    return text.strip()

# ---------- 第 3 步:切片 ----------
def chunk_text(text: str, chunk_size=500, overlap=80) -> list[str]:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=chunk_size,
        chunk_overlap=overlap,
        separators=["\n\n", "\n", "。", ".", " ", ""],
    )
    return splitter.split_text(text)

# ---------- 第 4 步:Embedding(本地 BGE-M3) ----------
_model = None
def get_model():
    global _model
    if _model is None:
        _model = SentenceTransformer("BAAI/bge-m3", device="cpu")
    return _model

def embed(texts: list[str]) -> list[list[float]]:
    model = get_model()
    vecs = model.encode(texts, batch_size=32,
                        normalize_embeddings=True, show_progress_bar=True)
    return vecs.tolist()

# ---------- 第 5 步:存 pgvector ----------
def ensure_table(conn):
    with conn.cursor() as cur:
        cur.execute("CREATE EXTENSION IF NOT EXISTS vector;")
        cur.execute("""
            CREATE TABLE IF NOT EXISTS docs (
                id        TEXT PRIMARY KEY,
                source    TEXT,
                page      INT,
                chunk_idx INT,
                content   TEXT,
                embedding vector(1024)
            );
        """)
        conn.commit()

def store_chunks(chunks, vecs, source, conn):
    with conn.cursor() as cur:
        for i, (chunk, vec) in enumerate(zip(chunks, vecs)):
            doc_id = hashlib.md5(f"{source}:{i}:{chunk[:32]}".encode()).hexdigest()
            page = 1  # 简化:实际可从切片时记录的页码取
            vec_str = "[" + ",".join(f"{x:.6f}" for x in vec) + "]"
            cur.execute("""
                INSERT INTO docs (id, source, page, chunk_idx, content, embedding)
                VALUES (%s, %s, %s, %s, %s, %s)
                ON CONFLICT (id) DO NOTHING;
            """, (doc_id, source, page, i, chunk, vec_str))
        conn.commit()

# ---------- 主流程 ----------
def main():
    pdf_path = "sample.pdf"
    source_name = os.path.basename(pdf_path)

    print("[1/5] 解析 PDF...")
    raw = parse_pdf(pdf_path)
    print(f"  原始文本 {len(raw)} 字符")

    print("[2/5] 清洗文本...")
    cleaned = clean_text(raw)
    print(f"  清洗后 {len(cleaned)} 字符")

    print("[3/5] 切片...")
    chunks = chunk_text(cleaned, chunk_size=500, overlap=80)
    print(f"  切出 {len(chunks)} 个 chunk")

    print("[4/5] Embedding (BGE-M3)...")
    vecs = embed(chunks)
    print(f"  向量维度 {len(vecs[0])}")

    print("[5/5] 写入 pgvector...")
    dsn = os.getenv("PG_DSN", "postgresql://postgres:postgres@localhost:5432/postgres")
    with psycopg.connect(dsn) as conn:
        ensure_table(conn)
        store_chunks(chunks, vecs, source_name, conn)
    print(f"完成!{len(chunks)} 个 chunk 已入库,下一步就能检索了。")

if __name__ == "__main__":
    main()
跑完之后,数据库里就有一张 docs 表,每行是一个文本块和它的向量。检索端用"问题向量、余弦相似度排序、取 Top-K"的方式,就能把相关片段捞出来喂给大模型。这就是 RAG 的"输入端"完整闭环。
十二、本章小结
- Embedding 是把文字变"主题坐标"的魔法:语义相近 → 坐标相近 → 算余弦就能检索。选模型看场景:中文 BGE-M3、通义,英文 OpenAI,私有化必 BGE。
- 维度与成本权衡:1024/1536 是甜区,3072 是奢侈品,先用低维跑通再升级。
- 多语言文档:务必用多语言模型,且建库和查询必须同一个模型,向量空间不能混。
- PDF 解析首选 pdfplumber(表格强),万能场景上 Unstructured,扫描件走 OCR。
- Word、Excel、PPT:python-docx、openpyxl、python-pptx,表格统一转 Markdown。
- 网页正文:trafilatura 开箱即用(90% 场景),BeautifulSoup 兜底特殊网站。
- 表格进 RAG 用 Markdown,进程序用 JSON;图片抠文字用 PaddleOCR,读图意用视觉大模型。
- 清洗只删噪声不删结构:保留标题、列表、表格的 Markdown 语法。
- 切片首选递归字符(LangChain),表格代码不切,chunk_size 先 500、overlap 先 80,再按评估调。
- 完整流水线:解析 → 清洗 → 切片 → Embedding → 存库,本文流水线一节的脚本是日后项目的模板。
十三、动手练习
练习 1(基础):找一份真实的 PDF(公司手册、论文、电子书都行),用本文第五节的 pdfplumber 代码把文字和表格都提出来,再用 clean_text 清洗,打印清洗前后的字符数对比,感受清洗到底删掉了多少噪声。
练习 2(进阶):用同一份文档,分别跑三种切片(固定、按标题、递归),统计每种切出来多少个 chunk、最大/最小 chunk 长度。然后人工挑 3 个 chunk 看,哪种切法的语义最完整?把你的发现写在注释里。
练习 3(挑战):跑通第十一节的完整流水线脚本,把一份 PDF 入库到 pgvector。然后写一个 query.py:输入一个问题,用 BGE-M3 把问题向量化,去 docs 表里用 <=> 操作符做余弦检索,取 Top-3 最相关 chunk 打印出来。你已经做出了第一个能用的 RAG 检索器。
十四、延伸阅读
- OpenAI Embedding 指南:https://platform.openai.com/docs/guides/embeddings
- BGE-M3 模型卡(智源):https://huggingface.co/BAAI/bge-m3
- sentence-transformers 文档:https://www.sbert.net/
- pdfplumber 文档(含表格提取细节):https://github.com/jsvine/pdfplumber
- Unstructured 官方文档:https://docs.unstructured.io/
- trafilatura(网页正文提取):https://trafilatura.readthedocs.io/
- LangChain Text Splitters:https://python.langchain.com/docs/how_to/#text-splitters
- PaddleOCR 快速开始:https://paddlepaddle.github.io/PaddleOCR/
- MTEB 中文 Embedding 排行榜(选型必看):https://huggingface.co/spaces/mteb/leaderboard
- 经典论文:Lewis et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(RAG 的开山之作,理解"为什么要做文档处理"的根本动机)
至此,RAG 的输入端已经完整闭环:任何格式的文档进来,都能变成干净的文本块和向量。下一篇,我们进入 Agent 的世界,让 AI 从"被动问答"走向"主动干活"。