字节笔记本
2026年10月6日 · 约 29 分钟读完
AI 工作流 19:n8n、Make、Airflow 怎么选
本文是「AI 工作流」专栏第 19 篇,补上工程交付里"低代码编排"这一环:用 n8n、Make、Airflow 这类自动化编排平台,把邮件、飞书、数据库、GitHub 等系统串成流水线,让 AI 只做自己擅长的那一环。
本文你会看到:自动化编排平台的定位与分工、三大平台横评、n8n 的 Docker 自部署与第一个工作流、AI 节点家族、邮件自动分类回复实战、Make 与 Airflow 速览,以及用 Webhook 打通低代码与自有代码的混合架构。
一、自动化编排平台是什么
想象一家快递分拣中心:包裹从卡车上卸下来,第一个机器人扫码识别目的地,第二个机器人分拣,第三个机器人贴标,第四个机器人装车。机器人本身不懂快递业务,但它们把一道道工序用传送带串起来,前面一步有产出,后面一步就自动接力。
自动化编排平台就是互联网世界里的分拣中心。"有新邮件来了"是触发器,相当于包裹上扫描台;"把邮件内容抽出来"是第一个动作节点;"调大模型判断是投诉还是咨询"是第二个动作节点;"投诉存进工单系统、咨询自动回信"是条件分支加多个动作节点。平台本身不生产业务逻辑,它提供的是一堆预制连接器(连 Gmail、飞书、GitHub、OpenAI、数据库)和一张可视化画布,让你把"如果 A 发生,就做 B 再做 C"这种跨系统串联像搭积木一样拼出来,不用写代码。
一句话定义:自动化编排平台专注跨软件系统、跨服务、跨数据源的自动化串联,核心能力是把"触发、一连串动作、条件分支"编排成可视化流水线,由平台负责定时调度、重试、错误处理和日志记录。代表产品有开源可自部署的 n8n、云端易用的 Make,以及代码定义的企业级 Apache Airflow。
二、它和 LangGraph、Dify 的分工
很多读者的疑问:手写 Agent 用的 LangGraph、零代码的 Dify,和本篇的 n8n 不都是"工作流"吗?区别在编排对象:
| 工具 | 强项 | 编排的是什么 |
|---|---|---|
| LangGraph | LLM 推理流程的精细控制(状态、循环、人在环节) | AI 思考的步骤,节点是模型调用与工具调用 |
| Dify | 搭 AI 应用(RAG、Agent、Prompt 管理) | 一个 AI 应用的内部链路,检索到生成到发布 |
| n8n / Make / Airflow | 跨系统串联(连邮箱、IM、数据库、API) | 多个软件系统之间的胶水流,AI 可能只是其中一环 |
LangGraph 和 Dify 是 AI 内核的编排器,关心 AI 怎么思考;n8n、Make、Airflow 是系统之间的编排器,关心 A 软件的数据怎么流到 B 软件。两者是分工协作而非替代:真实项目里,n8n 负责把邮件、CRM、数据库串起来,串到中间某一步需要 AI 判断时,就调用它的 AI 节点,或者用 Webhook 调你自己写的 LangGraph 服务。
三、三大平台横评
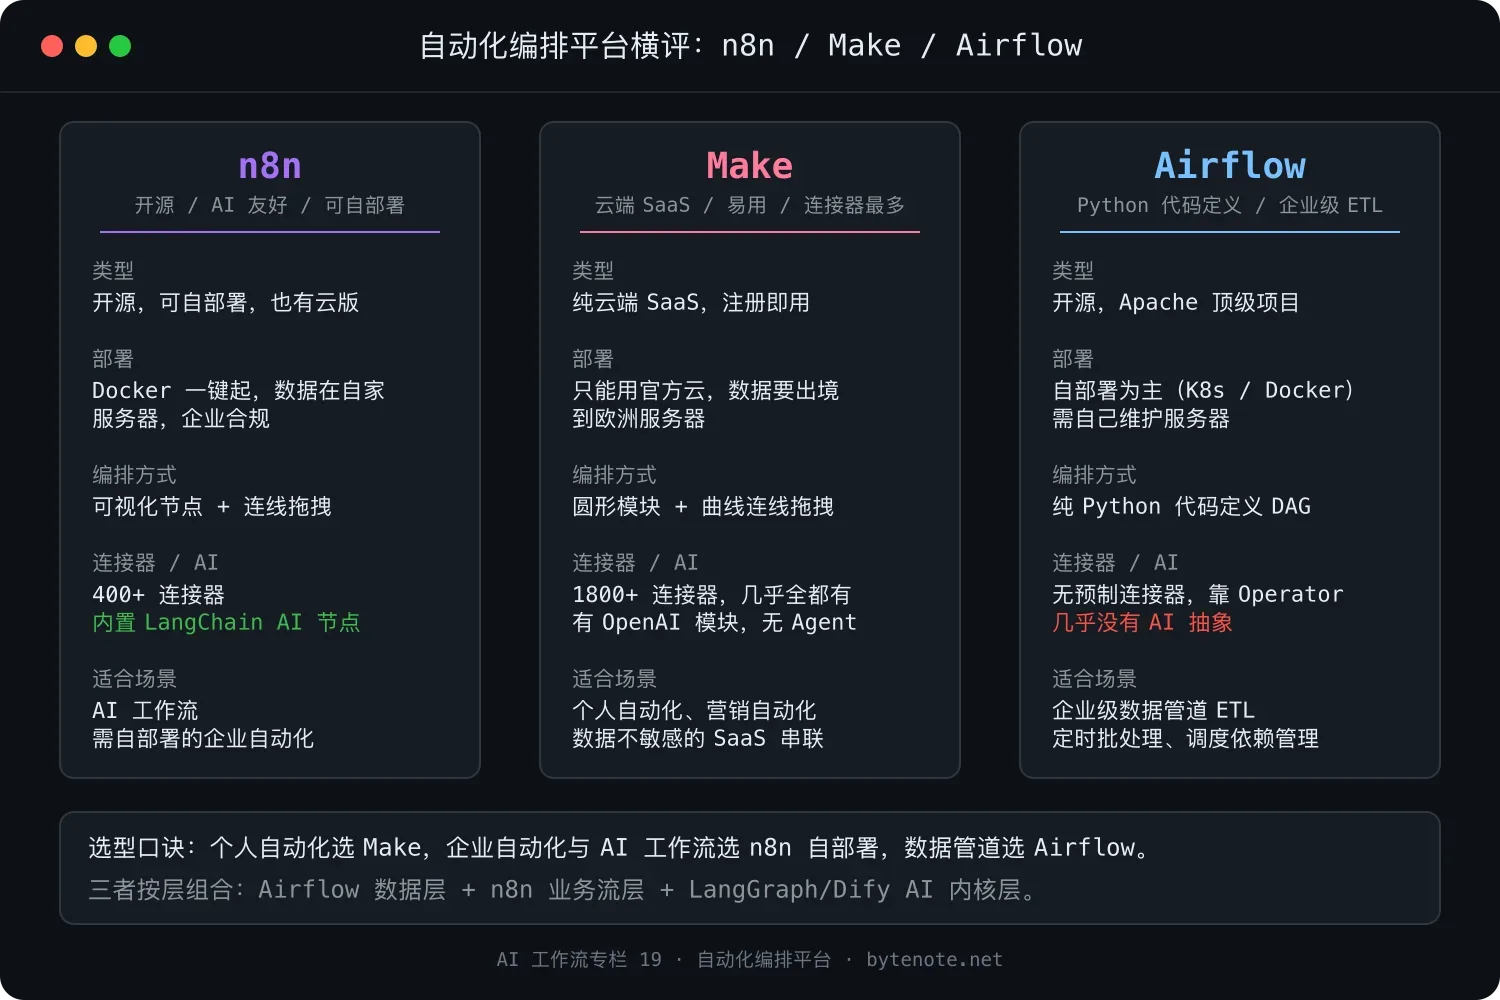
三个平台都叫自动化编排平台,定位差异巨大:
| 对比维度 | n8n | Make | Apache Airflow |
|---|---|---|---|
| 类型 | 开源,可自部署,也有云版 | 纯云端 SaaS | 开源,自部署为主 |
| 数据位置 | 自部署时数据全在自家服务器 | 数据要出境到欧洲服务器 | 自部署,数据在自己手里 |
| 编排方式 | 可视化节点加连线拖拽 | 可视化圆形模块加曲线连线 | 纯 Python 代码定义 DAG |
| 预制连接器 | 400+ | 1800+,几乎覆盖所有 SaaS | 无预制连接器,靠 Operator |
| AI 能力 | 内置基于 LangChain 的 AI 节点 | 有 OpenAI 模块,无 Agent 编排 | 几乎没有 |
| 学习曲线 | 中等 | 低,界面最直观 | 高,必须会 Python |
| 成本 | 自部署免费,云版每月 2500 次免费执行 | 免费版每月 1000 ops | 开源免费,自己维护服务器 |
| 适合场景 | AI 工作流、企业自动化 | 个人与营销自动化 | 企业级数据管道 ETL |
n8n:开源、AI 友好、最适合 AI 工作流
n8n 是 2019 年由德国开发者 Jan Oberhauser 开源的项目,最大的三个标签:开源可自部署、可视化拖拽、内置 LangChain AI 节点。它同时满足了 AI 工作流工程师的三件大事:
- 数据合规:Docker 部署在自己服务器,邮件、客户数据、API Key 全在自家机房,企业法务敢签字,这是纯云端工具永远比不了的。
- AI 原生:把 LangChain 的 Agent、LLM、Memory、Tools、Output Parser 整套做成了可视化节点,拖一个 AI Agent 节点出来,挂上模型和几个工具,就是一个能调工具的 Agent,与手写 LangGraph 的思想一致,但不用写代码。
- 代码可逃逸:每个工作流都能导出成 JSON,可以用 CLI 和 Git 管理,也能用代码节点写 JavaScript 或 Python 处理复杂逻辑,灵活度介于纯拖拽和纯代码之间。
Make:云端、易用、连接器最多
Make 由 Integromat 改名而来,走极致易用加海量连接器路线。1800 多个预制连接器几乎覆盖你听过的所有 SaaS,配置只需要登录授权加选字段,五分钟就能搭一个跨五个系统的工作流,调试时能看到数据沿着连线流动。但对中国用户和企业有个硬伤:纯云端,服务器在欧洲,数据要出境,涉及客户隐私和内部商业数据的工作流过不了法务这一关。所以它更适合个人自动化、营销自动化、跨境电商这类数据出境不敏感的场景。
Airflow:Python 代码、企业级、ETL 专用
Airflow 是 Airbnb 在 2014 年开源、现为 Apache 顶级项目的老牌编排器。它和前两者最大的不同是没有可视化拖拽,工作流(DAG)全程用 Python 代码定义,强项在调度器、重试机制、依赖管理、补数和权限控制,这些都是数据团队的刚需。每天凌晨从业务库抽数据、清洗、写进数仓、触发下游报表,是它的典型用法。但它压根不是为 AI 工作流设计的:没有 LLM 节点、没有 Prompt 管理、没有 Agent 概念,强行为"邮件自动回复"搭流程要手写大量胶水代码,远不如 n8n 拖拽快。记住一条铁律:Airflow 管数据管道,不管 AI 对话。
四、Docker 五分钟自部署 n8n
跟着敲,五分钟你就有了一个跑在自己电脑上的 n8n,生产环境换台云服务器同理:
# 一条命令启动 n8n(数据持久化到 ~/.n8n 目录)
docker run -d --name n8n \
  -p 5678:5678 \
  -v ~/.n8n:/home/node/.n8n \
  -e N8N_HOST=localhost \
  -e N8N_PORT=5678 \
  -e N8N_PROTOCOL=http \
  -e WEBHOOK_URL=http://localhost:5678/ \
  -e GENERIC_TIMEZONE=Asia/Shanghai \
  docker.n8n.io/n8nio/n8n

# 启动后浏览器打开 http://localhost:5678
# 第一次访问会要求注册管理员账号,注册完进入主界面
几个关键点:
-v ~/.n8n:/home/node/.n8n把容器里的数据目录挂载到本机,容器删了数据还在。生产环境强烈建议再挂一个 PostgreSQL 当数据库,n8n 默认的 SQLite 在并发高时撑不住。WEBHOOK_URL非常重要:工作流要被外部系统通过 Webhook 触发时,生成的回调地址就以此为基础,生产环境要填真实域名。GENERIC_TIMEZONE=Asia/Shanghai让定时任务按北京时间跑,不然你设的"每天九点"可能变成凌晨。
不想自己部署也可以用官方云 n8n.cloud,注册即用,免费额度每月 2500 次执行,够个人试水。
五、第一个工作流:定时触发、HTTP 请求、发邮件
进入 n8n 主界面,点 Add Workflow,你会看到一张空白画布和一个添加首个节点的加号。整个 n8n 的操作哲学就是:画布上加节点、连线、配置每个节点,最后点右上角 Active 启用。我们搭一个最经典的工作流:每天早上九点抓一个汇率接口,把美元兑人民币汇率发到自己邮箱。
节点 1:Schedule Trigger(定时触发)。触发频率选 Daily,时间设 09:00,时区确认是 Asia/Shanghai。它就是个闹钟,到点触发,把控制权交给下一个节点。
节点 2:HTTP Request(抓接口)。Method 选 GET,URL 填一个免费汇率接口(例如 api.exchangerate-api.com 的 latest/USD),保存后点节点上的 Test step,下方会显示返回的 JSON,里面的 rates.CNY 字段就是汇率。
节点 3:Send Email(发邮件)。凭据选 SMTP(企业更稳)或 Gmail 授权,收件人填自己,主题写"今日美元汇率",正文用表达式语法引用上一个节点的数据:今日 USD/CNY = {{ $json.rates.CNY }}。
双花括号是 n8n 的表达式插值,里面可以写 JavaScript,能引用前面任何节点的输出。每个节点都能拿到前面所有节点的数据,这是 n8n 灵活性的核心。点 Active 上线,每天九点你都会收到一封汇率邮件。
六、AI 节点家族:把 LangChain 图形化
到这里你可能觉得 n8n 不过是个高级定时任务加 HTTP 调用器。真正让它区别于 Make 和 Airflow 的,是内置的一整套 AI 节点,底层就是 LangChain,相当于把 Agent 开发的核心概念图形化了。在节点面板里搜 AI,能看到六大类:
| 节点类别 | 包含节点 | 对应概念 |
|---|---|---|
| Agent | AI Agent、Conversational Agent | ReAct 式智能体 |
| Chain | LLM Chain、Summarization Chain、QA Chain | 提示词链 |
| Language Model | OpenAI、Anthropic、Cohere、Ollama 等 | LLM 接入层 |
| Memory | Window Buffer Memory、Postgres Chat Memory | 对话记忆 |
| Tools | Calculator、搜索、Wikipedia、HTTP Request、自定义工具 | Function Calling 的工具 |
| Output Parser | Structured Output Parser、Auto-fixing | 结构化输出 |
设计哲学与手写 Agent 一致:一个 AI Agent 节点等于一个 LLM 大脑、N 个工具、一份记忆、一段指令,把这些子节点像插件一样挂到 Agent 节点的插槽上,它就有了对应的本事。
配置思路(以"会查天气和算账的助手"为例):拖一个 AI Agent 节点;Model 插槽放 OpenAI 节点,填 API Key;Memory 插槽放 Window Buffer Memory,记住最近五轮对话;Tools 插槽挂 Calculator 和搜索工具,各自填好凭据;Prompt 写清楚"问数学用计算器,问天气用搜索";入口用 Chat Trigger 节点。之后在聊天框输入"北京明天天气怎么样,另外帮我算 123 乘 456",你会看到 Agent 自己决定先调搜索查天气、再调计算器算乘法,把两个结果整合成一句话回答。能力与手写的 Agent 几乎等价,但你一行代码都没写。
七、实战:邮件自动分类回复
把前面的东西串成一个能直接用在公司客服场景的工作流:客户发邮件进来,AI 自动分类为投诉、咨询或垃圾,投诉转人工,咨询自动回信,垃圾直接归档。整体流程:Email Trigger 监听收件箱,AI Agent 做分类并起草回复,Switch 节点按分类结果分三路,各自接创建工单加通知、发邮件、归档的动作。
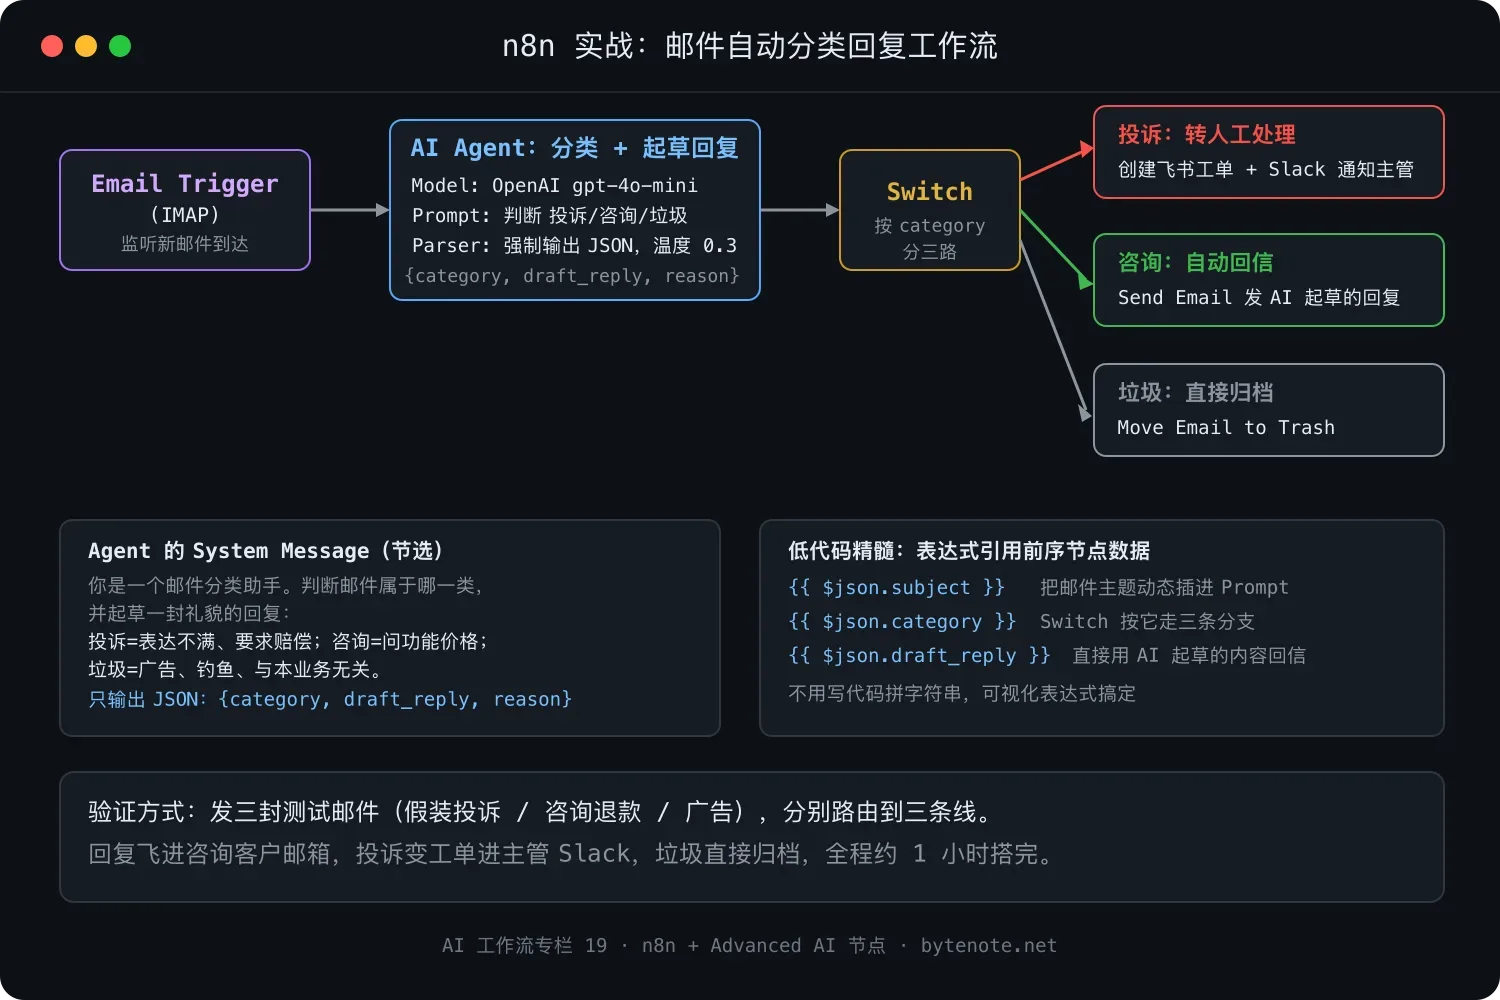
各节点配置要点:
- Email Trigger (IMAP):填 IMAP 服务器(Gmail 是 imap.gmail.com 的 993 端口,企业邮箱填自己的),建议用应用专用密码而不是主密码,监听 INBOX 的新邮件。节点会输出正文、发件人、主题等字段。
- AI Agent(核心):模型选便宜的 gpt-4o-mini,温度调到 0.3,分类任务要稳不要发散;挂 Structured Output Parser,强制输出 category、draft_reply、reason 三个字段的 JSON;System Message 里写清三类邮件的判断标准,并用
{{ $json.subject }}、{{ $json.textPlain }}这样的表达式把邮件主题和正文动态插进提示词。不用写代码拼接字符串,可视化表达式搞定。 - Switch(条件分支):相当于代码里的 switch case,按
{{ $json.category }}配三条路由规则。 - 三条分支:投诉路由接创建工单节点(接飞书、Jira、Linear 均可)再加一个通知节点提醒客服主管;咨询路由接 Send Email,收件人用
{{ $('Email Trigger').item.json.from }}回给原发件人,正文直接用 AI 起草的 draft_reply;垃圾路由接移动邮件节点,目标文件夹选 Trash。
启用工作流,发三封测试邮件:一封假装投诉、一封咨询退款、一封广告。它们会分别被路由到三条线,AI 起草的回复飞进咨询客户的邮箱,投诉变成工单进了主管的通知,垃圾直接归档。整个系统从零到跑起来不超过一小时,这就是 n8n 加 AI 的生产力。
八、Make 速览:RSS 更新、AI 总结、发 Telegram
Make 的上手比 n8n 还简单。以内容运营常用的工作流为例:某个博客有新文章,AI 总结成三句话,发到 Telegram 频道。
- 打开 make.com,用 Google 账号一键登录,点 Create a new scenario 进入画布。
- 加 RSS 模块,选 Retrieve RSS items,填一个博客的 RSS 地址,它会被定时拉取新文章。
- 从 RSS 模块拉一根线出来,加 OpenAI 模块,选 Create a Chat Completion,配置 API Key,提示词写"用中文把下面文章总结成三句话",输入字段引用 RSS 模块的 description。
- 再拉一根线,加 Telegram 模块,选 Send a Text Message,Bot Token 在 Telegram 里找 BotFather 创建机器人后获取,目标填频道,文本引用 OpenAI 模块的输出。
- 左下角时钟图标设成每 30 分钟检查一次 RSS,保存并打开开关。
体验非常顺滑,连接器数量是它的杀手锏。但记住前面说的硬伤:你的文章内容、API Key、频道信息都要过它的欧洲服务器,换到客户邮件、内部工单这类敏感数据,就别用它了。
九、Airflow 速览:用 Python 写定时 ETL
最后看一眼 Airflow,理解它为什么不适合 AI 工作流、却适合数据管道。一个最简的每日营收 ETL:
from datetime import datetime
from airflow import DAG
from airflow.operators.python import PythonOperator

def extract_data():
    """从业务库抽数据(这里用 print 模拟)"""
    print("从 MySQL 抽取昨天的新订单数据")
    return [{"order_id": 1, "amount": 99.5}, {"order_id": 2, "amount": 200}]

def transform_data(**context):
    """清洗转换,任务之间用 XCom 传数据"""
    raw = context["ti"].xcom_pull(task_ids="extract")
    total = sum(o["amount"] for o in raw)
    return {"total_revenue": total, "order_count": len(raw)}

def load_to_warehouse(**context):
    """写进数仓"""
    result = context["ti"].xcom_pull(task_ids="transform")
    print(f"写入数仓:{result}")

with DAG(
    dag_id="daily_revenue_etl",
    schedule="@daily",              # 每天跑一次,也支持 cron 表达式
    start_date=datetime(2026, 1, 1),
    catchup=False,                  # 不补历史数据
    default_args={"retries": 2},    # 失败自动重试 2 次
) as dag:
    extract = PythonOperator(task_id="extract", python_callable=extract_data)
    transform = PythonOperator(task_id="transform", python_callable=transform_data)
    load = PythonOperator(task_id="load", python_callable=load_to_warehouse)
    # 用 >> 定义执行顺序
    extract >> transform >> load
看完这段代码能感觉到 Airflow 的气质:它强在调度和依赖,每天准点跑、失败了重试、上游挂了下游自动停;弱在交互,一个 DAG 跑起来要几分钟,做不了用户发消息秒回的实时对话;没有 AI 抽象,没有 LLM 节点、Prompt 管理和 Agent 概念。所以 Airflow 是数据工程师的兵器,不是 AI 工作流工程师的兵器。但如果你的公司有"每天定时把昨天的客服对话喂给大模型生成质检报告"这类需求,让 Airflow 负责调度、通过 Webhook 触发 n8n 处理 AI 那一段、n8n 完成后回写结果,是非常合理的组合。
十、用 Webhook 打通低代码与代码系统
招聘 JD 里"能将低代码工作流与代码级系统集成"这句话,落到实处就是:n8n 不是孤岛,它要和你的 FastAPI、数据库、前端互相调用,桥梁是 Webhook,本质上就是一个"别人 HTTP POST 过来、你接住"的接口。n8n 既能当接收方(被别人触发),也能当发送方(去调别人的接口)。
方向一:你的代码调用 n8n(触发工作流)。场景是 FastAPI 后端收到用户注册请求后,想触发"发欢迎邮件、落库、通知运营群"这串副作用。n8n 端在工作流最前面放一个 Webhook 节点,Method 选 POST,Path 填 new-user,启用后得到完整回调地址,请求 body 里的字段就能在后续节点用 {{ $json.email }} 引用。你的代码端在注册逻辑里异步发一个请求过去:
# fastapi_app.py:用户注册后触发 n8n 工作流
import os, httpx
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI()
N8N_WEBHOOK_URL = os.getenv("N8N_WEBHOOK_URL", "http://localhost:5678/webhook/new-user")

class RegisterReq(BaseModel):
    email: str
    name: str

@app.post("/register")
async def register(req: RegisterReq):
    # 1. 自己的业务逻辑:写数据库、生成 token 等
    user_id = save_to_db(req.email, req.name)
    # 2. 异步触发 n8n 工作流,不等它完成,避免阻塞响应
    async with httpx.AsyncClient() as client:
        await client.post(N8N_WEBHOOK_URL, json={
            "user_id": user_id,
            "email": req.email,
            "name": req.name,
        }, timeout=5.0)
    return {"msg": "注册成功,欢迎邮件稍后送达", "user_id": user_id}

def save_to_db(email, name):
    # 省略数据库写入
    return hash(email) % 100000
这种模式叫事件驱动:你的代码只负责核心业务(写库、鉴权),把"发邮件、落表、通知群"这类副作用丢给 n8n 异步处理。好处是 FastAPI 响应快,不用等发邮件;副作用以后要改也不用重新发版,运营想把邮件换成 IM 通知,在 n8n 画布上换一个节点就行。
方向二:n8n 调用你的代码(复杂逻辑下沉)。场景是工作流跑到某一步要做复杂风控判断,要查五张表再跑一个机器学习模型,这种逻辑用 n8n 的代码节点写 JavaScript 太吃力,应该让专业代码来。FastAPI 暴露一个内部接口:
@app.post("/internal/risk-check")
async def risk_check(payload: dict):
    score = await run_ml_model(payload["user_id"])
    return {"risk_score": score, "decision": "block" if score > 0.8 else "pass"}
n8n 端加一个 HTTP Request 节点,POST 到这个内部接口,body 里用 {{ $json.user_id }} 引用前一个节点,后续节点再用返回的 decision 字段做分支。
这就是"低代码加代码混合架构"的精髓:简单的串联、调度、第三方对接交给 n8n 拖拽,图快;复杂算法、核心业务逻辑留在代码里,图稳。两者用 Webhook 解耦,各取所长。
十一、选型决策与三层组合
落到实战,给你一个需求该选哪个?四种典型场景:
| 你的场景 | 推荐平台 | 理由 |
|---|---|---|
| 个人自动化(抓 RSS 推频道、自动备份文件) | Make 或 n8n 云版 | 上手最快、连接器多、不用维护服务器,数据不敏感 |
| 团队协作自动化(IM 通知、工单流转、跨 SaaS 串联) | n8n 自部署 | 数据合规、可多人协作编辑、工作流可导出 JSON 入 Git |
| 企业数据管道 ETL(抽数、跑批、生成报表) | Airflow | 调度、重试、依赖、补数是它的本职,n8n 撑不住大规模批处理 |
| AI 客服、邮件自动处理等含 LLM 的自动化 | n8n | 唯一原生集成 LangChain AI 节点的,Make 的 AI 能力弱,Airflow 没有 |
两个混合策略值得记住。其一是 Airflow 加 n8n:Airflow 做总调度,每天凌晨触发,到 AI 那一步通过 Webhook 调 n8n,n8n 处理完回写,重型调度加轻量 AI 编排。其二是 n8n 加 LangGraph:n8n 负责把邮件、CRM、IM 串起来,遇到需要复杂 Agent 推理的步骤,HTTP 调你用 LangGraph 写的服务,胶水流加深度的 AI 内核。
心法一句话:这些平台不是二选一,而是按层组合。Airflow 是数据层,n8n 是业务流层,LangGraph 与 Dify 是 AI 内核层,一个成熟的企业 AI 系统往往三层都有。选型口诀:个人与营销自动化选 Make,企业内部自动化和 AI 工作流选 n8n 自部署,数据管道选 Airflow。
本篇小结
- 自动化编排平台是系统之间的分拣中心,专注跨系统串联,AI 可能只是其中一环。
- LangGraph 与 Dify 编排 AI 思考,n8n、Make、Airflow 编排系统之间,分工协作而非替代。
- n8n 开源可自部署且内置 AI 节点,Make 云端易用但数据出境,Airflow 专注企业级 ETL。
- 一条 docker run 命令部署 n8n,注意 WEBHOOK_URL 与时区两个环境变量。
- 定时、HTTP、发邮件的三节点工作流,用表达式语法跨节点引用数据。
- AI 节点家族底层是 LangChain,模型、记忆、工具、输出解析全部图形化,零代码搭 Agent。
- 邮件自动分类回复是 n8n 加 AI 的经典生产案例,投诉转工单、咨询自动回、垃圾归档。
- 代码级集成靠 Webhook 双向打通:代码 POST 触发 n8n 做事件驱动的副作用,n8n HTTP Request 把复杂逻辑下沉到代码。
写在最后
低代码编排补齐之后,你手里有了三件套:LangGraph 精确控制 AI 内核,Dify 零代码搭 AI 应用,n8n 把 AI 和几十个外部系统串起来,能覆盖一个企业大部分的自动化需求。剩下的问题是,每接一个新系统,你都得手写一次"鉴权、调接口、解析返回"的胶水代码,每个工具的接口都不一样。这正是 MCP(Model Context Protocol,模型上下文协议)要解决的事:工具按统一标准实现一次,任何支持它的 AI 客户端都能即插即用,下一篇展开。