字节笔记本
2026年10月6日 · 约 40 分钟读完
AI 工作流专栏 21:Ollama 与 vLLM 实战
本文是《从零成为 AI 工作流工程师》专栏第 21 篇,主题是本地模型部署。此前我们调用的模型都跑在云端:OpenAI、Claude、通义、DeepSeek,请求发出去,token 按量扣费。这就像天天点外卖:方便,但贵、慢,还有隐私顾虑(你点过什么,平台一清二楚)。这一篇换个活法:自己在家做饭,把开源大模型下载到自己的电脑或服务器上跑,这就是本地模型部署。它也是 AI 工作流工程师招聘里高频出现的加分项:有 Ollama 或 vLLM 的部署经验。本文会用 Ollama 一行命令跑起 Qwen3,用 vLLM 搭一个能扛高并发的生产级推理服务,最后算一笔"自己部署到底划不划算"的账。
你将学到:
- 为什么有时候必须本地部署(数据敏感、降本、离线三大场景)
- 2026 年主流开源大模型一览:Llama 4、Qwen3、DeepSeek、GLM、Mistral 及其参数规模
- 参数规模(7B/14B/70B)与显存需求的对应关系,怎么挑模型
- Ollama 实战:安装、ollama run 一行跑模型、OpenAI 兼容 API、Modelfile 自定义
- 显存与量化的核心概念:fp16 与 Q4_K_M、GGUF 格式、消费级显卡选购建议
- vLLM 实战:为什么生产用它(PagedAttention 与连续批处理)、vllm serve 启动、压测对比
- 部署架构演进:单机、多机多卡、K8s 加 vLLM
- 本地部署与 API 的成本盈亏平衡点,什么时候自己部署才值
- 本地部署常见的坑:OOM、首 token 延迟、模型维护、指令跟随变弱
一、为什么要本地部署:从"下馆子"到"在家做饭"
调 API 就是下馆子。你坐下点单(发请求),厨师(云端模型)做好端上来(返回结果),你付钱走人。优点是省心、零启动成本、菜品(模型)顶级;缺点也明显:贵(每顿都要付钱,吃得越多花得越多),慢(有网络往返延迟),没隐私(你聊了什么,服务商都经手),还得看营业时间(API 限流、服务商宕机你就饿肚子)。
本地部署就是在家做饭。你自己买食材(下载模型权重)、自己有灶台(GPU)、自己掌勺(推理引擎)。优点是省钱(食材成本固定,做多少顿都不加钱)、私密(在自己厨房,没人知道你做了啥)、可控(火候、配料全自己定)、永远营业(断网也能做)。代价是得自己买灶台(硬件投入)、自己备菜(部署运维),而且菜谱可能不如米其林(开源模型有时不如旗舰闭源)。
专业定义:本地模型部署(Local Model Deployment),指把开源大模型的权重文件下载到你自己掌控的硬件(个人电脑、公司服务器、私有云)上,用推理框架(Ollama、vLLM、llama.cpp、TGI 等)加载并提供服务,整个推理过程数据不出你的网络边界。
1.1 三大刚需场景
不是所有项目都要本地部署,大多数轻量场景调 API 就够了。但有三种情况,本地部署几乎是唯一选择:
场景一:数据敏感(医疗、金融、政企、法律)
一家三甲医院要做病历智能摘要,患者隐私数据能发到第三方云端吗?绝对不行,这是合规红线(HIPAA、个人信息保护法、数据安全法)。一家律所要用 AI 审合同,里面是客户的并购机密,也不敢往云端传。这类场景数据绝不能出境,只能在自己内网跑模型,是本地部署最硬核的场景。
场景二:降本(高频、大体量调用)
假设你做了个 AI 翻译产品,每天要处理 1 亿 token。按某闭源 API 输出每百万 token 2 元算,光翻译一个月就是几万块。而本地部署一台带 4090 的服务器(约 1.5 万元硬件成本加电费),边际成本趋近于零,几个月就能回本。当调用量大到一定程度,API 的按量计费反而比固定硬件成本更贵,这就是后文要算的盈亏平衡点。
场景三:离线、内网、合规(军工、工厂、远洋、离线设备)
远洋货轮上的设备、深山里的工厂车间、涉密单位的内网,这些地方压根没有外网,想调 API 也调不了,但业务又需要 AI 能力。这时只能本地部署,把模型塞进设备里。这也是 Ollama 在 Mac 上特别流行的一个原因:很多人在离线环境同样想用 AI。
小结:调 API 省心但贵、慢、有隐私顾虑,本地部署省钱、私密、可控但要自己运维;数据敏感、高频降本、离线内网三大场景满足其一,就该认真考虑本地部署;其余轻量、低频、对隐私不敏感的场景,老老实实调 API,别为了听起来酷而上本地部署。
二、主流开源大模型一览(2026 版)
开源模型就像各路大厨公开的家常菜谱,谁都能拿到、谁都能照着做。有人擅长川菜(中文强),有人擅长法餐(英文强),有人是全科大厨(综合)。2026 年的开源阵营基本是这几家:
| 模型家族 | 出品方 | 强项 | 代表型号(2026) | 开源协议 |
|---|---|---|---|---|
| Qwen 通义千问 | 阿里 | 中文最强之一、综合均衡、生态完整 | Qwen3-8B / 14B / 32B / 235B | Apache 2.0(部分) |
| Llama | Meta | 英文与代码强、社区最大、工具齐全 | Llama 4 Scout / Maverick(MoE) | Llama 协议(受限商用) |
| DeepSeek | 深度求索 | 推理强(R1)、性价比极高 | DeepSeek-V3 / R1 蒸馏系列 | MIT |
| GLM 智谱 | 智谱 AI | 中英双语、Agent 能力强 | GLM-4-9B / GLM-Z1 | MIT / Apache |
| Mistral | Mistral AI(法国) | 轻量高效、MoE 先锋 | Mistral / Mixtral 8x7B | Apache 2.0 |
新手选型建议:中文场景优先 Qwen3(开源生态最好,Ollama 与 vLLM 支持最完善);英文与代码优先 Llama;要强推理又想省钱选 DeepSeek-R1 蒸馏版。
2.1 参数规模与"几 B"是什么意思
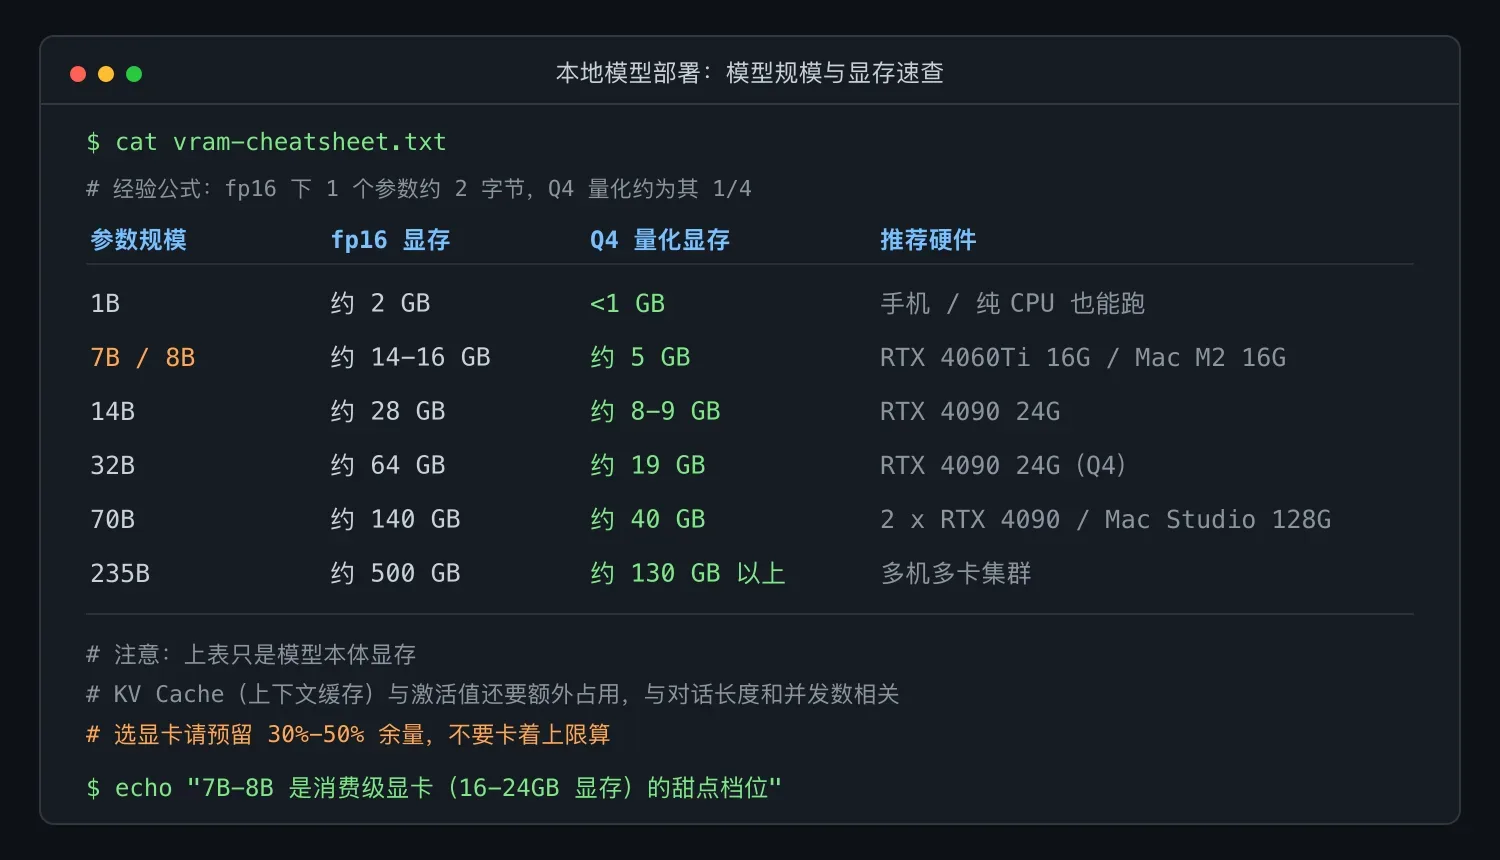
"7B"就是 70 亿参数(B 是 Billion,十亿)。参数是模型的脑细胞数量,越多越聪明,但也越吃显存。经验公式:fp16 半精度下,1 个参数占 2 字节。
- 1B 模型:约 2GB 显存(fp16),量化后不到 1GB,手机都能跑
- 7B / 8B 模型:约 14 至 16GB 显存(fp16),量化后约 5GB,是消费级显卡的甜点
- 14B 模型:约 28GB 显存,量化后约 8-9GB
- 32B 模型:约 64GB 显存,量化后约 19GB
- 70B 模型:约 140GB 显存,量化后约 40GB(要 2 张 4090)
- 235B(Qwen3 旗舰):fp16 要近 500GB,量化也要 130GB 以上(多机多卡)
注意:上面只是模型本体的显存。实际推理还需要额外显存放 KV Cache(上下文缓存,跟对话长度和并发数相关)和激活值,所以选显卡要留出 30% 到 50% 的余量,别卡着上限算。
小结:2026 开源五大家是 Qwen3(中文首选)、Llama 4、DeepSeek、GLM、Mistral;参数规模越大越聪明越吃显存,7B-8B 是消费级显卡(16-24GB 显存)的甜点;选模型先看任务,再看硬件,最后看协议能否商用。
三、Ollama 实战:个人与开发首选的一键跑模型
Ollama 就像家用微波炉:插上电、放进去(下载模型)、按一个按钮(ollama run),叮一声就好了。你完全不用懂磁控管怎么产生微波(底层 llama.cpp 怎么推理),它把模型下载、量化、显存管理、API 服务全包了。对个人开发者和小项目,Ollama 是上手成本最低的选择,没有之一。
专业定义:Ollama 是一个开源的本地大模型运行框架,底层基于 llama.cpp(C++ 写的高效推理引擎),封装了模型拉取、量化、加载、OpenAI 兼容 API 等一整套能力,核心卖点是一行命令就能跑起一个模型并对外提供 API。
3.1 安装(三平台)
macOS(最简单):去官网 https://ollama.com/download 下载 Ollama-darwin.zip,解压拖进 Applications 即可。Mac 用户尤其受益:M 系列芯片的统一内存(Unified Memory)让显存就是内存,一台 64GB 的 Mac Studio 能跑 70B 量化模型,这在 PC 上要花几万块买卡。
Windows:同样去官网下载 OllamaSetup.exe,双击安装,装完后命令行就有 ollama 命令。Windows 11 加 WSL2 是绝佳组合。
Linux(一行脚本):
curl -fsSL https://ollama.com/install.sh | sh装完验证:
ollama --version
# 输出类似:ollama version is 0.x.x
3.2 一行命令跑模型
# 下载并运行 Qwen3 8B(首次会下载约 5GB 的量化权重)
ollama run qwen3:8b
第一次执行会拉取模型(几分钟,取决于网速),下完就进入交互式对话界面:
>>> 你好,介绍一下你自己
我是 Qwen,阿里云训练的大语言模型……
就这么简单,你已经成功跑起一个本地大模型了。再试几个其他模型:
ollama run llama3.1:8b       # Meta Llama
ollama run deepseek-r1:8b    # DeepSeek 推理模型
ollama run glm4:9b           # 智谱 GLM
ollama run qwen3:14b         # 更大的 Qwen3
查看已下载的模型:
ollama list
# NAME           ID            SIZE      MODIFIED
# qwen3:8b       xxxxxxx       5.2 GB    2 minutes ago
删除不要的模型(释放磁盘):
ollama rm qwen3:8b3.3 关键杀手锏:Ollama 兼容 OpenAI API
这是 Ollama 最香的一点:它内置一个 OpenAI 兼容的 HTTP 服务,跑在 http://localhost:11434/v1。这意味着你已有的所有调 OpenAI 的代码,改一个 base_url 就能无缝切到本地模型,业务代码一行都不用动。
用 curl 直接测:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3:8b",
    "messages": [{"role": "user", "content": "用一句话解释什么是向量数据库"}],
    "stream": false
  }'
用 Python OpenAI SDK:
from openai import OpenAI

# 只改 base_url 和 api_key(随便填),其余完全一样
client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama",  # 本地随便填,不校验
)

resp = client.chat.completions.create(
    model="qwen3:8b",
    messages=[{"role": "user", "content": "写一首关于本地部署的诗"}],
)
print(resp.choices[0].message.content)
这就是零成本切换:你的统一模型适配层(比如一个 LLMClient 类)只要多加一个 local 实现,指向 localhost:11434,开发时用本地模型省钱,上线时切回云 API 保证质量。
3.4 Modelfile:自定义你的专属模型
Ollama 支持用 Modelfile(类似 Dockerfile 的概念)把一个基础模型加系统提示加参数打包成一个自定义模型。比如做一个永远用鲁迅文风回答的模型,创建文件 Modelfile:
# 基于哪个模型
FROM qwen3:8b

# 系统提示(角色设定)
SYSTEM """
你是一位精通鲁迅文风的作家。无论用户问什么,
你都要用鲁迅那种冷峻、犀利、半文半白的笔调来回答。
"""

# 推理参数
PARAMETER temperature 0.8
PARAMETER top_p 0.9
PARAMETER num_ctx 8192
构建并运行:
ollama create luxun -f ./Modelfile
ollama run luxun
# >>> 今天天气真好
# 大约,这阳光是好的罢。然而我心里并无端地觉得悲凉……
这个能力在做特定角色或行业垂直应用时特别有用:同一个底座模型,换个 SYSTEM 提示就能变成客服、医生、文案。
3.5 实战:Ollama 加 FastAPI 做一个零成本 ChatBot
把 Ollama 和一个 FastAPI 后端组合起来,就能做一个完全免费、数据不出本机的 ChatBot:
# chatbot_local.py
from fastapi import FastAPI
from pydantic import BaseModel
from openai import OpenAI

app = FastAPI()
client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")

class ChatRequest(BaseModel):
    message: str

@app.post("/chat")
def chat(req: ChatRequest):
    resp = client.chat.completions.create(
        model="qwen3:8b",
        messages=[{"role": "user", "content": req.message}],
    )
    return {"reply": resp.choices[0].message.content}

# 启动:uvicorn chatbot_local:app --reload --port 8000
跑起来后,前端调 POST http://localhost:8000/chat,背后是本地的 Qwen3 在回答。零 API 费用、数据完全在本机、断网也能用,这就是本地部署的魅力。
小结:Ollama 是本地模型的微波炉,一行 ollama run 跑起模型;它兼容 OpenAI API(localhost:11434/v1),已有代码改个 base_url 就能用;Modelfile 可以把基础模型加 SYSTEM 加参数打包成自定义模型;它适合个人开发、原型验证、本地工具,不适合扛生产高并发(那是 vLLM 的活)。
四、显存与量化:把大模型塞进你的显卡
量化就像把一张 4K 高清照片压缩成 JPEG:文件小了十倍,肉眼看着几乎没区别,但放大细看会损失一点细节。模型的"4K 原图"就是 fp16(每个参数用 16 位浮点数存,精度高、体积大);量化成 Q4(每个参数只用 4 位)后体积缩到四分之一,显存占用大降,效果只损失一点点。这就是为什么 8GB 显存的显卡也能跑 7B 模型,靠的就是量化。
专业定义:量化(Quantization),指把模型权重从高精度浮点数(fp16/fp32)转换为低精度表示(int8/int4)的过程,目的是用更少显存存同样的模型,代价是精度小幅下降。
主流量化格式与显存对比(以 7B 模型为例):
| 量化级别 | 每参数位数 | 显存占用 | 效果损失 | 适用场景 |
|---|---|---|---|---|
| fp16(半精度) | 16 bit | 约 14 GB | 无损 | 训练、显存充裕、追求最佳效果 |
| Q8(8-bit) | 8 bit | 约 7.5 GB | 几乎无 | 显存够、想兼顾效果 |
| Q5_K_M | 5 bit | 约 5.5 GB | 很小 | 平衡型选择 |
| Q4_K_M(4-bit) | 4 bit | 约 4.5-5 GB | 小 | 性价比甜点 |
| Q3 / Q2 | 3-2 bit | 约 3 GB | 明显 | 极端省显存,不推荐 |
4.1 GGUF:llama.cpp 系的通用格式
GGUF(GPT-Generated Unified Format)是 llama.cpp 生态的标准模型文件格式,一个 .gguf 文件里打包了模型权重、配置和量化信息。Ollama 底层就是 llama.cpp,所以 Ollama 拉的模型本质就是 GGUF 文件。你在 HuggingFace 上看到的 xxx-Q4_K_M.gguf,就是量化好的、可以直接被 Ollama 或 llama.cpp 加载的模型。
为什么是 Q4_K_M?这是社区公认的性价比甜点:K 表示使用了 k-quant(更聪明的量化方法),M 表示 medium(中等分组)。它在"显存省一半多"和"效果几乎不掉"之间取得了最佳平衡,绝大多数本地部署默认就用它。
4.2 消费级硬件选购建议
- 入门(跑 7B Q4):RTX 4060 Ti 16GB / RTX 3060 12GB / Mac M2 16GB 统一内存,一两千到四千元价位。
- 主流(跑 14B Q4,或多并发 7B):RTX 4090 24GB / RTX 3090 24GB(二手 3090 性价比极高),这是本地部署的黄金配置。
- 高端(跑 32B Q4,或 70B Q4 多卡):RTX 4090 x2 / Mac Studio M2 Ultra 128GB(统一内存大杀器,能单机跑 70B)。
- 服务器级:A100 / H100(企业用,单卡 10 万元起)。
Mac 用户特别提示:Apple Silicon(M1/M2/M3/M4)的统一内存架构是本地部署的隐藏神器,显存和内存是同一块,一台 64GB 内存的 Mac 相当于有 64GB"显存",能跑 PC 上要花天价才能跑的大模型。所以很多 AI 独立开发者首选 Mac Studio。
小结:量化是把 fp16 压成 Q4,显存省 70% 以上,效果几乎不掉;Q4_K_M 是甜点,本地部署默认选它;GGUF 是 llama.cpp 与 Ollama 的标准格式;消费级黄金配置是 4090 24G(PC)或 Mac M 系列 32G 以上(统一内存)。
五、vLLM 实战:扛生产高并发的工业级流水线
如果说 Ollama 是家用微波炉(一次热一份,够自己吃),那 vLLM 就是中央厨房的工业级流水线:能同时给几百人做饭,盘子(请求)进来一个接一个不停,炉子(GPU)永远满负荷运转。为什么生产环境不用 Ollama?因为 Ollama 是一个请求算一次,来了 100 个并发请求它就排队慢慢来;而 vLLM 用两个核心创新(PagedAttention 与连续批处理)让 GPU 利用率飙到 90% 以上,吞吐量是原生 transformers 的 10 到 20 倍。
专业定义:vLLM 是加州大学伯克利分校开源的高性能 LLM 推理引擎,专为生产高并发场景设计。它的两个核心创新:
- PagedAttention(分页注意力):借鉴操作系统的虚拟内存分页机制,把 KV Cache(上下文缓存)切成固定大小的"页"按需分配,避免传统方案"按最长序列预分配"导致的显存浪费,显存利用率从约 40% 提升到约 96%。
- Continuous Batching(连续批处理):传统批处理要等一批请求都生成完才处理下一批(一个慢的拖垮一整批);连续批处理是谁生成完谁先走,空出位置立刻塞进新请求,GPU 永远不空转。
5.1 安装与启动
vLLM 需要 GPU(NVIDIA,CUDA 12 以上),推荐 Linux。安装:
# 推荐用虚拟环境
python -m venv vllm-env && source vllm-env/bin/activate
pip install vllm
启动一个 OpenAI 兼容的服务器(一行命令):
# 用 HuggingFace 模型 ID 启动 Qwen3-8B
vllm serve Qwen/Qwen3-8B \
  --port 8000 \
  --max-model-len 8192
说明:vLLM 默认从 HuggingFace 拉取原始权重(fp16),所以比 Ollama 吃更多显存。8B 模型 fp16 需要约 16GB 显存,建议 4090 24G 或更大。如果显存不够,可以用 AWQ / GPTQ 量化版的模型 ID,比如 Qwen/Qwen3-8B-Instruct-AWQ。
启动后,服务跑在 http://localhost:8000,完全兼容 OpenAI API:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen3-8B",
    "messages": [{"role": "user", "content": "vLLM 和 Ollama 的区别?"}]
  }'
Python 调用(和调 OpenAI 一模一样):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="vllm")
resp = client.chat.completions.create(
    model="Qwen/Qwen3-8B",
    messages=[{"role": "user", "content": "用一句话介绍你自己"}],
)
print(resp.choices[0].message.content)
5.2 压测对比:感受 vLLM 的吞吐
用一个简单的并发压测脚本,看 vLLM 和串行调 Ollama 的差距:
# benchmark.py,并发发 50 个请求,统计总耗时
import asyncio, time
from openai import AsyncOpenAI

async def main():
    client = AsyncOpenAI(base_url="http://localhost:8000/v1", api_key="vllm")
    async def one():
        return await client.chat.completions.create(
            model="Qwen/Qwen3-8B",
            messages=[{"role":"user","content":"写一首五言绝句"}],
            max_tokens=100,
        )
    t0 = time.time()
    await asyncio.gather(*[one() for _ in range(50)])
    print(f"50 个并发请求总耗时: {time.time()-t0:.1f}s")

asyncio.run(main())
典型结果(4090 24G,Qwen3-8B,50 并发):
- Ollama(串行):约 50-90 秒(一次一个,排队)
- vLLM(连续批处理):约 5-10 秒(并行打满 GPU)
差距大约 8 到 15 倍。这就是为什么生产高并发场景必须用 vLLM:同样一张卡,它能服务多一个数量级的用户。
5.3 Ollama 与 vLLM 怎么选
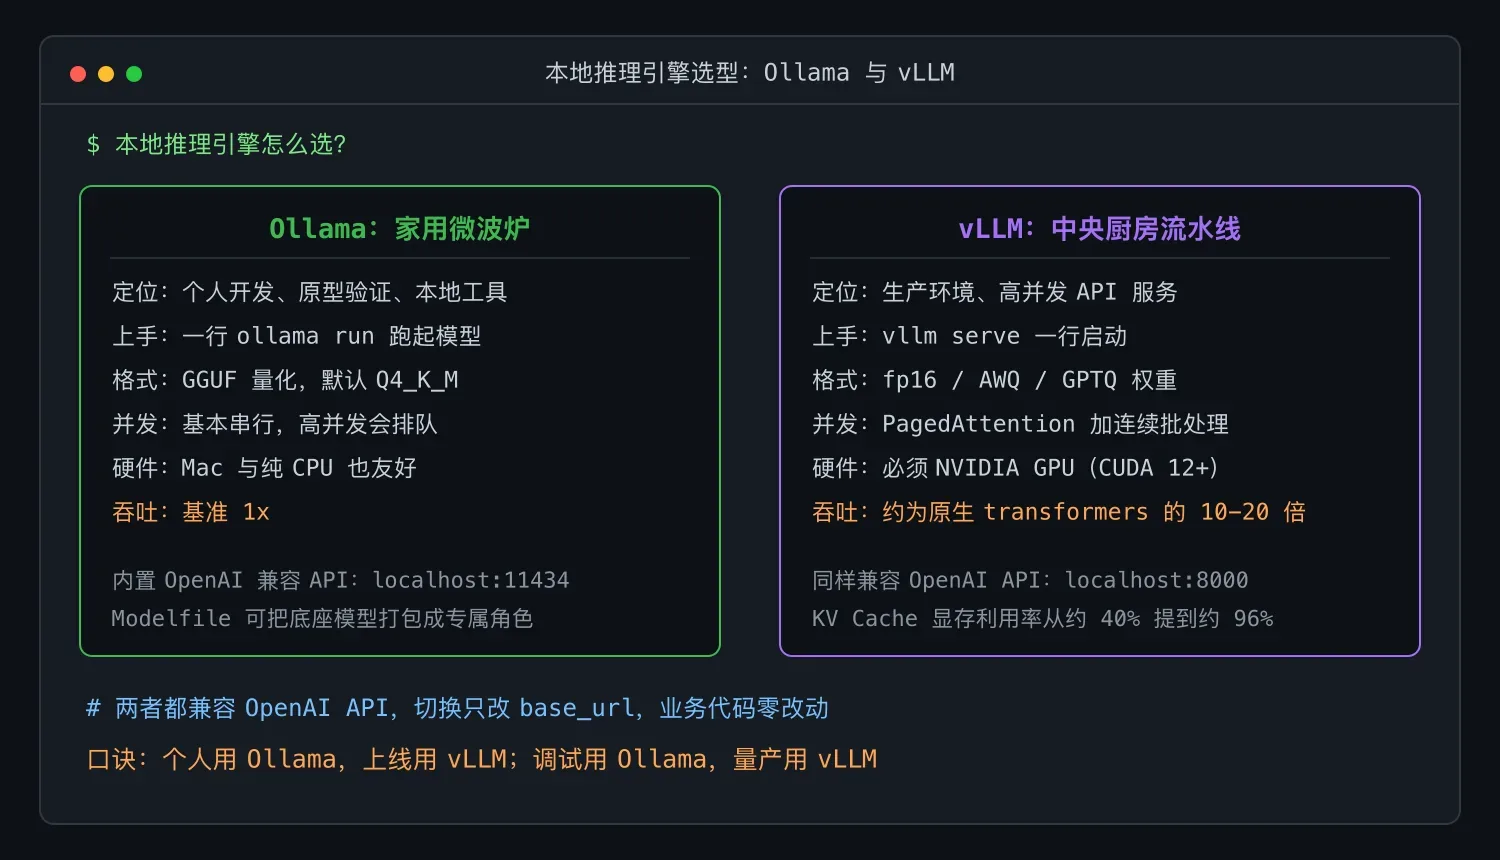
| 维度 | Ollama | vLLM |
|---|---|---|
| 定位 | 个人、开发、原型 | 生产、高并发服务 |
| 量化 | 默认 GGUF(Q4) | 默认 fp16 / AWQ / GPTQ |
| 并发 | 弱(基本串行) | 强(连续批处理) |
| 上手 | 极简(一行命令) | 需要懂参数调优 |
| 硬件 | CPU 也行,Mac 友好 | 必须 NVIDIA GPU |
| 吞吐 | 1x | 10-20x |
| 场景 | 本地工具、调试、私有助手 | API 服务、Agent 后端、批量推理 |
口诀:个人用 Ollama,上线用 vLLM;调试用 Ollama,量产用 vLLM;Mac 用 Ollama,A100 用 vLLM。
小结:vLLM 是工业级推理流水线,靠 PagedAttention 与连续批处理把 GPU 榨干;生产高并发必须用它,吞吐是 Ollama 与原生 transformers 的 10-20 倍;它也兼容 OpenAI API(vllm serve 一行启动),代码切换无缝。
六、部署架构:从单机到 K8s
部署架构的演进就像开店:从路边摊(单机)到连锁店(多机多卡),再到全国加盟总部(K8s 集群)。
Level 1:单机部署(个人与小项目)
一台机器加一个 Ollama 或 vLLM 进程,直接对外服务。适合个人助手、内部小工具、PoC 演示。
[用户] -> [Nginx/反向代理] -> [vLLM 进程 (GPU)] -> 模型
Level 2:多机多卡(企业中等规模)
当单卡装不下大模型(如 70B 需要多卡张量并行),或单机吞吐不够时,上多卡甚至多机。vLLM 原生支持张量并行(Tensor Parallel,TP)跨卡切分模型:
# 2 卡张量并行跑 70B
vllm serve Qwen/Qwen2.5-72B-Instruct \
  --tensor-parallel-size 2 \
  --port 8000
[负载均衡] -> [vLLM 节点1 (2卡)] / [vLLM 节点2 (2卡)] -> 共享模型权重
Level 3:K8s 加 vLLM(大规模与弹性伸缩)
大厂和 AI 平台用 Kubernetes 编排 vLLM 实例,配 HPA(水平自动扩缩容)根据流量动态加减 Pod,再前置一层网关做路由、限流、多模型分发。常见搭配是 K8s 加 vLLM 加 Ray Serve 加 KServe,模型权重放分布式存储(如 JuiceFS),实现秒级扩容。
[API 网关] -> [K8s Ingress] -> [vLLM Pods (HPA 弹性)] <- [模型权重存储]
                              [监控: Prometheus + Grafana]
小结:个人与小项目用单机 Ollama 或 vLLM;企业中等规模用多机多卡加张量并行;大规模弹性场景上 K8s 加 vLLM 加自动扩缩容。
七、成本对比:本地部署与 API,什么时候才值
继续做饭的比喻:买锅灶(硬件)对比顿顿点外卖(按量付费)。偶尔吃一顿,点外卖划算;天天吃、顿顿吃,买锅灶很快回本。本地部署和 API 的账也是这么算的。
假设场景:你的产品用 8B 级别模型,每月稳定消耗 3 亿 token(输入输出各半)。
方案 A:调 API(按某国产模型输出每百万 token 2 元、输入每百万 token 1 元算)
- 月成本约 450 元(1.5 亿输出约 300 元,加 1.5 亿输入约 150 元)
- 一年约 5400 元
- 优点:零硬件投入、即开即用、模型自动升级
方案 B:本地部署(一台 4090 24G 主机)
- 硬件一次性投入约 15000 元(整机含 4090)
- 电费:满载 450W 乘 24 小时乘 30 天乘 0.8 元/度,约 260 元/月
- 月边际成本约 260 元(电费为主)
- 首年总成本约 18100 元(15000 元硬件加全年电费约 3100 元)
从这笔账能看出几个关键规律:
- 首年 API 更省(5400 元对比 18100 元),因为硬件首期投入大。
- 长期看(2 到 3 年后)本地反超,因为 API 是线性增长,本地边际成本只有电费。
- 调用量越大,平衡点来得越早:如果月 token 消耗翻 5 倍(15 亿),API 月费涨到约 2250 元,本地部署约 8 个月就回本,这种场景上本地部署非常划算。
- 数据隐私无法用钱衡量:医疗、金融场景哪怕更贵也得本地,合规无价。
决策建议:
- 月消耗低于 1 亿 token、对隐私无硬要求:直接调 API,别折腾。
- 月消耗高于 5 亿 token、或数据敏感:认真考虑本地部署。
- 月消耗高于 50 亿 token、高并发:必须本地部署加 vLLM,否则 API 费用会拖垮公司。
小结:本地部署有硬件首期投入,API 是按量线性增长;月调用量越大、用得越久,本地部署越划算;隐私合规无价,敏感数据场景再贵也得本地。
八、本地部署的坑(避雷指南)
在家做饭也会翻车:锅太小菜溢出来(OOM)、火开太大烧焦(参数没调好)、菜谱更新了你还在用老版(模型没维护)、自己做的菜没餐厅好吃(开源不如闭源)。本地部署同理,有这几个经典坑。
坑 1:显存溢出(OOM)
最常见的报错。原因:模型太大、上下文太长、并发太高,KV Cache 把显存吃光了。
避坑方法:选模型先算显存(参数量乘 2 字节 fp16,再加 30% 余量);用 Q4 量化降显存;vLLM 用 --max-model-len 限制上下文长度,用 --gpu-memory-utilization 0.9 控制占用上限;平时用 nvidia-smi 监控显存,别等到崩了才发现。
坑 2:首 token 延迟(TTFT)高
用户发请求后等好几秒才开始出字。原因:模型首次加载到显存、长 prompt 的 prefill 计算慢。
避坑方法:服务启动后先发几个假请求让模型热起来;控制输入 prompt 长度(RAG 别一股脑塞 10 万字);对首字延迟敏感的服务优先用 vLLM,它的 prefill 优化比 Ollama 强很多。
坑 3:模型更新维护
开源模型迭代很快(Qwen 一年发了好几代),但你线上跑的是老版本。要不要升级?升级要不要重新评测?
避坑方法:线上模型版本固定,升级前先跑一套回归评测,用固定的评测集对比新旧版本表现;新模型先在灰度环境验证效果,再切流量。
坑 4:指令跟随变弱(不如闭源听话)
开源 7B 模型,尤其量化后,在严格按格式输出、拒答不该答的问题上,明显不如旗舰闭源模型。你的 JSON 提取、Function Calling 可能频繁出错。
避坑方法:关键结构化任务,Prompt 要写得更严格(明确输出格式与字段),或加一层校验加重试;用经过指令微调的 Instruct / Chat 版本,别用 Base 版;实在不行,这部分任务还是交给云 API。
坑 5:Mac 与 CPU 推理慢
在纯 CPU 或老 Mac 上跑,速度可能慢到无法忍受(每秒 1-2 个 token)。
避坑方法:Mac 必须用 M 系列芯片(统一内存加神经网络加速);纯 CPU 场景只跑 1B 到 3B 的小模型,或直接用云端 API。
小结:五大坑是 OOM、首 token 慢、模型维护、指令跟随弱、CPU 慢;避坑核心是算好显存留余量、量化降占用、做好监控、Prompt 加固、版本管理。
九、要点回顾
- 本地部署等于在家做饭:省钱、私密、可控,但要自己运维硬件。三大刚需场景:数据敏感、高频降本、离线内网。
- 2026 开源五大家:Qwen3(中文首选)、Llama 4、DeepSeek、GLM、Mistral;7B-8B 是消费级甜点。
- 参数对应显存:fp16 下 1 参数约 2 字节,7B 约 14GB;量化 Q4 后约 5GB。
- Ollama:个人与开发首选,一行 ollama run 跑模型,兼容 OpenAI API(localhost:11434/v1),Modelfile 可自定义模型。
- 量化:fp16 到 Q4_K_M 是性价比甜点,显存省 70% 以上,效果几乎不掉;GGUF 是 llama.cpp 与 Ollama 的标准格式。
- 消费级黄金配置:4090 24G(PC),或 Mac M 系列 32G 以上(统一内存)。
- vLLM:生产高并发之王,PagedAttention 加连续批处理,吞吐是 transformers 的 10-20 倍;vllm serve 一行启动,兼容 OpenAI API。
- 选型口诀:个人用 Ollama,上线用 vLLM;Mac 用 Ollama,A100 用 vLLM。
- 架构演进:单机,到多机多卡(张量并行),再到 K8s 加 vLLM(弹性扩缩容)。
- 成本账:API 是线性增长,本地有硬件首期但边际成本低;调用量越大、用得越久,本地越划算;隐私合规无价。
- 五大坑:OOM、首 token 慢、模型维护、指令跟随弱、CPU 慢;用算显存、量化、监控、Prompt 加固、版本管理来避坑。
十、动手练习
练习 1(基础):在你电脑上装 Ollama,ollama run qwen3:8b 跑起来,然后用 curl 调 http://localhost:11434/v1/chat/completions,问它"用 50 字解释 RAG"。感受一下:这个回答没花你一分钱 API 费,数据也没出你的电脑。
练习 2(进阶):写一个 Modelfile,基于 qwen3:8b,把 SYSTEM 设成"你是一个毒舌但专业的代码审查员,用犀利的语气指出代码问题",参数 temperature 0.7,用 ollama create 构建成 reviewer 模型,然后贴一段你写过的代码让它审。再给你的统一模型适配层加一个 local 实现,指向 Ollama,让它多一个零成本选项。
练习 3(挑战):如果你有 NVIDIA 显卡(16GB 以上),装 vLLM,vllm serve Qwen/Qwen3-8B,然后跑本文 5.2 节的并发压测脚本,把并发数从 10 调到 100,记录总耗时和吞吐量(token/秒),你会真切感受到工业级流水线和家用微波炉的差距。再进阶一点:用 --tensor-parallel-size 在双卡上跑一个更大的模型(14B 或 32B),观察显存是怎么被切分使用的。
十一、延伸阅读
- Ollama 官方文档(安装、命令、Modelfile):https://github.com/ollama/ollama
- Ollama 模型库(搜索可用模型):https://ollama.com/library
- Ollama OpenAI 兼容 API 文档:https://github.com/ollama/ollama/blob/main/docs/openai.md
- vLLM 官方文档(Quickstart、参数、部署):https://docs.vllm.ai
- vLLM GitHub 仓库:https://github.com/vllm-project/vllm
- PagedAttention 原始论文《Efficient Memory Management for Large Language Model Serving with PagedAttention》:https://arxiv.org/abs/2309.06180
- llama.cpp 项目(Ollama 底层引擎、GGUF 量化):https://github.com/ggerganov/llama.cpp
- GGUF 量化方法说明(k-quant 与 Q4_K_M 的含义):https://github.com/ggerganov/llama.cpp/blob/master/docs/development/quantization.md
- HuggingFace 开源模型库(下载权重):https://huggingface.co/models
最后预告:通用开源模型虽然不错,但在你的特定业务上总是差点意思,比如客服模型不够懂你家的产品术语、代码模型不熟悉你们的内部框架。Prompt 工程能救一时,救不了一世,终极解法是微调(Fine-tuning):用你自己的数据,把开源模型再训练成专属模型。专栏下一篇就讲 LoRA 与 QLoRA 这两个让消费级显卡也能微调大模型的技术,敬请期待。