字节笔记本
2026年10月6日 · 约 55 分钟读完
AI 工作流专栏 15:Agent 基础与 ReAct 循环
本文是《从零成为 AI 工作流工程师》系列专栏的 Agent 篇。很多人用大模型的姿势还停留在"被动问答":你问一句,它答一句,顶多帮你查个资料、调一个函数,它从不主动,从不反思,从不回头。但现实里的活儿没这么简单,你让 AI"帮我查下明天上海天气然后推荐穿搭",它得自己想:先查天气,再根据温度决定推短袖还是外套,最后组织成一句话。这个"自己拆步骤、自己挑工具、自己根据中间结果调整"的过程,就是 Agent(智能体)。本篇用一个核心类比,"派一个实习生去办事",把 Agent 的本质讲透,然后不依赖任何框架,用纯 Python 加 openai SDK 手写一个能跑的最小 Agent,带计算器、查时间、查天气三个工具。读完你会彻底明白:Agent 不是什么玄学,它的内核就是一个"LLM 自己决定要不要调工具"的 while 循环,也是你从"调 API 的人"升级为"设计智能体的人"的第一步。
本篇你将学到:
- Agent 到底是什么:用"派实习生买咖啡"类比,搞清它和单次 LLM 调用的本质区别
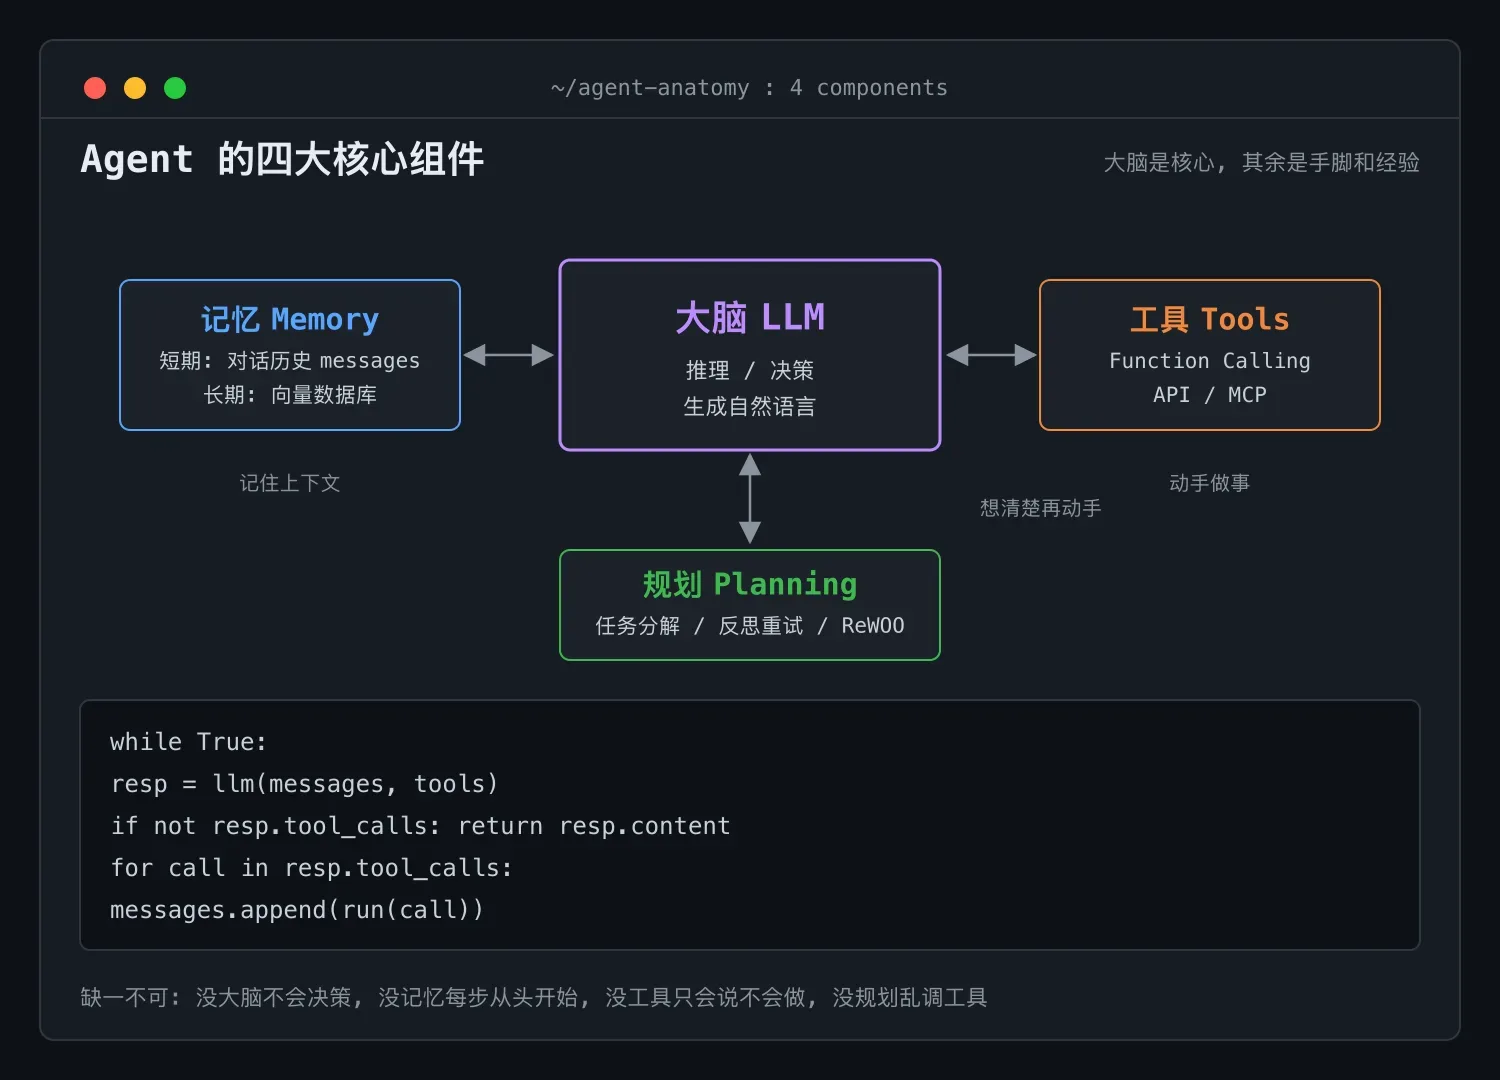
- Agent 的四大核心组件:大脑(LLM)、记忆(Memory)、工具(Tools)、规划(Planning)
- ReAct 范式(核心):Thought、Action、Observation 循环,用"查天气加推荐穿搭"的例子一步步演示
- 手写最小 Agent(重点,不用任何框架):纯 Python 加 openai SDK 实现 ReAct 循环,能调用 3 个工具
- Agent 的规划策略:任务分解(Task Decomposition)、Plan-and-Execute、ReWOO
- Agent 的记忆机制:短期记忆、长期记忆(向量库)、记忆总结(防上下文爆炸)
- Agent 与 Function Calling、Workflow 三者的根本区别
- Agent 的五大坑:死循环、烧钱、错误累积、不可控,以及为什么需要 HITL 和 LangGraph
Part A:Agent 是什么
一、什么是 Agent:从"派一个实习生去办事"说起
1.1 生活类比:实习生买咖啡
想象两种安排实习生干活的方式:
方式 A(像指挥传统 LLM 一样指挥):你站在实习生旁边,一步步发指令:"你现在走到电梯口""按下 1 楼""出电梯右转""看见星巴克走进去""对店员说一杯美式""扫码付款""拿好杯子回来"。实习生全程照做,但你必须步步指挥,少说一句他就卡住。
方式 B(像派一个 Agent 一样指挥):你只说一句:"帮我去楼下买杯美式回来,冰的还是热的你自己看着办,钱从我抽屉里拿。"然后你转身去开会。实习生自己规划路线、自己用手机支付、自己判断天气热不热决定冰热、路上发现星巴克排队太长就换一家瑞幸,最后把咖啡端到你桌上。
第二种方式里,实习生就是 Agent:你给的是目标,不是步骤;他用自己的判断力拆解任务、用工具(手机支付、导航)完成动作、根据反馈(排队太长)调整策略。
1.2 专业定义
把上面的类比翻译成技术语言:
Agent(智能体):一个以 LLM 为"大脑"、能自主感知(Perceive)、决策(Reason)、行动(Act)的系统。它接收一个目标(goal),自己决定调哪些工具(tools)、循环多步、根据每一步的观察结果(observation)调整下一步,直到任务完成。
关键词是自主。传统 LLM 调用是你写好 prompt、它吐一次答案就结束;Agent 是你给目标,它在一个循环里反复"思考、行动、观察",直到它自己判断"任务完成了"才停下。
1.3 和单次 LLM 调用的本质区别
| 维度 | 单次 LLM 调用(传统方式) | Agent(本篇的方式) |
|---|---|---|
| 输入 | 一句 prompt | 一个目标(goal) |
| 输出 | 一次性生成的文本 | 多步行动后的最终结果 |
| 工具使用 | 不用,或被你硬编码调用一次 | LLM 自己决定调不调、调几次、调哪个 |
| 循环 | 没有循环,一问一答 | while 循环,反复推理直到完成 |
| 错误处理 | 出错就出错,不会自我纠正 | 能观察到"失败了",自己换个思路重试 |
| 可控性 | 高(你写死每一步) | 低(LLM 自主决策,概率性) |
| 成本 | 可预测(一次调用) | 不可预测(可能循环几十次) |
一句话总结:单次 LLM 调用是"打手电",你指哪它照哪;Agent 是"派个人去办事",你说目标,它自己找路。
1.4 小结
Agent 的本质就两点:① 目标驱动(你给目标不给步骤);② 自主循环(LLM 在循环里自己决定调工具还是直接答)。带着这两点直觉,我们看它的内部构造。
二、Agent 的四大核心组件
2.1 生活类比:一个完整的人需要什么
还是那个实习生。要让一个实习生能独立办事,他得具备四样东西:
- 脑子:会思考、会判断、会做决定,这是 Agent 的 LLM(大脑)。
- 记忆:记得你刚才交代了什么、记得公司规定、记得上次类似任务的教训,这是 Memory(记忆)。
- 工具:手机支付、地图导航、查日历,这是 Tools(工具)。脑子里想得再好,没有手也办不成事。
- 规划:能把"买咖啡"这个大目标拆成"下楼、找店、付款、返回"这些小步骤,并在卡壳时换方案,这是 Planning(规划)。
少了任何一个,Agent 就瘸腿:没脑子等于不会决策(变回脚本);没记忆等于鱼的记忆(每一步都从头开始);没工具等于纸上谈兵(只会说不会做);没规划等于无头苍蝇(乱调工具)。
2.2 专业定义
| 组件 | 作用 | 典型实现 |
|---|---|---|
| 大脑(LLM) | 推理、决策、生成自然语言 | OpenAI / DeepSeek / Claude 等 |
| 记忆(Memory) | 存对话历史、存长期知识 | 短期是消息列表;长期是向量数据库 |
| 工具(Tools) | 让 Agent 能"动手"做事 | Function Calling 函数、API、MCP |
| 规划(Planning) | 把大任务拆成小步骤、反思纠错 | ReAct、Plan-and-Execute、ReWOO |
注意:大脑是核心,其它三个是它的"外挂"。你可以这样理解:LLM 本来只会"说",加上工具它会"做",加上记忆它能"记得上下文",加上规划它能"想清楚再动手"。
2.3 这四者怎么协作
用户给一个目标,大脑看一眼目标和当前记忆,规划出第一步,选一个工具去调,工具返回结果并写进记忆,大脑再看记忆、规划下一步,如此循环,直到大脑说"我搞定了,输出最终答案"。
这个循环,就是下一节要讲的 ReAct。Agent 的所有花活儿,本质都是把这个循环做得更稳、更省、更可控。
Part B:ReAct 范式,Agent 的"思考方式"
三、ReAct:让 LLM 像人一样"边想边做"
3.1 生活类比:你查天气推荐穿搭时脑子里在转什么
朋友问你:"明天我要去上海出差,穿啥?"
你不会脱口而出答案,你脑子里会有一连串自言自语:
(思考)我得先知道明天上海天气。
(行动)打开天气 App,查"上海明天"。
(观察)App 显示:小雨,最高 18℃,最低 12℃。
(思考)18 度偏凉,又下雨。得推带外套的,还要防雨。
(思考)出差的话得正式点,不能穿运动裤。
(行动)在脑子里挑搭配:风衣 + 长袖衬衫 + 长裤 + 雨伞。
(最终回答)"明天上海 12-18℃ 有小雨,建议风衣配长袖衬衫,
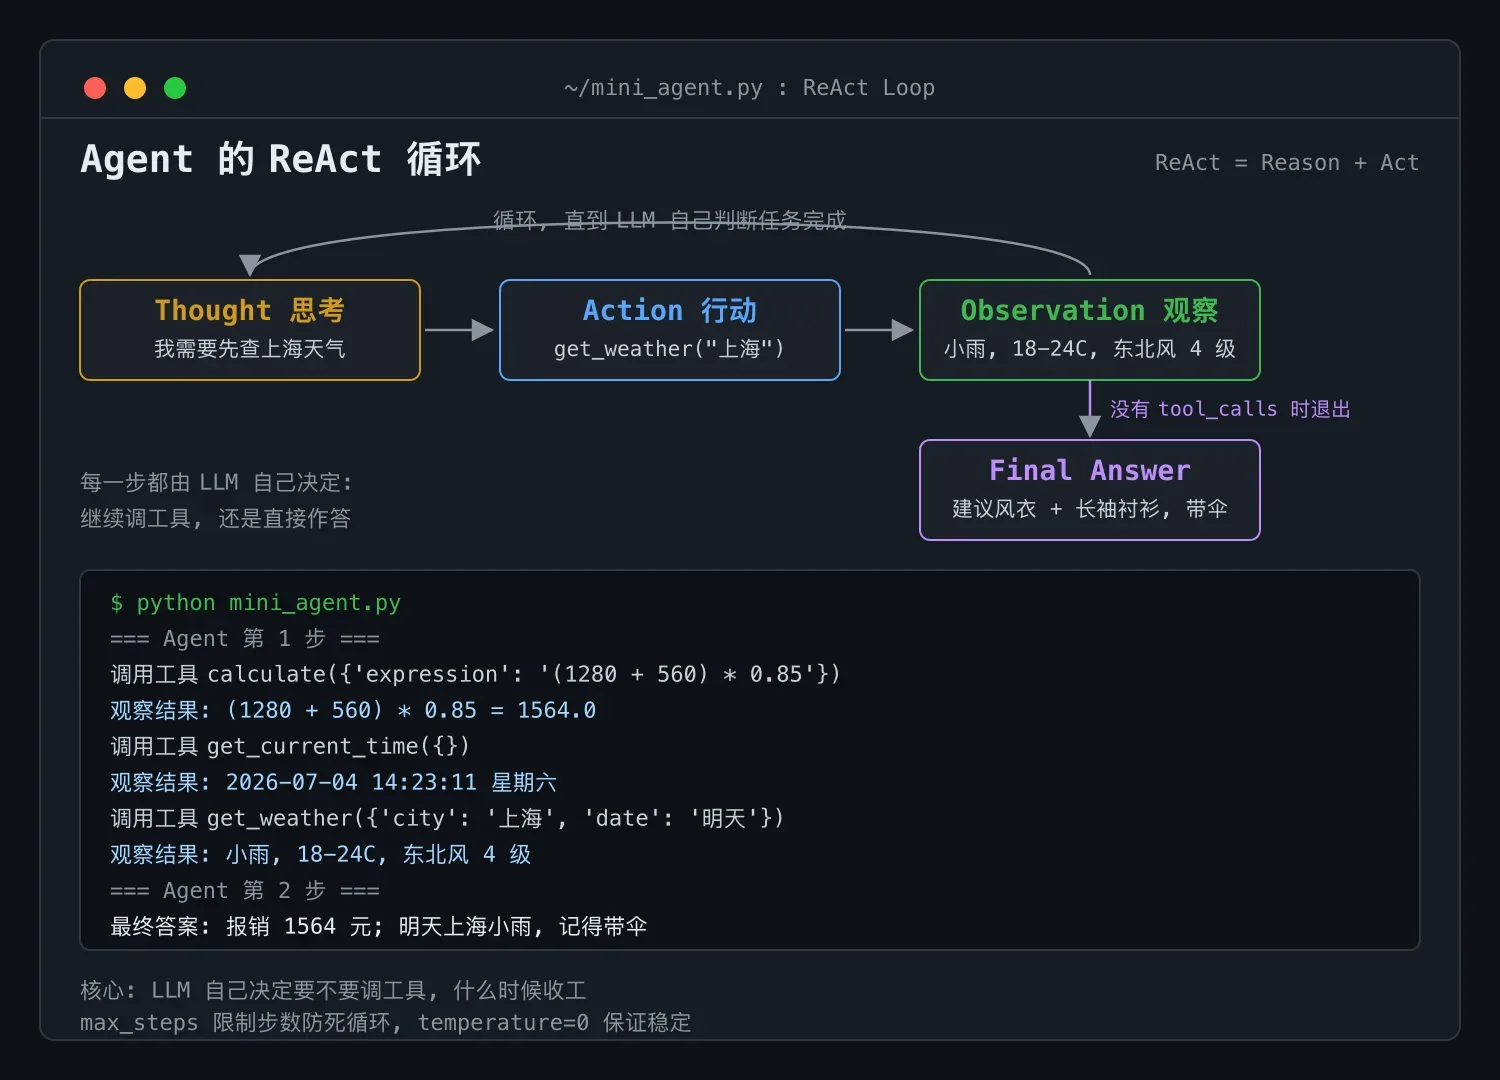
带把伞。出差的话这套也够正式。"注意这里有个关键模式:思考(Thought)、行动(Action)、观察(Observation)反复交替,最后才给出最终答案(Final Answer)。
这就是 ReAct,即 Reason 加 Act。它不是什么新技术,它就是把人类解决问题的思考过程,显式地教给 LLM。
3.2 专业定义
ReAct 范式:2022 年 Google 论文提出的一种 Agent 推理框架。它让 LLM 在每一步交替产出三种内容:
- Thought(思考):我现在想干什么、为什么。
- Action(行动):调用某个工具(或决定不调)。
- Observation(观察):工具返回的结果。
这个 Thought-Action-Observation 三元组循环若干轮,直到 LLM 产出 Final Answer(最终答案),循环结束。
3.3 一个完整的 ReAct 推理示例
下面这个例子模拟 Agent 处理"明天去上海出差穿啥"时,内部那一连串 Thought / Action / Observation 长什么样。这是 ReAct 论文风格的原汁原味演示(先不写真实代码,建立直觉):
用户问题:明天我要去上海出差,穿啥合适?

第 1 轮
Thought:  用户要去上海出差,需要根据天气推荐穿搭。
          我现在不知道上海明天的天气,得先查。
Action:   get_weather(city="上海", date="明天")
Observation: {"city": "上海", "temp_low": 12, "temp_high": 18,
              "condition": "小雨", "wind": "东北风 4 级"}

第 2 轮
Thought:  上海明天 12-18℃,有雨有风,偏凉。出差需要商务得体,
          又要防雨防风。我推荐:风衣 + 长袖衬衫 + 长裤 + 雨伞。
          我应该再确认一下明天是星期几,判断是否工作日着装更正式。
Action:   get_current_weekday()
Observation: "2026-07-04 是星期六"

第 3 轮
Thought:  星期六出差可能是周末活动,着装可以稍微休闲一点,
          但风衣防雨仍然必要。综合给出最终建议。
Final Answer: 明天上海 12-18℃,小雨,东北风 4 级。
              建议穿:风衣 + 长袖衬衫 + 卡其长裤,务必带伞。
              周末出差着装可稍微休闲,但风衣防雨防风不可省。
看到没有?Agent 自己决定了查两次工具(先天气,再星期几),并把两次观察综合起来给出答案。这就是 ReAct 的魔力:你只给了一句话目标,它在内部走了 3 轮思考。
3.4 ReAct 为什么有效
有人会问:LLM 一次性也能查天气啊,干嘛要"思考"?
答案:显式的 Thought 让 LLM 的推理过程"慢下来",准确率大幅提升。这和 Prompt Engineering 里"链式思考(Chain of Thought)"是同一个道理:让模型把思考写出来,比让它直接答更准。ReAct 在此基础上又加了"行动"环节,让模型能一边想一边动手查实际信息,避免了"拍脑袋瞎编"(幻觉)。
3.5 小结
ReAct 就是 Thought、Action、Observation 的循环,加一个叫 Final Answer 的出口。它不是玄学,是一套"让 LLM 显式思考、显式调工具"的约定。下一节我们就把这个约定,用 100 行纯 Python 跑起来。
Part C:手写最小 Agent(不用任何框架)
四、用 openai SDK 手搓一个能跑的 ReAct Agent
这是本篇的精华。市面上 Agent 框架(LangChain、LangGraph、AutoGen、CrewAI)一大堆,但框架会藏住本质。我们今天不依赖任何 Agent 框架,只用 openai 这一个库加几个 mock 工具函数,把一个 ReAct Agent 从零写出来。你跑完会发现:Agent 的核心代码不到 60 行。
4.1 思路:把 ReAct 翻译成代码
ReAct 的"Thought-Action-Observation 循环"翻译成代码就是一个 while True:
while True:
    1. 把"对话历史 + 工具列表"发给 LLM
    2. 如果 LLM 返回了 tool_calls(它想调工具):
        - 执行工具,把结果塞回对话历史
        - 继续循环(回到第 1 步)
    3. 如果 LLM 直接返回了文本答案(没有 tool_calls):
- 它说"我搞定了",输出答案,跳出循环就这么简单。LLM 自己决定"调不调工具、调几个",你只负责"执行它点名要的工具,把结果喂回去"。这就是 Agent 和 Function Calling 的区别:Function Calling 是你发起一次调用,Agent 是 LLM 在循环里自己发起多次调用。
关键认知:openai SDK 的 tools 参数(Function Calling)天然就是为 ReAct 设计的。LLM 看到 tools,会自己判断"现在该不该调工具"。你只要在外面套个 while 循环,反复喂结果,它就变成了 Agent。
4.2 完整代码(可直接复制运行)
先装依赖:pip install openai。然后准备一个 .env 文件放 OPENAI_API_KEY(或 DEEPSEEK_API_KEY,本代码同时兼容)。
# mini_agent.py:不用任何框架,纯手写一个 ReAct Agent
# 依赖:pip install openai
# 运行:python mini_agent.py
import os
import json
from datetime import datetime
from openai import OpenAI

# ===== 1. 初始化客户端(兼容 OpenAI / DeepSeek)=====
# OpenAI 和 DeepSeek 的 SDK 接口完全一致,只差 base_url 和 key
if os.getenv("DEEPSEEK_API_KEY"):
    client = OpenAI(
        api_key=os.getenv("DEEPSEEK_API_KEY"),
        base_url="https://api.deepseek.com",
    )
    MODEL = "deepseek-chat"
else:
    client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
    MODEL = "gpt-4o-mini"

# ===== 2. 定义工具(Agent 的"手")=====
# 每个工具就是一个普通 Python 函数,外加一个 JSON Schema 描述
def calculate(expression: str) -> str:
    """安全的计算器:只允许数字和 + - * / ( ) 空格"""
    import re
    if not re.fullmatch(r"[\d\s+\-*/().]+", expression):
        return "错误:包含非法字符"
    try:
        # 注意:eval 有风险,这里已用正则白名单过滤,仅作演示
        result = eval(expression, {"__builtins__": {}}, {})
        return f"{expression} = {result}"
    except Exception as e:
        return f"计算失败:{e}"

def get_current_time() -> str:
    """返回当前的日期和时间"""
    now = datetime.now()
    return now.strftime("%Y-%m-%d %H:%M:%S 星期") + \
           ["一", "二", "三", "四", "五", "六", "日"][now.weekday()]

def get_weather(city: str, date: str = "今天") -> str:
    """模拟天气查询(真实项目里换成调用天气 API)"""
    # 这里用 mock 数据演示,真实场景换成和风天气/心知天气等 API
    mock = {
        ("上海", "今天"): "晴,22-30℃,东南风 3 级",
        ("上海", "明天"): "小雨,18-24℃,东北风 4 级",
        ("北京", "今天"): "多云,15-28℃,北风 2 级",
        ("北京", "明天"): "晴,16-29℃,微风",
    }
    return mock.get((city, date), f"暂无 {city}{date} 的天气数据(mock)")

# 工具名到函数的映射表(执行时按名字查找)
TOOL_REGISTRY = {
    "calculate": calculate,
    "get_current_time": get_current_time,
    "get_weather": get_weather,
}

# 工具的 JSON Schema 描述(告诉 LLM 有哪些工具、怎么用)
# 即 Function Calling 的 tools 参数
TOOLS_SCHEMA = [
    {
        "type": "function",
        "function": {
            "name": "calculate",
            "description": "数学计算器。输入一个数学表达式(如 '12*8+5'),返回计算结果。",
            "parameters": {
                "type": "object",
                "properties": {
                    "expression": {
                        "type": "string",
                        "description": "数学表达式,如 '12 * 8 + 5'"
                    }
                },
                "required": ["expression"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "get_current_time",
            "description": "获取当前的日期、时间和星期几。",
            "parameters": {
                "type": "object",
                "properties": {},
                "required": []
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "查询某城市某天的天气(温度、天气状况、风力)。",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {"type": "string", "description": "城市名,如 '上海'"},
                    "date": {"type": "string", "description": "日期,'今天' 或 '明天'"}
                },
                "required": ["city"]
            }
        }
    }
]

# ===== 3. Agent 主循环(ReAct 的代码化身)=====
SYSTEM_PROMPT = """你是一个乐于助人的 AI 助手,可以通过调用工具来完成任务。
你的工作方式是 ReAct:先思考(Thought)需要什么信息,再调用合适的工具(Action),
观察工具返回的结果(Observation),然后继续思考,直到能给出最终答案。
你可以连续调用多次工具。如果不需要工具,直接回答即可。"""

def run_agent(user_query: str, max_steps: int = 10) -> str:
    """运行 Agent。max_steps 防止它陷入死循环(重要!)"""
    # 对话历史 = Agent 的"短期记忆"
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": user_query},
    ]

    for step in range(1, max_steps + 1):
        print(f"\n=== Agent 第 {step} 步 ===")

        # ① 把对话历史 + 工具列表 发给 LLM
        response = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            tools=TOOLS_SCHEMA,        # 把工具告诉 LLM
            temperature=0,             # Agent 场景通常要稳定,温度设 0
        )
        msg = response.choices[0].message

        # ② 把模型的回复加进记忆(无论它是要调工具还是直接答)
        messages.append(msg.model_dump(exclude_none=True))

        # ③ 判断:模型想调工具,还是已经答完了?
        if not msg.tool_calls:
            # 没有工具调用,模型给出了最终答案,退出循环
            print(f"最终答案:{msg.content}")
            return msg.content

        # ④ 模型点名要调工具,逐个执行
        for tool_call in msg.tool_calls:
            name = tool_call.function.name
            args = json.loads(tool_call.function.arguments)
            print(f"调用工具 {name}({args})")

            # 执行真正的函数(这就是 Action)
            func = TOOL_REGISTRY.get(name)
            if func is None:
                observation = f"错误:未知工具 {name}"
            else:
                observation = str(func(**args))
            print(f"观察结果:{observation}")

            # 把工具结果塞回对话历史(这就是 Observation)
            # 格式必须是 role="tool" + tool_call_id 对应
            messages.append({
                "role": "tool",
                "tool_call_id": tool_call.id,
                "content": observation,
            })
        # 一轮结束,回到循环顶部,让 LLM 看着新结果继续思考

    print("警告:达到最大步数,强制停止(可能陷入死循环)")
    return "Agent 未能在限定步数内完成任务"

# ===== 4. 试跑 =====
if __name__ == "__main__":
    # 试一个需要多步的任务
    result = run_agent(
        "我现在要出门去上海出差,帮我算一下(1280 + 560)* 0.85 是多少钱,"
        "顺便告诉我现在几点、明天上海天气如何,最后给我一个出差小提示。"
    )
    print("\n" + "=" * 50)
    print("Agent 最终输出:")
    print(result)
4.3 运行起来会看到什么
跑这段代码,控制台会打印出 Agent 内部的整个思考过程,类似这样:
=== Agent 第 1 步 ===
调用工具 calculate({'expression': '(1280 + 560) * 0.85'})
观察结果:(1280 + 560) * 0.85 = 1564.0
调用工具 get_current_time({})
观察结果:2026-07-04 14:23:11 星期六
调用工具 get_weather({'city': '上海', 'date': '明天'})
观察结果:小雨,18-24℃,东北风 4 级

=== Agent 第 2 步 ===
最终答案:(1280+560)*0.85 = 1564 元;现在是 2026-07-04 周六 14:23;
明天上海小雨 18-24℃,记得带伞和外套。出差小提示:周六出行人少,
高铁/打车都方便,但带伞防雨。
注意三个细节,每一个都是 Agent 的"自主性"体现:
- 它在第 1 步就同时调了 3 个工具(calculate、get_current_time、get_weather),这是 Function Calling 的"并行调用"能力,LLM 自己判断这三个工具互不依赖,可以一起调。
- 它在第 2 步选择不再调工具,而是综合三个观察结果直接给答案,这就是"Final Answer"出口。
- 整个过程你只写了一句 prompt,剩下全是 LLM 自己决定的。这就是 Agent。
4.4 这段代码为什么是"最小 Agent"
| ReAct 概念 | 代码里对应 |
|---|---|
| Thought(思考) | LLM 在 response.choices[0].message 里的推理 |
| Action(行动) | func(**args) 执行工具那一行 |
| Observation(观察) | messages.append({"role": "tool", ...}) 喂回去 |
| 循环 | 外层的 for step in range(...) |
| Final Answer | if not msg.tool_calls: return msg.content |
| 记忆 | messages 列表 |
| 工具 | TOOLS_SCHEMA + TOOL_REGISTRY |
| 大脑 | client.chat.completions.create |
你会发现,ReAct 那张抽象的循环图,每一格都对应代码里一两行。这就是为什么反复强调"Agent 不是玄学":它就是把人类解决问题的过程,用代码精确地复刻出来。
4.5 三个一定要知道的细节
① 为什么 temperature=0? Agent 是干活的,不是写诗。我们要它稳定、可复现,每次给同样的输入走同样的步骤,所以温度设 0(或很低)。创作型任务才需要高温度。
② 为什么要有 max_steps? 这是 Agent 最重要的安全阀。LLM 有时会"卡住":反复调同一个工具,或者陷入"我需要更多信息、调工具、还是不够、再调"的死循环。没有 max_steps,你的账单会爆掉。任何严肃的 Agent 都必须有最大步数 / 最大 token / 最大时长三道闸。
③ 为什么 tools 里要写详细的 description? LLM 是根据 description 来判断"现在该不该调这个工具"的。描述写得越清楚,它选工具越准。写工具描述其实是 Agent 开发里最被低估的"手艺活",很多 Agent bug 的根因就是工具描述太模糊,LLM 选错了工具。
4.6 小结
你已经从零写出了一个能跑的 Agent。它没有任何框架依赖,60 行核心代码,却已经具备"自主规划 + 自主选工具 + 多步推理"三大能力。 市面上所有 Agent 框架(LangChain 的 Agent、LangGraph、AutoGen)本质上都是在这 60 行外面加工程化包装:记忆管理、错误重试、并发、可观测性。理解了这 60 行,你就理解了所有 Agent 框架的内核。
Part D:Agent 的进阶机制
五、Agent 的规划策略:ReAct 不是唯一选择
ReAct 是"边想边做",但有时候任务太大,光靠边想边做会乱。下面介绍三种常见的规划策略,它们不是替代 ReAct,而是 ReAct 的"前置工序"或"变种"。
5.1 生活类比:做饭的三种策略
- ReAct(边想边做):打开冰箱看到啥,决定做啥,做到一半发现少了盐,下楼买盐,回来继续。灵活但容易乱。
- 任务分解(先拆再干):做一桌菜前,先列清单"四个菜一个汤",每个菜再拆"洗、切、炒、装盘"。有条理。
- Plan-and-Execute(先全计划好再执行):先把整桌菜的所有步骤写成菜谱贴墙上,再严格按菜谱一步步做。最稳但最不灵活。
5.2 任务分解(Task Decomposition)
思路:先让 LLM 把大任务拆成一串小任务,再逐个解决。适合"写一份市场调研报告""做一个网页"这类复合任务。
# 伪代码:任务分解的思路
plan = llm("把这个任务拆成 3-7 个子任务:", user_goal)
# plan = ["1. 搜集竞品信息", "2. 分析价格区间", "3. 总结建议"]
for subtask in plan:
    result = mini_agent(subtask)  # 每个子任务交给一个小 Agent
    context.append(result)
final_report = llm("根据以下信息写报告:", context)
5.3 Plan-and-Execute(先计划后执行)
思路:第一步让一个"规划 Agent"产出完整的分步计划,第二步让一个"执行 Agent"严格按计划走,每完成一步回头更新计划。优点是可控、省 token(执行 Agent 不用每次都重新规划),缺点是不够灵活(计划错了难回头)。
经典实现参考 LangGraph 的 Plan-and-Execute 教程。
5.4 ReWOO(Reasoning WithOut Observation)
思路:把"规划"和"调用工具"解耦:规划阶段一次性生成所有工具调用(用占位符表示依赖),执行阶段批量调工具,最后把结果填回占位符。好处是大幅减少 LLM 调用次数(省钱),适合工具调用密集、依赖关系明确的任务。
举例:规划阶段产出 #E1 = search("上海天气")、#E2 = search("北京天气")、#E3 = compare(#E1, #E2),然后一次性执行 E1、E2(可并发),再执行 E3。
5.5 三种策略对比
| 策略 | 灵活度 | 成本 | 适合场景 |
|---|---|---|---|
| ReAct(边想边做) | 高 | 高(每步都调 LLM) | 探索性任务、信息不全 |
| 任务分解 | 中 | 中 | 复合任务、写报告 |
| Plan-and-Execute | 低 | 低 | 流程明确的任务 |
| ReWOO | 中 | 最低 | 工具调用密集、依赖明确 |
实战建议:从 ReAct 起步(最简单、最灵活),任务变复杂了再上任务分解或 Plan-and-Execute,对成本敏感且依赖明确时考虑 ReWOO。
5.6 小结
规划策略是 Agent 的"大脑皮层"。ReAct 是默认选择,任务分解 / Plan-and-Execute / ReWOO 是针对不同场景的优化。没有最好的策略,只有最适合任务的策略,这也是 AI 工作流工程师的核心判断力。
六、Agent 的记忆机制:让 Agent 不变成"鱼的记忆"
6.1 生活类比:金鱼和老人
金鱼的记忆只有 7 秒,每次遇到新情况,它都得从头认识世界。这就是没有记忆的 Agent:对话一长,它就忘了前面说过什么,开始前后矛盾、重复提问。
老人的智慧来自几十年积累的经验,遇到类似的事,能想起上次怎么处理的。这就是有长期记忆的 Agent:能记住你的偏好、上次的对话、项目的来龙去脉。
6.2 三种记忆
① 短期记忆(Short-term Memory)= 对话历史
就是上文 mini_agent.py 里的 messages 列表。每轮对话、每次工具调用、每次观察,都 append 进去。它是 Agent 的"工作台",所有当前推理都基于它。
问题:context window(上下文窗口)是有限的。GPT-4o 是 128K token,看似很大,但一个长任务 Agent 调几十次工具、读几十个网页,很快就会塞爆。塞爆后要么报错,要么模型"忘记"前面的内容。
② 记忆总结(Summary)= 防爆阀门
当对话历史太长,我们用一个 LLM 调用,把前面的几十轮总结成几句话,再用这几句话替换掉冗长的历史。就像开会时写"会议纪要":你不需要记住每个人说的每句话,记住结论就行。
# 伪代码:记忆总结
if len(messages) > MAX_MESSAGES:
    # 把前面的历史让 LLM 总结
    summary = llm("请把以下对话总结成要点:", messages[:50])
    messages = [system_prompt, {"role": "summary", "content": summary}] + messages[50:]
③ 长期记忆(Long-term Memory)= 向量数据库
把重要的信息(用户偏好、历史决策、知识库)向量化存进向量库,本质就是 RAG 那一套。Agent 每次开始任务时,先把当前问题向量化,去向量库召回 Top-K 相关记忆,塞进上下文。
这其实就是 RAG 的思路:RAG 是 Agent 长期记忆的实现方式。
6.3 一个综合记忆架构
生产级 Agent 通常三层都用:
用户提问
   ↓
[长期记忆] 向量库召回相关历史经验 → 注入上下文
   ↓
[短期记忆] 当前对话历史 + 召回的记忆 → 一起发给 LLM
   ↓
...Agent 循环...
   ↓
[记忆总结] 历史超长时,自动压缩成要点,腾出 context 空间
   ↓
[长期记忆] 任务结束后,把这次的结论再存回向量库
6.4 小结
记忆是 Agent 的"经验积累系统"。短期记忆管当前任务,长期记忆管跨任务的经验,记忆总结防止上下文爆炸。没有长期记忆的 Agent,每次都从零开始;有了长期记忆,它越用越懂你。
七、Agent vs Function Calling vs Workflow(重要澄清)
这是新手最容易混淆的三兄弟,这里彻底讲清楚。
7.1 三者的关系
三者是一条能力递进链:Function Calling 是一次工具调用,你决定调几次,模型决定调哪个;Agent 是 LLM 在循环里自主决定调几次工具;Workflow 是你预先画好的多步骤流程,每个节点里可能用到 LLM。可控性上 Workflow 最高、Agent 最低,灵活度上正好相反。
7.2 用一句话加一个场景区分
| 概念 | 一句话定义 | 典型场景 | 谁决定步骤 |
|---|---|---|---|
| Function Calling | LLM 调用一次工具(你触发,模型选工具) | "查上海天气"然后调一次天气 API | 你决定"调几次",模型决定"调哪个" |
| Agent | LLM 在循环里自主调多次工具(LLM 触发) | "帮我策划一次出差,包括订票查天气算预算" | LLM 自己决定调几次、调哪个 |
| Workflow | 你预先画好的多步骤流程,每步可能用 LLM | "邮件、分类、摘要、入库"的固定流水线 | 你(开发者)写死步骤 |
7.3 三个本质区别
① 谁掌握控制权?
- FC:你在代码里调用,模型只负责"这次该不该用工具"。
- Agent:模型在循环里自己决定"继续调工具还是收工",控制权部分交给 LLM。
- Workflow:你完全掌握控制权,LLM 只是流程里的"打工人",每一步干啥你写死了。
② 确定性还是概率性?
- Workflow 是确定性的:同样的输入,永远走同样的步骤(除非你在某个节点用了 LLM 才有概率性)。
- Agent 是概率性的:同样的输入,它可能这次调 3 个工具,下次调 5 个,甚至走完全不同的路径。
- FC 介于两者之间:单次调用是概率的,但整体流程是你控制的。
③ 什么时候用哪个?
- 流程清晰、固定、要可审计,用 Workflow(如客服分流、报表生成)。
- 任务开放、多变、需要灵活决策,用 Agent(如调研、规划、coding)。
- 只是让 LLM 用一两个工具补能力(查个天气、算个数),Function Calling 就够了,别上 Agent(杀鸡用牛刀)。
7.4 小结(一段话记住)
Function Calling 是 Agent 的"原子能力",Agent 是 Function Calling 的"自主循环版",Workflow 是与 Agent 平行的"另一条路线"(确定性对概率性)。 真实项目里,它们经常组合:Workflow 编排大流程,某些节点内部跑一个 Agent,Agent 内部用 Function Calling。
八、Agent 的局限与坑:为什么需要"可控 Agent"
讲到这里你可能热血沸腾,觉得 Agent 无所不能。冷静一下。 Agent 是 LLM 应用里最难做稳的部分,坑多得能写一本书。下面这五个坑,每一个都会在生产环境咬你一口。
8.1 五大经典坑
坑 1:死循环(Infinite Loop)
LLM 反复调同一个工具,或者陷入"我需要更多信息、调工具、还是不够、再调"的死循环。前面我们的 max_steps 就是防这个的。生产级 Agent 还要加:相同参数重复调用检测、单次任务最大 token、单次任务最大时长。
坑 2:烧钱(成本不可控)
单次 LLM 调用几分钱,Agent 一个任务循环 20 步就是 20 次调用,再每次塞一长串对话历史,token 消耗指数级上升。一个复杂 Agent 任务跑掉几块钱甚至几十块钱很正常。对策:缓存工具结果、限制历史长度、用便宜模型做规划用强模型做关键决策。
坑 3:错误累积(Error Cascade)
Agent 第 1 步选错了工具 / 读错了网页,第 2 步基于错误结果继续推理,第 3 步错上加错,到最后输出一个"看起来很合理但完全跑偏"的答案。LLM 很少自己发现前面错了。对策:关键步骤加验证、加反思(Reflection)机制。
坑 4:不可控 / 不可预测
同样的输入,Agent 今天走 A 路径,明天走 B 路径。这在需要审计、合规、可复现的企业场景是致命的。老板问你"为什么 Agent 给客户发了这封邮件",你答不上来。对策:日志记录每一步、关键决策加人工审批。
坑 5:幻觉 + 工具误用
LLM 会"编造"工具的返回结果(明明工具返回空,它说"查到了"),或者调一个不存在的工具、传错误的参数。对策:工具返回要结构化、加 schema 校验、让 LLM 在工具失败时明确知道"失败了"。
8.2 这些坑催生了什么
正因为纯 ReAct Agent 太"野",业界发展出两个方向的解法:
① HITL(Human-in-the-Loop,人在回路)
关键步骤(发邮件、转账、删数据、发布上线)不让 Agent 自动执行,而是暂停下来等人工确认。Agent 负责干累活,人负责把关关键动作。这是企业级 Agent 的标配。
② 可控 Agent 框架(如 LangGraph)
把 Agent 从"一个自由循环"变成"一张有边界的状态图":你定义好 Agent 能走的节点、节点之间的转移条件、哪里必须暂停等人确认、哪里可以并发。LangGraph 本质上是 Workflow 和 Agent 的融合:保留 Agent 的自主决策,但套上 Workflow 的可控骨架。
8.3 小结
Agent 很强大,但自主性 = 不可控性 = 风险。生产级 Agent 的核心命题不是"让它更聪明",而是"在保持自主的同时,把它装进可控的笼子里"。这个笼子,就是 HITL 加可控框架(LangGraph)。
九、本章小结
- Agent 的本质是"目标驱动 + 自主循环":你给目标不给步骤,LLM 在循环里自己决定调不调工具、调几次,直到它判断任务完成。
- 四大组件缺一不可:大脑(LLM)是核心,记忆(Memory)、工具(Tools)、规划(Planning)是它的外挂。
- ReAct 是 Agent 的核心心智模型:Thought、Action、Observation 循环加一个 Final Answer 出口。它就是"把人类思考过程教给 LLM"。
- 手写最小 Agent 只要 60 行:openai SDK 的
tools参数加一个 while 循环就构成 Agent。所有框架都是在这外面加工程化包装。理解了这 60 行就理解了所有 Agent 框架的内核。 - 规划策略有四选:ReAct(默认)、任务分解、Plan-and-Execute、ReWOO(最省钱)。没有最好,只有最适合。
- 记忆有三层:短期(对话历史)、长期(向量库)、总结(防爆阀门)。RAG 就是 Agent 长期记忆的实现方式。
- FC / Agent / Workflow 三兄弟:FC 是单次工具调用,Agent 是 FC 的自主循环版,Workflow 是确定性的预定义流程。三者常组合使用。
- Agent 五大坑:死循环、烧钱、错误累积、不可控、幻觉误用。生产化的解法是 HITL 加可控框架(LangGraph)。
- 一句终极认知:Agent 的核心代码很简单,难的是把它做稳、做省、做可控。 这正是 AI 工作流工程师的核心价值。
十、动手练习
练习 1(基础):把上文的 mini_agent.py 跑起来,问它"现在几点?123 乘以 456 等于多少?"观察它是怎么一次性并行调两个工具的。然后改一下 get_weather 的 mock 数据,加上你所在城市,问它"明天我该穿什么",看看它的 ReAct 推理过程。把你看到的 Thought-Action-Observation 三轮打印贴在笔记里。
练习 2(进阶):给 Agent 加一个新工具 search_wiki(keyword),用 requests 调 Wikipedia 的 API(https://en.wikipedia.org/api/rest_v1/page/summary/{keyword})返回摘要。然后问它"鲁迅是谁?他生于哪一年?"观察它怎么自己决定调这个新工具。体会:加工具不用改 Agent 主循环,只改 TOOLS_SCHEMA 和 TOOL_REGISTRY,这就是工具扩展的优雅之处。
练习 3(挑战):给 Agent 加"记忆总结"机制:当对话历史超过 20 条消息时,调用一次 LLM 把前面的历史总结成 200 字以内的要点,替换掉旧历史。然后让 Agent 处理一个长任务(比如"帮我调研三家国产新能源车的价格和续航并对比"),观察总结前后 token 消耗的变化。你已经亲手实现了 Agent 的防爆阀门。
练习 4(思考题):找一个你自己工作里的真实场景,判断它该用 FC、Agent 还是 Workflow,并写出理由。例如:"每天早上自动把昨天的客户邮件分类汇总发给我",这是 Workflow 还是 Agent?为什么?用第 7 节的"谁掌握控制权"标准检验一遍你的判断。
十一、延伸阅读
- ReAct 原论文(必读):Yao et al. ReAct: Synergizing Reasoning and Acting in Language Models,https://arxiv.org/abs/2210.03629 ,理解 Agent 推理范式的源头。
- OpenAI Function Calling 指南:https://platform.openai.com/docs/guides/function-calling ,第 4 节代码的底层依赖。
- Plan-and-Execute 教程(LangGraph):https://langchain-ai.github.io/langgraph/tutorials/plan-and-execute/plan-and-execute/ ,规划策略的落地实现。
- ReWOO 论文:Xu et al. ReWOO: Decoupling Reasoning from Tools for Efficient and Effective Language Agents,https://arxiv.org/abs/2305.18323 ,最省钱的 Agent 范式。
- Reflection 论文:Shinn et al. Reflexion: Language Agents with Verbal Reinforcement Learning,https://arxiv.org/abs/2303.11366 ,Agent 自我纠错的经典方法。
- Lilian Weng: LLM Powered Autonomous Agents(强烈推荐):https://lilianweng.github.io/posts/2023-06-23-agent/ ,业界最经典的 Agent 综述博客,把本文的体系讲得最全。
- LangGraph 文档:https://langchain-ai.github.io/langgraph/ ,"可控 Agent"框架,建议先扫一眼概念。
- 书籍推荐:Building LLMs for Production(Valentina Alto),有一章专门讲 Agent 的工程化落地。
把 Agent 装进"笼子",是本文之后的进阶方向。 本文带你从原理到代码走通了第一遍:Agent 的本质是一个"LLM 自主调工具"的 while 循环,60 行核心代码就够。但你也看到了 Agent 的五大坑:死循环、烧钱、错误累积、不可控。这些坑,单靠 ReAct 解决不了。 LangGraph 这类可控 Agent 框架正是为此而生:它把 Agent 从"自由循环"变成"有边界的状态图",用节点(Node)和边(Edge)画出 Agent 流程图,在关键节点强制暂停等人审批(HITL),并支持多个 Agent 协作。如果说本篇教的是 Agent 的"心法",可控框架教的就是把它装进"笼子"的"招式",值得作为你的下一步。