字节笔记本
2026年10月6日 · 约 55 分钟读完
AI 工作流专栏 16:多步编排与人机协同 HITL
本文是 AI 工作流专栏第 16 篇,聚焦多步工作流编排与人机协同(HITL,Human-in-the-Loop)。ReAct 模式让 Agent 学会了"想一想、做一步、再想想",但会思考的 Agent 一旦放进真实业务,马上会遇到一堆新问题:用户问"帮我办个退款",Agent 不能上来就退,得先判断金额大不大、要不要主管审批、退错了怎么办。一整条链路可能要跑五六步,中间还会分叉、会兜圈子、会卡住等人拍板。单线的"问一句答一句"已经不够用了,你需要的是"工作流编排"。
本篇把真实业务里最常见的四种控制流:顺序、分支、循环、并行,逐一拆开讲清楚,重点攻克人机协同(HITL):什么时候必须停下来等人审核、怎么用状态机实现"暂停与恢复"、服务重启后怎么从断点接着跑。最后从零搭一条"智能客服工单处理流水线",把分支、循环、HITL、状态管理、错误降级全部串起来。这是从"会写一个 Agent"到"能设计一套生产级 AI 流水线"的关键一跃。
本篇你将学到:
- 为什么单步 Agent 搞不定真实业务,必须上工作流编排
- 四种基本控制流:顺序、分支、循环、并行,每种配可跑的 Python 代码
- HITL 的三种模式:审批、编辑、接管
- 哪些业务场景必须加 HITL:退款、发邮件、删数据、医疗法律建议
- 用状态机思路实现"暂停与恢复",配合 Redis 存中间状态,服务重启后从断点续跑
- 错误处理与降级四板斧:重试、跳过、降级到人工、回滚
- 实战案例:智能客服工单流水线,含分支、循环、HITL 审批与归档
- 用"节点加边"的图思维设计工作流,为上手 LangGraph 这类编排框架打基础
一、为什么需要"工作流编排"
1.1 生活类比:做一道菜
你有没有认真想过,做一道"番茄炒蛋"背后藏着一整套调度逻辑?
- 顺序:必须先洗番茄,再切番茄,再下锅。顺序不能乱,你不能先炒蛋再去洗番茄。
- 并行:烧水、打蛋、切葱这三件事可以同时干,一边烧水一边打蛋,省时间。
- 分支:尝一口味道,太淡就加盐,太咸就加点糖,下一步做什么,取决于上一步的结果。
- 循环:饭没熟?再焖五分钟,再尝一次,还没熟?再焖,反复直到满意为止。
看出来了吧,做饭本身就是一套"工作流":有固定的步骤顺序,有能并行的环节,有根据中间结果走的岔路,还有不断试错调整的循环。
AI 工作流和做菜一模一样。你让 AI 帮用户处理一张工单,它得:先分类(顺序),简单问题直接答、复杂问题转 RAG(分支),答案不满意就重写(循环),同时查订单系统和物流系统(并行),涉及退款要等主管点头(人机协同)。把这些步骤按业务逻辑串成一条可调度、可恢复、可监控的流水线,就是"工作流编排"。
1.2 为什么单步 Agent 不够用
只会 ReAct 的单步 Agent 是这样的:用户说一句话,Agent 思考,调个工具,再思考,再调个工具,然后回答。这条链子看起来也能"多步",但它在真实业务里会撞上三堵墙:
第一堵墙:流程是"线"的,不能分叉。 Agent 默认从头跑到尾,中间没有"如果金额超过 1000 就走退款审批、否则直接答"这种显式的业务分支。你硬塞进 prompt 里让它自己判断?它会判,但不可控、不可测、不可审计,出了事你根本说不清它当时为什么没走审批。
第二堵墙:不能"暂停等人"。 Agent 一旦开跑就是一口气跑完。可退款这种操作,你怎么能让它"先停一停,等主管在系统里点个同意再继续"?纯靠 prompt 做不到,你必须把流程设计成"可暂停的状态机"。
第三堵墙:跑一半服务挂了,全丢了。 Agent 跑到第 4 步突然服务重启,前面 3 步的结果全没了,用户得从头再来。生产环境必须有"断点续跑",这就要把每一步的中间状态存起来。
所以,工作流编排就是给 Agent 套上一层"业务骨架":这个骨架定义了"第几步干什么、什么时候分叉、什么时候暂停、什么时候循环、出错怎么办"。Agent 的"脑子"(ReAct)依然负责单步内的决策,而"骨架"负责把整条业务流程跑稳、跑对、跑得能恢复。
一句话记住它:单步 Agent 是"一个聪明的员工",工作流编排是"一套管理制度",员工再聪明,没有制度也干不成大项目。
1.3 小结
- 做菜和 AI 工作流本质相同:都有顺序、并行、分支、循环。
- 单步 Agent 撞上三堵墙:不能分叉、不能暂停、不能恢复。
- 工作流编排就是给 Agent 套上"业务骨架",让流程可控、可暂停、可恢复、可审计。
二、工作流的四种基本控制流
接下来逐一拆解四种控制流。这四种是所有工作流的"乐高积木",不管多复杂的业务流水线,拆开看都是这四种的组合。
2.1 顺序(Sequence):A 到 B 到 C
类比:流水线上的瓶子,第一个工位灌水,第二个工位拧盖,第三个工位贴标。前一个没干完,后一个不能开始,结果像接力棒一样往后传。
概念:顺序结构指多个步骤按固定顺序依次执行,每一步的输出作为下一步的输入。这是最基础的控制流,相当于把多个函数"串"起来。
代码:
# sequence.py:顺序结构,最朴素的"流水线"
def classify_ticket(text: str) -> str:
    """第 1 步:分类工单"""
    # 实际项目里这里是 LLM 调用,先用假数据演示结构
    if "退款" in text:
        return "退款类"
    return "咨询类"

def route(category: str) -> str:
    """第 2 步:根据分类决定走哪条路(这里先返回处理方式)"""
    return f"按【{category}】流程处理"

def archive(result: str) -> None:
    """第 3 步:归档"""
    print(f"已归档:{result}")

# 顺序执行:一步的输出 = 下一步的输入
ticket = "我要退款,订单号 12345"
step1 = classify_ticket(ticket)   # 1. 分类
step2 = route(step1)              # 2. 路由(依赖 step1)
archive(step2)                    # 3. 归档(依赖 step2)
顺序结构看着简单,但它是所有工作流的"主干",分支和循环都是长在这根主干上的"枝杈"。
小结:顺序 = 函数链,前一步的输出喂给后一步。简单可靠,是流水线的主干。
2.2 分支(Branch):if 条件 then A else B
类比:高速公路的匝道,开到岔路口,看路牌(条件),去北京走左边,去上海走右边。同一条路开到岔口,根据"去哪"这个条件,分到不同车道。
概念:分支结构根据某个条件(通常是上一步的输出)选择不同的后续路径。常见的有二分支(if/else)和多分支(switch/case)。
代码:
# branch.py:分支结构,根据分类走不同处理
def classify(ticket: str) -> str:
    if "退款" in ticket:
        return "refund"
    if "投诉" in ticket:
        return "complaint"
    return "faq"

def handle_refund(ticket: str):
    print("走退款流程:查订单 → 校验金额 → 触发审批")

def handle_complaint(ticket: str):
    print("走投诉流程:安抚话术 → 升级主管")

def handle_faq(ticket: str):
    print("走 FAQ 流程:直接 RAG 检索回答")

ticket = "这个商品坏了,我要退款"
category = classify(ticket)

# 多分支:根据分类结果选不同函数
if category == "refund":
    handle_refund(ticket)
elif category == "complaint":
    handle_complaint(ticket)
else:
    handle_faq(ticket)
分支是业务里用得最多的控制流,所有"根据情况走不同流程"的需求,本质都是分支。
小结:分支 = if/else,根据上一步结果走不同路。业务里最常用的控制流。
2.3 循环(Loop):重试、迭代优化
类比:蒸馒头,掀开锅盖按一下,没熟?再蒸五分钟,再按一下,还没熟?再蒸,反复直到熟了为止。循环就是"没达到目标就再来一次"。
概念:循环结构重复执行某段流程,直到满足退出条件。AI 工作流里循环有两种典型用法:重试(失败了再来)和迭代优化(结果不够好就改进,直到达标)。
代码(重试加迭代优化两种):
# loop.py:循环结构,重试与迭代优化
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

# --- 模式 A:重试(失败就再来,最多 N 次)---
def call_llm_with_retry(prompt: str, max_retries: int = 3):
    for attempt in range(1, max_retries + 1):
        try:
            resp = client.chat.completions.create(
                model="gpt-4o-mini",
                messages=[{"role": "user", "content": prompt}],
            )
            return resp.choices[0].message.content
        except Exception as e:
            print(f"第 {attempt} 次失败:{e}")
            if attempt == max_retries:
                raise  # 重试次数用尽,往上抛
            time.sleep(2 ** attempt)  # 指数退避:2s, 4s, 8s...

# --- 模式 B:迭代优化(结果不达标就改进,直到达标或超次数)---
def generate_until_good(question: str, max_rounds: int = 3):
    draft = call_llm_with_retry(f"回答这个问题:{question}")
    for round_ in range(1, max_rounds + 1):
        # 用 LLM 当"评委",给草稿打分
        score_resp = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content":
                f"给下面回答打 1-10 分,只输出数字。问题:{question}\n回答:{draft}"}],
        )
        score = int(score_resp.choices[0].message.content.strip())
        print(f"第 {round_} 轮,得分 {score}")
        if score >= 8:
            return draft  # 达标,退出循环
        # 不达标,让 LLM 改进一版
        draft = call_llm_with_retry(
            f"这个回答得分 {score},请改得更好。问题:{question}\n原回答:{draft}")
    return draft  # 改到上限还不行,返回最后一版

print(generate_until_good("用大白话解释什么是 RAG"))
循环的关键永远是"退出条件":重试的退出条件是"成功或超过上限",迭代的退出条件是"达标或超过轮数"。没有退出条件的循环就是死循环,一定要设上限兜底。
小结:循环 = 重试或迭代优化,必须有明确的退出条件(成功、达标、超次数),否则就是死循环。
2.4 并行(Parallel):同时跑多个任务
类比:做番茄炒蛋时,你不会等水烧开才去打蛋,你一边烧水一边打蛋一边切葱,三件事同时进行,时间从 9 分钟压到 3 分钟。
概念:并行结构让多个互不依赖的任务同时执行,全部完成后再汇总结果。在 AI 工作流里,并行能把"查订单 + 查物流 + 查用户信息"这种互不依赖的调用从串行变并行,总耗时从"加起来"变成"取最长那个"。
代码:
# parallel.py:并行结构,用线程池同时跑多个独立任务
import os, time
from concurrent.futures import ThreadPoolExecutor, as_completed
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

def ask(question: str) -> str:
    """一个独立的 LLM 调用任务"""
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": question}],
    )
    return resp.choices[0].message.content

questions = [
    "用一句话解释 RAG",
    "用一句话解释 Agent",
    "用一句话解释 Embedding",
    "用一句话解释向量数据库",
]

# --- 串行:一个一个问,总耗时约等于单次乘以 4 ---
t0 = time.time()
serial = [ask(q) for q in questions]
print(f"串行耗时 {time.time()-t0:.1f}s")

# --- 并行:4 个问题同时问,总耗时约等于最慢那一次 ---
t0 = time.time()
with ThreadPoolExecutor(max_workers=4) as pool:
    futures = {pool.submit(ask, q): q for q in questions}
    parallel = [f.result() for f in as_completed(futures)]
print(f"并行耗时 {time.time()-t0:.1f}s")
并行能带来几倍的速度提升,但有个前提:任务之间必须互不依赖。如果 B 需要 A 的结果,那就只能顺序,不能并行。
小结:并行 = 互不依赖的任务同时跑,总耗时取最慢那个。前提是任务之间没有依赖关系。
三、人机协同(HITL):让 AI 知道"什么时候该停"
讲完四种控制流,我们来到本篇最重要的一节:人机协同(Human-in-the-Loop,简称 HITL)。
3.1 为什么 AI 不能"全自动"
类比:新手司机第一次上高速。你会让他自己开完全程吗?大概率不会,你会让他开一段、你在副驾看着、遇到复杂路况你接手。AI 在高风险场景里就是那个"新手司机":它绝大部分时候开得不错,但关键路口必须有老司机盯着。
概念:HITL(Human-in-the-Loop,人机协同、人在回路)指在 AI 工作流的某些关键步骤,主动暂停流程,等待人工审核、修改或接管后再继续。本质是给 AI 装一个"刹车",让人类能在它"犯大错之前"踩住。
为什么必须有人参与:AI 再聪明,它也有三个致命短板:会幻觉(一本正经胡说)、不懂边界(不该退的款它敢退)、扛不了责任(医疗诊断错了谁负责?)。所以凡是"做错了代价大、且不可逆"的操作,都必须有人兜底。
3.2 三种 HITL 模式
HITL 不是只有一种"暂停等人"。根据人和 AI 的分工不同,分三种典型模式:
模式 1:审批后继续(Approve / Reject):AI 把方案做好了,停下来等人点"同意"或"拒绝"。同意就继续,拒绝就终止或退回重做。典型场景:退款审批、合同盖章前确认。AI 主导,人只做"是/否"的把关。
模式 2:人工修改后继续(Edit):AI 产出一份草稿(比如邮件、文案),人改一改再放行。AI 继续拿改后的版本往下走。典型场景:营销文案、对外邮件、报告初稿。AI 出活,人微调。
模式 3:人工接管(Escalate):AI 发现自己搞不定(置信度太低、触发了敏感词、超出能力边界),主动把整个任务转交给人,自己退到一边。典型场景:医疗问询、法律咨询、客户情绪激烈。人主导,AI 让位。
3.3 什么场景"必须"加 HITL
| 场景 | 风险 | 建议模式 |
|---|---|---|
| 退款 / 支付 / 转账 | 直接涉及钱,错了赔钱 | 审批(大额)、接管(异常) |
| 发对外邮件 / 短信 | 代表公司形象,发错社死 | 人工修改 |
| 删除 / 修改数据库 | 数据不可逆 | 审批 |
| 医疗 / 法律建议 | 出错有人身或法律责任 | 接管 |
| 模型置信度低 | 模型自己都不确定 | 接管 |
| 内容发布到公开平台 | 合规风险 | 审批加修改 |
判断口诀:"错了赔不赔得起?能不能撤销?涉及谁的身家性命?"任何一个回答是"赔不起、不能撤、涉及身家",就必须加 HITL。
3.4 小结
- HITL = 给 AI 装刹车,关键步骤暂停等人。
- 三种模式:审批(是/否)、编辑(改一改)、接管(人顶上)。
- 判断要不要 HITL:错了赔不赔得起、能不能撤销、涉不涉身家。
四、HITL 的代码实现:用状态机"暂停与恢复"
理解了"为什么要有 HITL",接下来最硬核的问题来了:代码上怎么实现"暂停"?
4.1 核心思路:工作流 = 状态机
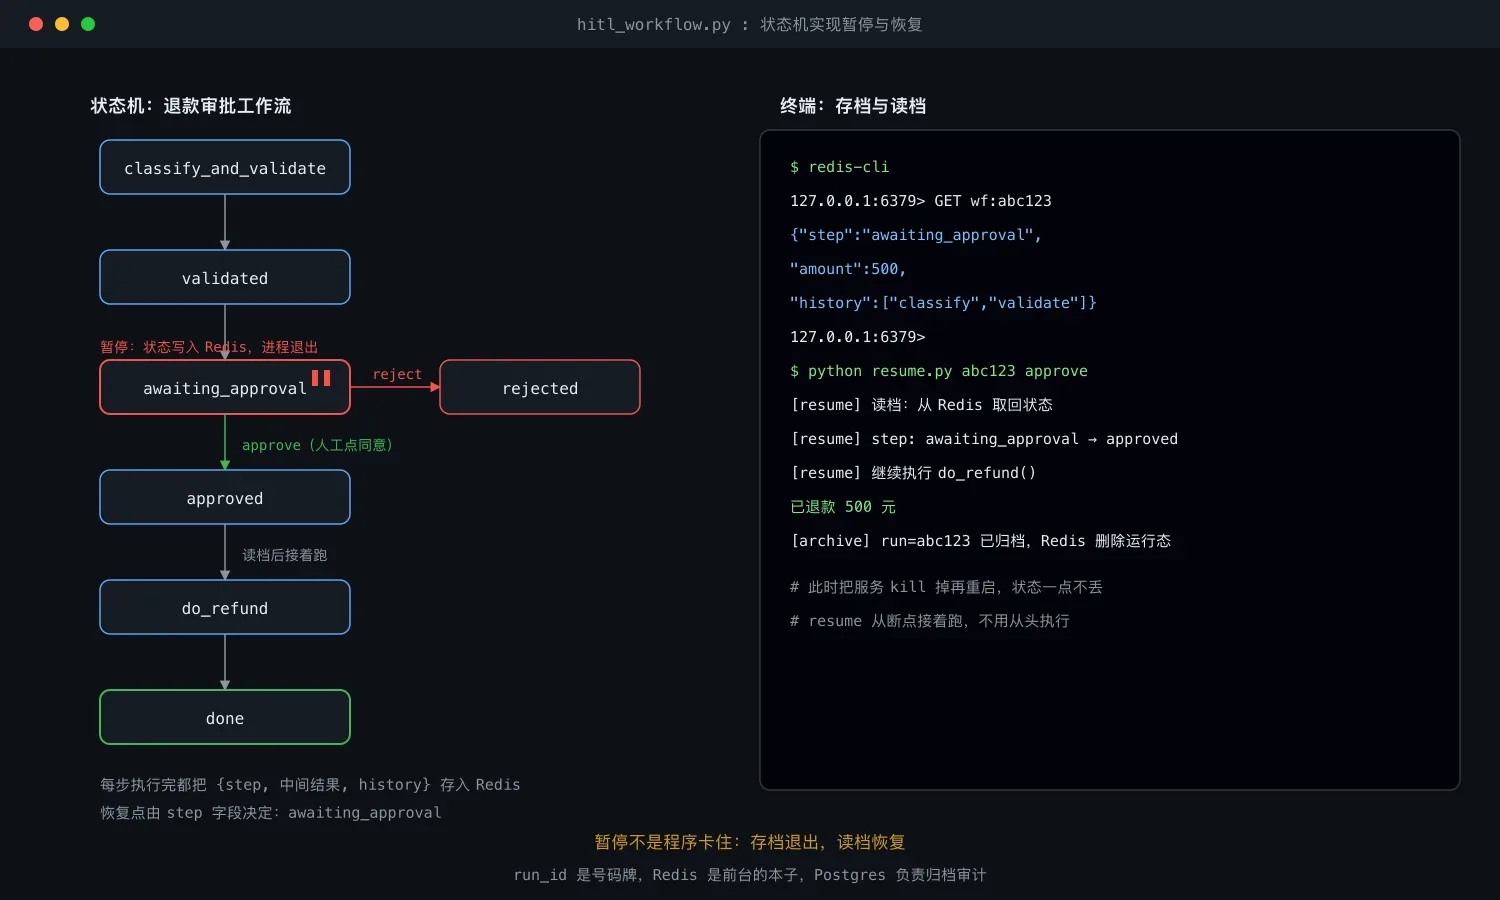
类比:存档游戏。你在玩一个 RPG,打到 boss 前要吃饭,于是存档退出。吃完饭回来读档继续,不用从头打小怪,boss 战从你存档那一刻接着来。HITL 的暂停与恢复,本质就是"存档加读档"。
概念:把工作流看成一个状态机:每个步骤是一个"状态",跑完一步就把当前状态和中间结果存起来(存档)。遇到 HITL 节点,就把状态标记为"等待人工"并停下;等人审核完,读出存档、把审核结果塞进去、从当前状态接着跑(读档)。
这里的关键洞察是:"暂停"不是真的让程序卡住不动,而是"主动退出当前执行、把状态存好、之后从外部触发恢复"。你的服务进程完全可以该干嘛干嘛,等人在系统里点了"同意",再起一次新的执行,从存档处接着跑。
4.2 用 Redis 存中间状态
为什么用 Redis?因为它快(毫秒级读写)、带过期时间(工单超时自动作废)、所有服务实例共享(多台机器都能读同一份状态)。当然,如果你要更强的持久化,也可以用 Postgres,思路完全一样。
代码:一个最小可跑的 HITL 工作流
# hitl_workflow.py:用状态机 + Redis 实现"暂停-恢复"
# pip install redis
import os, json, uuid, redis

r = redis.Redis(host=os.getenv("REDIS_HOST", "localhost"),
                port=int(os.getenv("REDIS_PORT", "6379")), decode_responses=True)

# 把一个工作流的执行状态存进 Redis("存档")
def save_state(run_id: str, state: dict):
    state["updated_at"] = __import__("time").time()
    r.set(f"wf:{run_id}", json.dumps(state, ensure_ascii=False))

# 读出来("读档")
def load_state(run_id: str) -> dict | None:
    data = r.get(f"wf:{run_id}")
    return json.loads(data) if data else None

# ---- 一个"退款审批"工作流:分类 → 校验 → 【HITL 等审批】 → 执行退款 ----
def classify_and_validate(ticket: str) -> dict:
    """第 1、2 步:分类 + 校验(省略 LLM 细节)"""
    amount = 500  # 假装从订单系统查到的金额
    return {"ticket": ticket, "amount": amount, "category": "退款"}

def run_until_human(run_id: str, ticket: str):
    """跑流水线,直到撞上 HITL 节点就暂停"""
    state = load_state(run_id) or {}
    step = state.get("step", "start")

    if step == "start":
        state = classify_and_validate(ticket)
        state["step"] = "validated"
        save_state(run_id, state)

    if state["step"] == "validated":
        # HITL 节点:暂停,等人审批
        state["step"] = "awaiting_approval"
        save_state(run_id, state)
        print(f"已暂停,等待审批。run_id={run_id},金额={state['amount']}")
        print("  请调用 resume(run_id, 'approve' 或 'reject')")
        return state  # 主动退出,把控制权交还

    if state["step"] == "approved":
        do_refund(state)            # 真正执行退款
        state["step"] = "done"
        save_state(run_id, state)
        return state

def do_refund(state):
    print(f"已退款 {state['amount']} 元")

def resume(run_id: str, decision: str):
    """人工审核后,从断点恢复"""
    state = load_state(run_id)
    if not state:
        raise ValueError("存档不存在,可能已过期")
    if state["step"] != "awaiting_approval":
        raise ValueError(f"当前状态 {state['step']} 不在等待审批")
    if decision == "approve":
        state["step"] = "approved"
        save_state(run_id, state)
        return run_until_human(run_id, state["ticket"])  # 读档后接着跑
    else:
        state["step"] = "rejected"
        save_state(run_id, state)
        print("已拒绝,流程终止")
        return state

# ---- 跑一把 ----
if __name__ == "__main__":
    rid = str(uuid.uuid4())[:8]
    run_until_human(rid, "商品坏了,申请退款")  # 会停在 awaiting_approval
    print("--- 此时服务可以挂掉、可以重启,状态都在 Redis 里 ---")
    resume(rid, "approve")                          # 人工点同意,从断点恢复
跑一下你会看到:第一段执行后主动暂停(状态存进 Redis),第二段调用 resume 时从 Redis 读档接着跑。中间就算你把服务关掉重启,状态一点不丢,这就是"断点续跑"的魔力。
4.3 小结
- HITL 的暂停不是程序卡住,而是"存档退出 + 读档恢复"。
- 用状态机思路:每步存当前步骤和中间结果到 Redis。
- 服务重启后,从 Redis 读出存档,从断点接着跑。
五、状态管理:长流程怎么存、怎么恢复
上一节的代码已经用过 Redis 存状态了,这一节把"状态管理"这件事系统讲清楚。
5.1 类比:餐厅的取餐号
你去网红餐厅排队,前台给你一个号码牌(45 号)。你不用站在门口死等,可以去逛街。叫到 45 号你回来,前台凭号找到你的订单(谁、几桌、点什么菜)。号码牌就是 run_id,前台的本子就是状态存储。
5.2 三种状态存储方案
| 方案 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| Redis | 短中期(分钟到天)、要快 | 毫秒级、支持过期 | 重启可能丢(需开 AOF 持久化) |
| 数据库(Postgres/MySQL) | 长期、要审计 | 持久、可查询、可审计 | 比 Redis 慢 |
| 内存(dict) | 单机 demo | 最简单 | 重启全丢、多实例不共享 |
生产环境最佳实践:Redis 做运行态(快),Postgres 做归档审计(久)。一个工单处理完,从 Redis 删掉、归档进 Postgres。
5.3 状态数据该存什么
一个好用的状态结构长这样:
state = {
    "run_id": "abc123",            # 唯一标识(号码牌)
    "step": "awaiting_approval",   # 当前在哪一步(状态机的"状态")
    "ticket": "...",               # 业务输入
    "category": "退款",            # 中间结果
    "amount": 500,                 # 中间结果
    "history": [                   # 每步的执行记录(审计用)
        {"step": "classify", "ok": True, "at": 1735689600},
        {"step": "validate", "ok": True, "at": 1735689605},
    ],
    "error": None,                 # 出错信息
    "updated_at": 1735689610,      # 最后更新时间
}
两个关键字段:step(状态机的状态,决定从哪恢复)和 history(审计日志,出问题能回溯)。别的字段能省,这两个不能省。
5.4 小结
- 状态管理 = 给每个流程发"号码牌"(run_id),把中间结果存好。
- Redis 跑运行态,Postgres 做归档审计。
- 必存字段:step(恢复用)加 history(审计用)。
六、错误处理与降级:某步失败了怎么办
真实环境里,"出错"才是常态:LLM 接口超时、数据库连不上、RAG 检索为空、审核员一直不点同意。你的工作流必须提前想好每一步失败怎么办,否则一个报错就把整条链路搞崩。
6.1 四板斧:重试、跳过、降级到人工、回滚
类比:快递送包裹。地址写错了怎么办?重投(重试);联系不上收件人?先放代收点(跳过,下次再送);包裹破损?送回分拣中心(降级到人工处理);发现整单信息都错了?撤回,从头再来(回滚)。
四种策略:
重试(Retry):临时性故障(网络抖动、限流)就重试几次,配合指数退避(见 2.3 节代码)。适用:偶发、可恢复的错。
跳过(Skip):某步是"锦上添花"(比如加个推荐商品),失败了不影响主线,那就跳过继续。适用:非关键步骤。
降级到人工(Escalate):关键步骤失败或置信度低,直接转人工接管(见 3.2 节模式 3)。适用:错了代价大、模型搞不定。
回滚(Rollback):多步操作里,前面几步已经改了数据,后面一步失败,要把前面的改动撤销。比如"先扣库存,再付款",付款失败就得把库存加回去。适用:有副作用、需保持一致性的操作。
代码骨架:
# error_handling.py:错误处理四板斧
import logging
logger = logging.getLogger("wf")

def with_retry(fn, max_retries=3, backoff=2):
    """板斧 1:重试 + 指数退避"""
    import time
    for i in range(1, max_retries + 1):
        try:
            return fn()
        except Exception as e:
            if i == max_retries:
                raise
            logger.warning(f"第 {i} 次失败:{e},{backoff**i}s 后重试")
            time.sleep(backoff ** i)

def step_optional(fn):
    """板斧 2:跳过(失败不影响主线)"""
    try:
        return fn()
    except Exception as e:
        logger.warning(f"非关键步骤失败,跳过:{e}")
        return None

def step_critical(fn, on_fail):
    """板斧 3:关键步骤失败,降级到人工"""
    try:
        return fn()
    except Exception as e:
        logger.error(f"关键步骤失败,转人工:{e}")
        return on_fail(e)  # on_fail 通常是把工单推进人工队列

# 板斧 4 回滚通常需要结合事务,伪代码示意:
def refund_with_rollback(order_id):
    saved = backup_state(order_id)   # 先备份
    try:
        deduct_stock(order_id)
        do_payment(order_id)
    except Exception:
        restore_state(order_id, saved)  # 失败则回滚
        raise
6.2 小结
- 出错是常态,必须提前想对策。
- 四板斧:重试(可恢复)、跳过(非关键)、降级人工(关键)、回滚(有副作用)。
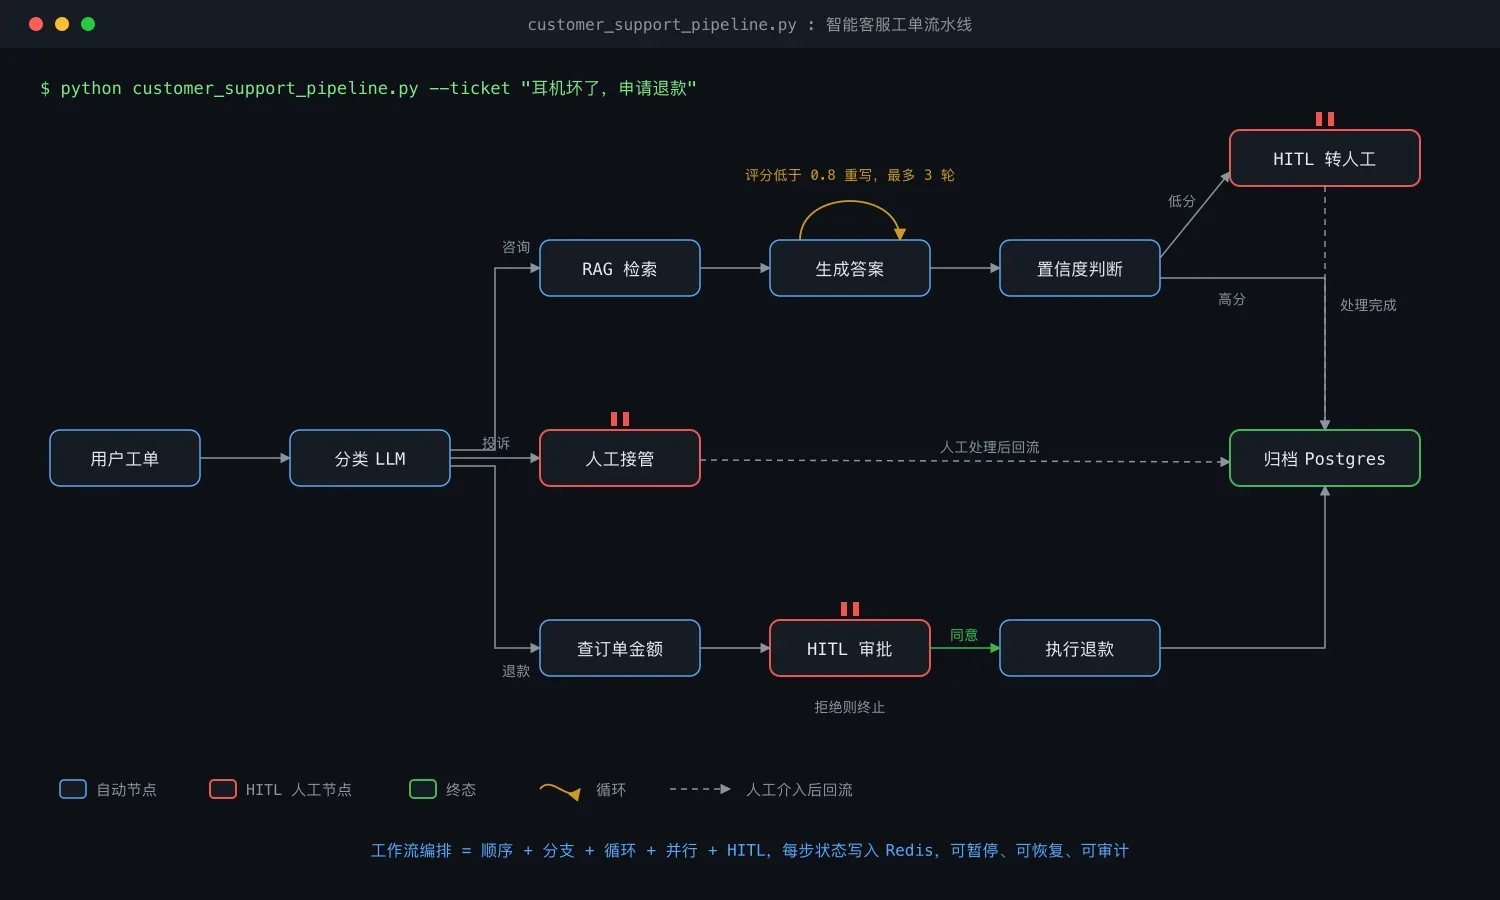
七、实战案例:智能客服工单处理流水线
前面六节全是零件,现在我们把它们组装成一台完整的机器:一条"智能客服工单流水线"。这是面试里特别爱考、JD 里反复出现的典型场景。
7.1 业务需求
用户发来一条工单,系统要:
- 分类(LLM):是咨询、投诉还是退款?
- 分支:咨询类直接答,投诉类升级主管,退款类走退款流程。
- 置信度判断:LLM 回答的置信度太低?转 HITL 人工。
- 退款审批:涉及退款的,进 HITL 等主管审批。
- 迭代优化:答案质量不够好,循环改进最多 3 轮。
- 归档:处理完写入数据库留痕。
7.2 伪代码实现
下面这份伪代码把分支、循环、HITL、错误降级全串起来。它不是生产级(省略了 LLM 细节和真实 Redis 封装),但结构完整、逻辑清晰,是你日后写真实流水线的"骨架模板"。
# customer_support_pipeline.py:智能客服工单流水线(骨架版)
import os, json, uuid, logging
import redis
from openai import OpenAI

logger = logging.getLogger("support")
r = redis.Redis(host=os.getenv("REDIS_HOST","localhost"),
                port=int(os.getenv("REDIS_PORT","6379")), decode_responses=True)
client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

# ---------- 状态存取 ----------
def save(rid, state): r.set(f"ticket:{rid}", json.dumps(state, ensure_ascii=False))
def load(rid):
    d = r.get(f"ticket:{rid}"); return json.loads(d) if d else None

# ---------- 单步函数 ----------
def classify(ticket: str) -> tuple[str, float]:
    """步骤1:LLM 分类,返回 (类别, 置信度)"""
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role":"user","content":
          f"判断工单类别,只输出 咨询/投诉/退款 和置信度(0-1)。工单:{ticket}"}],
    )
    # 真实项目用 structured output 解析,这里简化
    return "退款", 0.92   # 假装解析出来

def rag_answer(ticket: str) -> tuple[str, float]:
    """步骤:RAG 检索 + 生成,返回 (答案, 置信度)"""
    # 检索细节此处省略
    return "您好,关于这个问题……", 0.6

def improve(answer: str, ticket: str) -> str:
    """循环里:改写答案"""
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role":"user","content":f"改进这个回答。工单:{ticket}\n回答:{answer}"}])
    return resp.choices[0].message.content

def do_refund(rid, amount):
    logger.info(f"run={rid} 执行退款 {amount}")

# ---------- 主流程 ----------
def run(rid: str, ticket: str):
    state = load(rid) or {"ticket": ticket}
    step = state.get("step", "classify")

    # 步骤1:分类
    if step == "classify":
        category, conf = classify(ticket)
        state.update(category=category, classify_conf=conf)
        state["step"] = "routed"
        save(rid, state)

    # 步骤2:分支
    if state["step"] == "routed":
        cat = state["category"]
        if cat == "咨询":
            state["step"] = "answer"; save(rid, state)
        elif cat == "投诉":
            state["step"] = "escalate"; save(rid, state)   # 转 HITL 接管
        elif cat == "退款":
            state["step"] = "refund_check"; save(rid, state)

    # 步骤3:咨询类,RAG + 循环优化
    if state["step"] == "answer":
        answer, score = rag_answer(ticket)
        for round_ in range(1, 4):                       # 最多 3 轮
            if score >= 0.8:
                break
            answer = improve(answer, ticket)
            # 重新打分(省略)
            score = min(score + 0.1, 0.85)
        state.update(answer=answer, answer_conf=score)
        # 步骤4:置信度低转 HITL 人工
        state["step"] = "approve_answer" if score < 0.7 else "done_low_conf"
        save(rid, state)

    # 步骤4a:答案 HITL 审批
    if state["step"] == "approve_answer":
        state["step"] = "awaiting_answer_approval"
        save(rid, state)
        print(f"答案待审批,run={rid}")
        return  # 暂停

    # 步骤3b:退款类,HITL 审批
    if state["step"] == "refund_check":
        state["amount"] = 500                            # 假装查订单
        state["step"] = "awaiting_refund_approval"
        save(rid, state)
        print(f"退款待审批,run={rid},金额={state['amount']}")
        return  # 暂停

    # 步骤3c:投诉,直接 HITL 接管
    if state["step"] == "escalate":
        state["step"] = "awaiting_human_takeover"
        save(rid, state)
        print(f"投诉转人工接管,run={rid}")
        return

    # 终态:归档
    if state["step"].startswith("done"):
        archive(rid, state)
        return

def archive(rid, state):
    logger.info(f"归档 run={rid} 类别={state.get('category')}")
    r.delete(f"ticket:{rid}")   # Redis 删掉,真实项目再写一份进 Postgres

# ---------- 恢复入口(人工审批后调用)----------
def resume(rid: str, decision: str, edited_answer: str = None):
    state = load(rid)
    if not state: raise ValueError("存档不存在")
    s = state["step"]
    if s == "awaiting_answer_approval":
        if decision == "approve":
            state["step"] = "done_approved"
        else:  # reject 或 edit
            state["answer"] = edited_answer or state["answer"]
            state["step"] = "done_approved"
        save(rid, state); run(rid, state["ticket"])
    elif s == "awaiting_refund_approval":
        if decision == "approve":
            do_refund(rid, state["amount"])
            state["step"] = "done_refunded"; save(rid, state); run(rid, state["ticket"])
        else:
            state["step"] = "done_rejected"; save(rid, state)
    elif s == "awaiting_human_takeover":
        state["step"] = "done_human"; save(rid, state)

if __name__ == "__main__":
    rid = str(uuid.uuid4())[:8]
    run(rid, "我买的耳机坏了,要退款")
    # 会停在 awaiting_refund_approval
    # (此时服务可重启,状态在 Redis)
    resume(rid, "approve")   # 主管点同意,自动退款 + 归档
这条流水线里,分支、循环、HITL、状态管理、错误降级全部出场:
- 分支:分类后三条岔路(咨询、投诉、退款)。
- 循环:咨询类答案不达标时,最多重写 3 轮。
- HITL:答案审批、退款审批、投诉接管,三种模式全覆盖。
- 状态管理:每步存 Redis,resume 从断点恢复。
- 降级:置信度低转人工(escalate)。
这就是一条"生产可用骨架"。真实项目里你只要把各个 step 函数换成真实的 LLM、数据库、业务系统调用,骨架原样能用。
八、工作流可视化:用"图"来设计工作流
读完上面这条流水线,你可能会发现一件事:用 if/else 和函数堆出来的工作流,一旦超过 5 步就开始难读懂了。步骤一多,分支一多,循环一多,光看代码根本理不清"谁连到谁"。
业界解决这个问题的标准答案是:把工作流看成一张"图",节点(node)加边(edge)。
- 节点:每个处理步骤是一个节点(分类、RAG、退款、HITL 审批等)。
- 边:节点之间的跳转关系。边可以是"无条件"的(A 完了一定去 B),也可以是"条件"的(A 完成后,根据结果去 B 或 C)。
本篇讲的所有控制流都能用图表达:
| 控制流 | 图的样子 |
|---|---|
| 顺序 | A 到 B 到 C(一条直线) |
| 分支 | A 经条件边到 B 或 C |
| 循环 | B 经条件边回到 A |
| HITL | 一个特殊节点,自带"暂停与恢复" |
| 并行 | A 同时分叉到 B、C、D,再汇合到 E |
用图思维设计工作流,最大的好处是"可视化":你在白板上画一张图,业务方一眼就能看懂流程,工程师一眼就能定位问题节点。LangGraph、Dify 这类编排框架,本质上就是"让你用代码定义一张图,框架帮你跑这张图":分支、循环、HITL、并行、断点恢复,框架全帮你封装好了,你只管画图。
本篇用纯 Python 手搓了所有控制流和 HITL,目的是让你彻底理解底层原理。理解了原理,上手 LangGraph、LlamaIndex 这类框架时,你会发现框架做的事不过是把你刚手写的那些代码"换个更优雅的写法",但底层的状态机、存档恢复、分支循环,就是你今天学的这一套。也正因为步骤一多纯手写就会又长又脆,业界的解法是用框架:把节点、边、状态、HITL 这些通用能力封装好,你只管"声明"工作流长什么样,框架帮你跑。
全文小结
- 工作流编排 = 给 Agent 套业务骨架:解决单步 Agent"不能分叉、不能暂停、不能恢复"的三堵墙。
- 四种基本控制流:顺序(函数链)、分支(if-else)、循环(重试加迭代,必须有退出条件)、并行(互不依赖同时跑)。
- HITL 是本篇重中之重:给 AI 装刹车,关键步骤暂停等人。三种模式:审批(是/否)、编辑(改一改)、接管(人顶上)。
- 判断要不要 HITL:错了赔不赔得起、能不能撤销、涉不涉及身家性命,任一为是,就必须加。
- 暂停与恢复 = 存档加读档:用状态机思路,每步把 step、中间结果、history 存到 Redis,撞上 HITL 节点就主动退出存档;人审核完调用 resume 读档接着跑。
- 状态管理:Redis 跑运行态(快),Postgres 做归档审计(久);必存 step 和 history。
- 错误降级四板斧:重试(可恢复)、跳过(非关键)、降级人工(关键)、回滚(有副作用)。
- 实战流水线:智能客服工单(分类、分支、RAG 加循环、HITL 审批、归档)把全部知识点串成一条生产可用骨架。
- 图思维是工作流的进化方向:节点加边,可视化、可读、可维护,LangGraph 这类框架做的就是"用代码画图、框架跑图"。
动手练习
练习 1(基础):把 2.2 节的分支代码扩展成"四分支",增加一个"建议/反馈"类,走"收集建议 → 感谢用户 → 归档"流程。要求:分类函数、处理函数、主分支逻辑都自己写,跑通至少 2 个不同类别的工单,观察它走对路径。目的:练熟分支结构。
练习 2(进阶):基于第 4 节的 hitl_workflow.py,改造出一个"两段式 HITL",退款金额大于 1000 要经过两级审批(主管加财务)。提示:你需要把状态机的 step 设计成 awaiting_mgr、awaiting_finance、approved 三段,每次 resume 只推进一段。目的:亲手实现多级审批的状态机,彻底搞懂"暂停与恢复"。
练习 3(挑战):把第 7 节的客服流水线真的跑起来:分类、RAG、退款分别用真实的 LLM 调用(API Key 用 os.getenv),Redis 用本地或 Docker 起一个。然后模拟这些场景测一遍:咨询类高分(直接归档)、咨询类低分(转人工)、退款类(等审批后退款)、投诉类(直接接管)。最后把服务重启一次,验证 resume 能从断点接着跑。目的:把本篇所有知识点在一条真实流水线上跑通,这是你简历上能写的项目。
延伸阅读
- LangGraph 官方文档 Human-in-the-Loop(HITL 的官方实现思路,本篇手写的版本是其简化):https://langchain-ai.github.io/langgraph/concepts/human_in_the_loop/
- Temporal 工作流引擎:生产级长流程编排,状态持久化做得极好,理解"断点续跑"的工业级方案:https://docs.temporal.io/
- Prefect 与 Airflow 对比:数据工程领域的两大编排框架:https://www.prefect.io/blog/airflow-vs-prefect
- Dify 工作流文档:低代码可视化编排,HITL 节点开箱即用:https://docs.dify.ai/guides/workflow
- n8n 文档:开源自动化编排,Execute Workflow 节点支持子流程:https://docs.n8n.io/
- 状态机(FSM)入门:理解工作流的数学基础:https://en.wikipedia.org/wiki/Finite-state_machine
- 论文 ReAct:理解 Agent"思考、行动、观察"循环与工作流的关系
- Amazon AWS 的 HITL 实践指南:云厂商的生产经验,讲哪些场景必须人审:https://docs.aws.amazon.com/sagemaker/latest/dg/human-in-the-loop.html