字节笔记本
2026年10月6日 · 约 31 分钟读完
AI 工作流 17:两大 LLM 框架怎么选
本文是 AI 工作流系列的第 17 篇。前几篇我们把最小 RAG、完整的文档处理流水线、能拆任务会调工具的 Agent 都手写了一遍,每段代码动辄两三百行,你大概率边抄边嘀咕:这些套路化的活儿,难道没有现成轮子?当然有。打开任意 2026 年的 AI 工程师 JD,加分项十有八九写着熟悉 Dify、LangChain、LlamaIndex、LangGraph。其中 Dify 是低代码平台,LangGraph 是编排引擎,本文都不展开;这里只讲其中两个库:LangChain 和 LlamaIndex,当下 Python 圈最主流的两大 LLM 应用框架。本篇把它们掰开揉碎:定位差异、核心概念对照、上手代码、场景选型,以及什么时候你压根不该用框架。
一、为什么需要框架:自己造车不如买现成汽车
想象你急着要一辆能开的车,只有两条路。
路线 A,自己造车:从炼钢开始,自己锻造底盘、缠线圈、写发动机点火程序。好处是每个零件你都懂、都能改;坏处是等你把车开上路,别人家生意都做完三轮了。
路线 B,去 4S 店买现成汽车:交钱、拿钥匙、踩油门就走。发动机、变速箱别人已调好,你只要会打方向盘。代价是,想把发动机换成核动力?销售会说:先生,这得自己改,改坏了不保修。
LLM 框架就是路线 B。我们手写的 RAG 流水线,每一行都是"自己造车":自己拼 Prompt、自己算余弦相似度、自己写 while 循环。这些活儿九成是重复的:所有 RAG 都要切片、向量化、拼 Prompt;所有 Agent 都要解析工具调用、管理对话历史。框架把这些重复的轮子封装成现成零件,你只要像积木一样拼起来。
一句话:框架不是让你"不用懂原理",而是让你懂了原理之后,不用每次都从零写一遍。
给框架下个正式定义:LLM 应用框架是封装"大模型应用常见模式"的代码库,提供统一抽象(Chain、Index、Agent),让你用更少代码搭出 RAG、Agent、对话机器人等应用,并方便切换底层模型、向量库与 Prompt。
二、LangChain:通用 LLM 应用的万能瑞士军刀
LangChain 就像那把万能瑞士军刀:刀、剪刀、开瓶器、螺丝刀、小锯子。每把工具都不是最专业的,但胜在啥都有、啥都能凑合干。今天想调 LLM,明天做 RAG,后天搭 Agent,掏出同一把军刀就能开工,不用满世界找工具箱。
它的核心理念是模块化加可组合:把"调模型""拼 Prompt""加记忆""调工具"各做成一个独立模块(官方叫 Runnable),再用 LCEL(LangChain Expression Language)把它们像水管一样接起来。
| 模块 | 干什么 | 生活类比 |
|---|---|---|
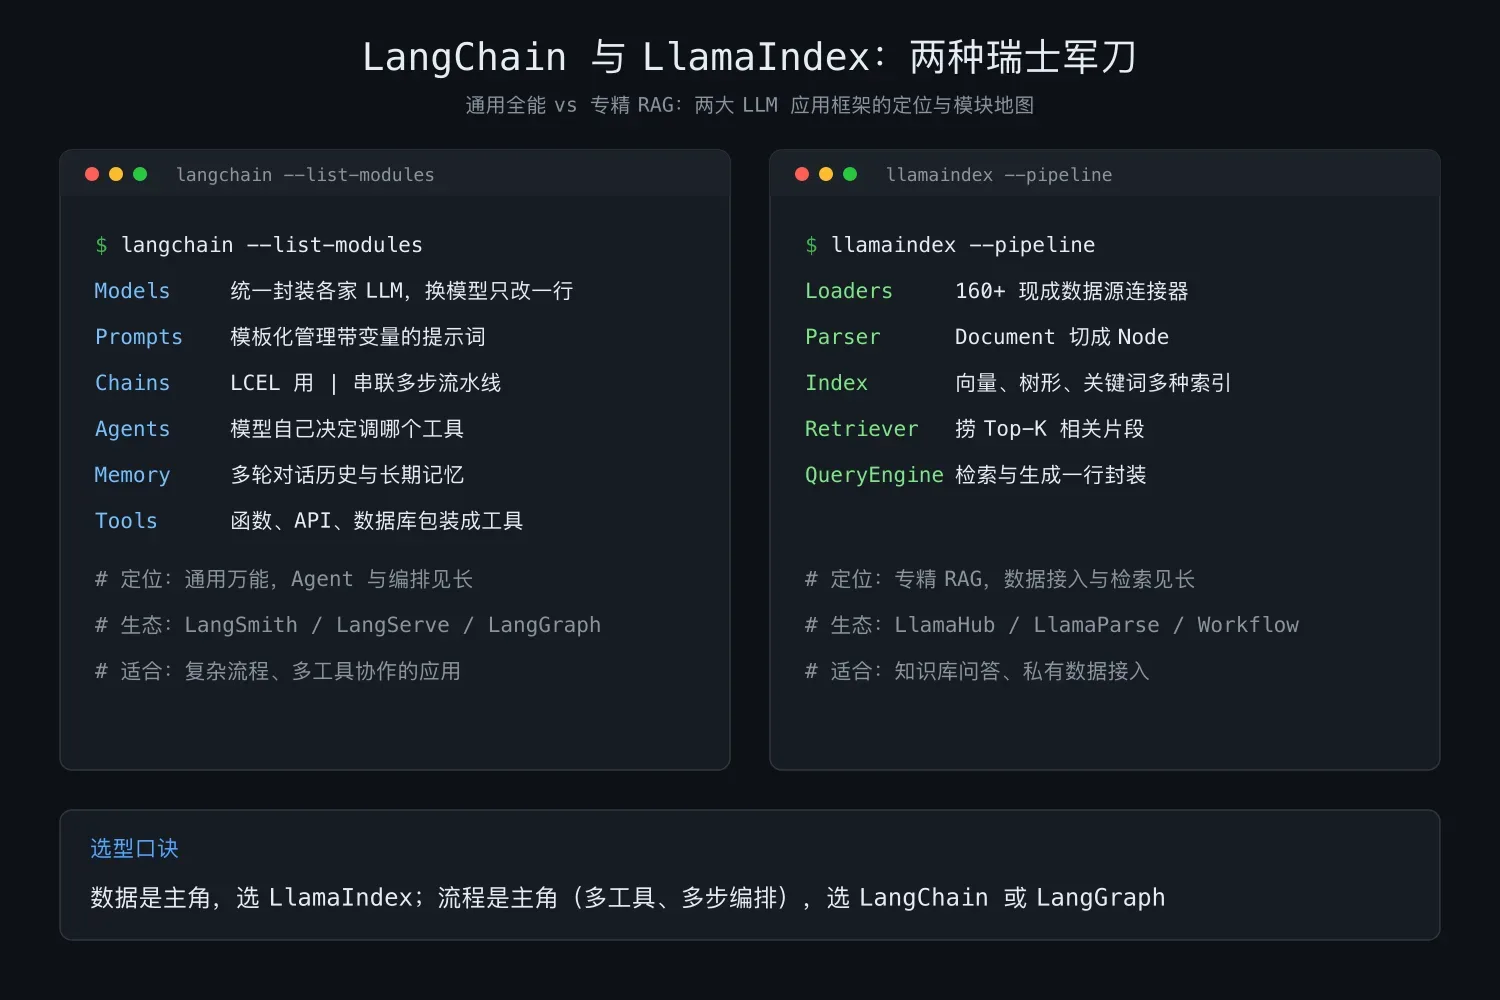
| Models | 统一封装各家 LLM(OpenAI、通义、Claude、本地 Ollama),换模型只改一行 | 发动机舱,可换装 |
| Prompts | 用 ChatPromptTemplate 管理带变量的提示词,告别 f-string 拼字符串 | 信封模板 |
| Chains | 用 LCEL 把多步接成一条流水线(组件之间用管道符串联) | 流水线传送带 |
| Agents | 让 LLM 自己决定调哪个工具,循环到任务完成 | 有判断力的工人 |
| Memory | 记住多轮对话历史(摘要、滑窗、向量记忆) | 工人的小本本 |
| Tools | 把函数、API、数据库查询包装成"工具"供 Agent 调用 | 工人手边的扳手 |
三、LlamaIndex:为检索而生的数据工程师军刀
如果 LangChain 是"什么都有但啥都不算最精"的万能军刀,那 LlamaIndex 就是一把为数据工程师量身定制的专用军刀:刀片少一些,但每把都为"读文档、切文档、查文档"打磨到极致。它默认假设你的核心诉求是:我有一堆 PDF、数据库、网页,想让 AI 精准回答关于它们的问题。
LlamaIndex 前身叫 GPT Index,从名字能看出血统:它为检索(Index)而生。在 RAG 赛道上,它开箱即用的程度比 LangChain 高一截:读目录、建索引、提问,三行代码搞定。
正式定义:LlamaIndex 是专注 RAG 与数据连接的 LLM 应用框架,强项是文档加载(Data Connectors)、解析与切片(Node 与 Parser)、索引构建(Index,含向量、树形、关键词多种)、检索(Retriever)和查询引擎(QueryEngine)。目标一句话:让你的私有数据和大模型无缝连接。
两大框架的定位与模块地图,一张图看懂:
四、核心概念对照:两套黑话一张表
两大框架各有自己的名词体系,初学者最容易犯迷糊。其实它们很多概念一一对应,只是叫法不同。下面这张表是"黑话翻译字典",建议收藏。
| 你想干的事 | LangChain 叫法 | LlamaIndex 叫法 | 一句话区别 |
|---|---|---|---|
| 把一段原始文本切成小块 | RecursiveCharacterTextSplitter | SentenceSplitter 或 Node 解析 | LlamaIndex 切完直接叫 Node,LangChain 叫 Document |
| 存向量的地方 | VectorStore(FAISS、Chroma) | VectorStoreIndex | LlamaIndex 把"索引"和"存储"揉在了一起 |
| 从库里捞 Top-K 相关片段 | Retriever(as_retriever()) | Retriever(index.as_retriever()) | 名字一样,API 长得像 |
| 把"检索加生成"串成一条 | Chain(LCEL 串联) | QueryEngine(index.as_query_engine()) | LlamaIndex 一行封装好,LangChain 要自己拼 |
| 让模型记住多轮对话 | Memory(ConversationBufferMemory) | ChatMemoryBuffer | 概念一致 |
| 让模型自己决定调工具 | Agent(LangGraph) | Agent(ReActAgent) | LangChain 这块已大量迁往 LangGraph |
| 一段结构化的文档单元 | Document(page_content 加 metadata) | Document 拆成 Node | LlamaIndex 多一层 Node,粒度更细 |
记住这张表,以后看任何框架的教程都不会迷路:无论它用什么术语,本质都是 RAG 五大环节(解析、切片、向量化、检索、生成)的不同封装。
五、LangChain 上手:从一行代码到完整 RAG
先装环境:
pip install -U langchain langchain-openai langchain-community faiss-cpu第一步,调一个 LLM,最小例子:
import os
from langchain_openai import ChatOpenAI

# 所有 API Key 一律从环境变量读,绝不硬编码
llm = ChatOpenAI(
    model="gpt-4o-mini",
    temperature=0.7,
    api_key=os.getenv("OPENAI_API_KEY"),
)

# 直接传一个字符串,模型当成"人类消息"
response = llm.invoke("用一句话解释什么是 RAG")
print(response.content)
和用 openai 原生 SDK 直接写相比,行数差不多,但 LangChain 的好处是换模型只改 import:把 ChatOpenAI 换成 ChatTongyi(通义)或 ChatOllama(本地),其余代码一行不动。
第二步,PromptTemplate 加 LCEL 链式调用。LCEL 是 LangChain 的灵魂:用管道符把组件像水管一样接起来。生活类比是厨房流水线:洗菜槽、切菜板、炒锅、装盘,每一步的输出自动喂给下一步。
import os
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

llm = ChatOpenAI(model="gpt-4o-mini", api_key=os.getenv("OPENAI_API_KEY"))

# 1. 定义带变量的 Prompt 模板(告别 f-string 拼字符串)
prompt = ChatPromptTemplate.from_template(
    "你是一位{role}。请用小学生能听懂的话,解释"{concept}"这个概念,不超过 80 字。"
)

# 2. 用 LCEL 把三段接成一条流水线:prompt | llm | parser
chain = prompt | llm | StrOutputParser()

# 3. 调用,传变量
result = chain.invoke({"role": "幼儿园老师", "concept": "黑洞"})
print(result)
prompt、llm、parser 三段串联,等价于"先填模板,把 Prompt 发给模型,把返回对象解析成纯字符串"。每段都是可替换积木,想加"翻译成英文",再接一段翻译 Chain 即可。这就是 LCEL 的魅力:流水线一眼看穿,扩展随便加段。
第三步,完整 RAG。手写最小 RAG 大约要 200 行,用 LangChain 压到 30 行左右:
import os
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import FAISS

# 1. 加载文档(这里用 txt,换成 PDFLoader / WebBaseLoader 同理)
loader = TextLoader("company_refund_policy.txt")
docs = loader.load()

# 2. 递归切片:先按段落、再按句子,保语义完整
splitter = RecursiveCharacterTextSplitter(chunk_size=300, chunk_overlap=50)
chunks = splitter.split_documents(docs)

# 3. 向量化并存进 FAISS(一行搞定,Embedding 用 OpenAI)
embeddings = OpenAIEmbeddings(
    model="text-embedding-3-small",
    api_key=os.getenv("OPENAI_API_KEY"),
)
vectorstore = FAISS.from_documents(chunks, embeddings)

# 4. 把向量库变成"检索器",每次捞 Top-3
retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

# 5. 拼 RAG Prompt
prompt = ChatPromptTemplate.from_template(
    "请根据下面的资料回答问题。如果资料里没有,就说"我不知道"。\n\n"
    "【资料】\n{context}\n\n【问题】{question}"
)

llm = ChatOpenAI(model="gpt-4o-mini", api_key=os.getenv("OPENAI_API_KEY"))

# 6. 用 LCEL 把"检索、拼 Prompt、调模型、解析"接成一条流水线
def format_docs(docs):
    return "\n\n".join(d.page_content for d in docs)

rag_chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)

# 7. 提问
answer = rag_chain.invoke("你们公司的退款政策是什么?")
print(answer)
对比手写版:那段代码手算了余弦相似度、手拼了 Prompt、手发了 HTTP 请求;这里全部交给框架,核心业务逻辑(捞哪几段、怎么拼、怎么问)一眼可见。这就是框架的价值。
六、LlamaIndex 上手:五行代码的 RAG
先装环境(v0.10 起拆分成多个子包,按需装):
pip install -U llama-index llama-index-llms-openai llama-index-embeddings-openaiLlamaIndex 用一个全局 Settings 对象管模型(旧版 ServiceContext 已废弃)。设一次,所有 Index 和 QueryEngine 都默认用它。
import os
from llama_index.core import Settings
from llama_index.llms.openai import OpenAI
from llama_index.embeddings.openai import OpenAIEmbedding

# 全局配置:LLM 用哪个、Embedding 用哪个
Settings.llm = OpenAI(
    model="gpt-4o-mini",
    temperature=0.1,
    api_key=os.getenv("OPENAI_API_KEY"),
)
Settings.embed_model = OpenAIEmbedding(
    model="text-embedding-3-small",
    api_key=os.getenv("OPENAI_API_KEY"),
)
然后是它的招牌,五行代码的 RAG:
import os
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader, Settings
from llama_index.llms.openai import OpenAI
from llama_index.embeddings.openai import OpenAIEmbedding

# 1. 配模型
Settings.llm = OpenAI(model="gpt-4o-mini", api_key=os.getenv("OPENAI_API_KEY"))
Settings.embed_model = OpenAIEmbedding(
    model="text-embedding-3-small", api_key=os.getenv("OPENAI_API_KEY")
)

# 2. 读一个目录(自动识别 txt/pdf/md/docx/csv 等)
documents = SimpleDirectoryReader("./data").load_data()

# 3. 建向量索引(内部自动切片加向量化,默认 SentenceSplitter)
index = VectorStoreIndex.from_documents(documents)

# 4. 提问
query_engine = index.as_query_engine()
response = query_engine.query("我们公司的退款政策是什么?")
print(response)
就这。没有手写切片,没有手拼 Prompt,LlamaIndex 把 RAG 标准套路的默认值给得很到位,对新手极其友好。代价是:想精细控制(混合检索、加 Rerank、改 Prompt),就得翻它层层封装的 API。
七、同一个 RAG 的两种写法:代码量与控制力
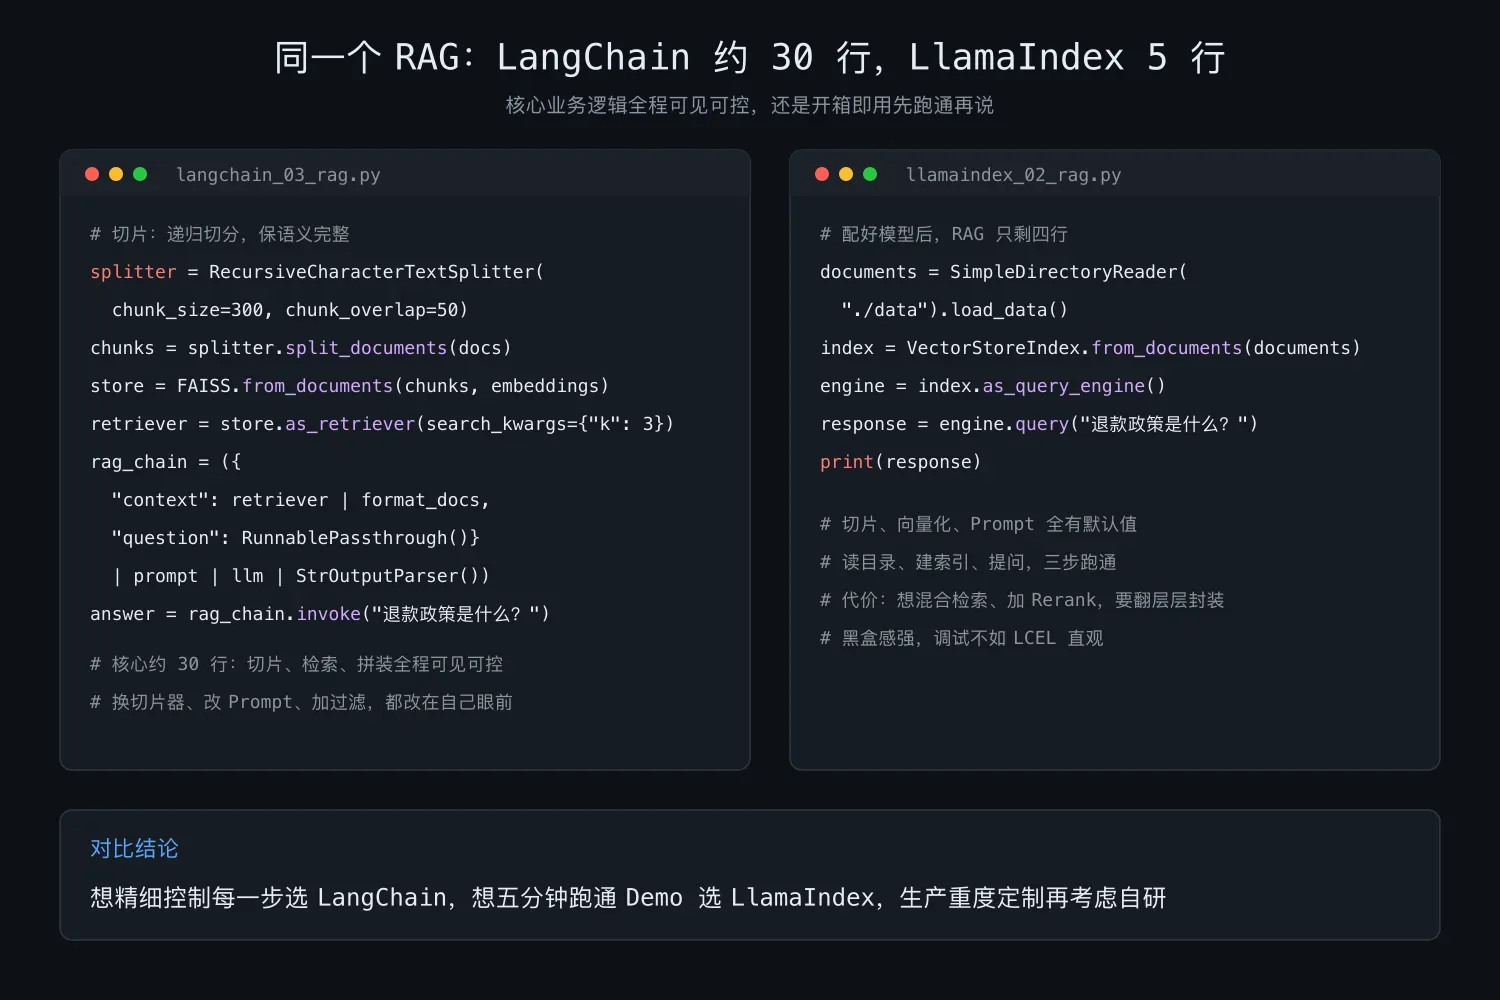
把第五节和第六节的两个 RAG 摆在一起,最直观:
| 维度 | LangChain 版 RAG | LlamaIndex 版 RAG |
|---|---|---|
| 核心代码行数 | 约 30 行 | 约 10 行 |
| 切片控制 | 显式调 RecursiveCharacterTextSplitter,参数全暴露 | 默认 SentenceSplitter,想改查文档 |
| Prompt 定制 | 自己写 ChatPromptTemplate,完全透明 | 内置默认 Prompt,想改得覆写 |
| 流程透明度 | LCEL 一眼看穿每一步 | 一句 query() 全包,黑盒感强 |
| 改成 Agent | 自然,加 Tools 即可(或迁 LangGraph) | 也能做,但 RAG 才是主场 |
| 适合人群 | 想精细控制每一步的人 | 想五分钟跑通 Demo 的人 |
八、场景选型决策表:什么场景用哪个
光看代码不够,实战中你该选哪个?这张决策表是本篇压箱底的干货。
| 你的场景 | 推荐选择 | 理由 |
|---|---|---|
| 纯 RAG、企业知识库(问答为主) | LlamaIndex | 默认值好,5 行跑通;LlamaHub 覆盖 160 多个数据源 |
| 复杂 Agent、多工具编排 | LangChain(或上 LangGraph) | Agent 抽象成熟,工具组合灵活,循环控制强 |
| 快速原型、Demo(明天要演示) | 都行,看团队熟悉度 | LlamaIndex 更快上手,LangChain 生态更广 |
| 重度定制(混合检索、Rerank、改写全自调) | LangGraph 或自研 | 框架封装是负担,可参考手写实现的思路 |
| 对接一堆 SaaS(Notion、飞书、Slack) | LlamaIndex(LlamaHub) | 现成 Loader 一把梭,省去自己写 API 对接 |
| 对话机器人加长期记忆 | LangChain | Memory 模块成熟,Agent 与 Memory 配合顺手 |
| 生产环境、要可观测 | LangChain(配 LangSmith) | 链路追踪、Prompt 调试、评估一条龙 |
一句话心法:
- 数据是主角,选 LlamaIndex;
- 流程是主角(Agent、多步、条件分支),选 LangChain 或 LangGraph;
- 不确定,先用 LlamaIndex 跑通 Demo,再决定要不要迁。
九、框架的"反噬":什么时候你不该用框架
讲了一上午框架的好话,必须泼盆冷水:框架不是银弹,用错场景会被反噬。真实生产里,"框架用着用着又拆掉自己重写"的故事一抓一大把。原因有三个。
9.1 过度封装,难调试
框架为了"开箱即用",把简单逻辑包了好几层抽象。出 bug 时打印堆栈,十几层框架内部调用看得你怀疑人生:明明只是 Prompt 没拼对,却报一个不知所云的 ValidationError。手写版 print 两行就能定位的问题,框架版可能要翻半天源码。
9.2 版本飞奔,破坏性变更频繁
两大框架都是迭代极快的项目(2023 到 2026 大改了好几轮)。LangChain 早期经典的 LLMChain、ConversationChain 已标记过时,官方推荐迁到 LCEL;LlamaIndex 旧 ServiceContext 被 Settings 取代。今天按教程写的代码,半年后可能跑不起来;生产系统锁死老版本,又会错过新特性和 bug 修复。
9.3 生产环境,自己写可能更可控
不少团队用 LangChain 搭原型很快,但上生产后发现:并发、超时、重试、链路追踪、成本统计这些生产级需求,框架要么不支持要么难插。最后剥离框架、用原生 SDK 重写,代码量从 30 行变 200 行,但每行都自己说了算。
9.4 "框架 vs 自研"的判断标准
怎么判断你这个项目该用框架还是自研?四条标准:
| 判断维度 | 用框架 | 自研 |
|---|---|---|
| 阶段 | Demo、原型、内部工具 | 生产核心系统 |
| 团队 | 对框架熟悉、跟得上版本 | 想完全可控、人手够 |
| 需求 | 标准套路(普通 RAG、Agent) | 高度定制(混合检索、自定义调度) |
| 性能要求 | 中低吞吐 | 高并发、低延迟、要细控超时重试 |
我的建议:永远先用框架跑通原型验证可行性,再决定生产要不要自研。别一上来手写 500 行浪费时间验证,也别一上来锁死框架上生产、后面改不动。框架是脚手架,不是地基。
十、生态与社区:先找现成的轮子
框架本身的代码只占价值的三成,剩下七成是生态:别人写好的集成、工具、调试平台。两大框架都有庞大生态,下面几个必须知道。
LangChain 生态:
- LangSmith:官方可观测与调试平台,能看到每次 Chain 调用的完整链路(哪步花多少 token、Prompt 长啥样、返回什么),是排查 RAG 和 Agent 问题的利器,生产环境强烈建议接入。
- LangServe:把一条 Chain 一键部署成 REST API(自动生成 FastAPI 路由和 Playground 页面),适合快速给前端提供接口。
- LangGraph:LangChain 团队做的"有状态、可循环"的 Agent 编排引擎,复杂 Agent 已大多不再用老 Agent,而是迁到 LangGraph。
- LangChain Hub:社区共享的 Prompt 和 Agent 模板仓库,一行命令拉现成方案。
LlamaIndex 生态:
- LlamaHub:LlamaIndex 的"应用商店",160 多个现成数据加载器,Notion、飞书、Slack、Confluence、GitHub、YouTube、Google Drive,你想接的数据源几乎都有人写好 Loader,这是它最大的护城河。
- LlamaParse:官方云端文档解析,对复杂 PDF(表格、图表、多栏)解析效果比本地强一截,企业级 RAG 常用。
- LlamaIndex Workflow:类似 LangGraph 的事件驱动编排,适合做复杂 RAG 流程(查询改写、检索、Rerank、生成)。
找集成的通用心法:不管用哪个框架,遇到"我要接某个服务"时,先去集成目录搜,别自己写。LangChain 搜 langchain-community 包,或访问 integrations.langchain.com;LlamaIndex 访问 llamahub.ai,按数据源、向量库、LLM 分类找。九成常见集成都有现成的,自己写对接是最后的兜底。
十一、小结
- 框架是现成汽车:把 RAG 和 Agent 的套路化代码封装成零件,让你专注业务,不为重复轮子浪费时间。
- LangChain 是万能瑞士军刀:六大模块(Models、Prompts、Chains、Agents、Memory、Tools),LCEL 用管道符接流水线,通用、灵活、啥都能干。
- LlamaIndex 是数据工程师军刀:专注 RAG,默认值好,5 行跑通知识库问答,强项是数据接入和检索。
- 核心概念一一对应:LangChain 的 Document、VectorStore、Chain 对应 LlamaIndex 的 Node、Index、QueryEngine,本质都是 RAG 五大环节的不同封装。
- LangChain 上手路径:ChatOpenAI 调模型,ChatPromptTemplate 加 LCEL 接链,RecursiveCharacterTextSplitter 加 FAISS 做 RAG。
- LlamaIndex 上手路径:Settings 配模型,SimpleDirectoryReader 读目录,VectorStoreIndex 建索引,query_engine.query() 提问。
- 选型口诀:数据主角选 LlamaIndex;流程主角选 LangChain 或 LangGraph;不确定先用 LlamaIndex 跑 Demo。
- 框架会反噬:过度封装难调试、版本飞奔破坏性变更多、生产环境可能自研更可控。
- 生态占七成价值:LangSmith、LangServe、LangGraph 对阵 LlamaHub、LlamaParse、Workflow;遇到新集成先去集成目录搜。
- 心法:先用框架跑通原型验证可行性,再决定生产要不要自研。框架是脚手架,不是地基。
十二、动手练习
练习 1(基础):装好 LangChain,跑通第五节的 hello LLM 和 LCEL 两段代码。然后把 ChatOpenAI 换成本地 ChatOllama(需先装 Ollama 并拉一个模型),验证是不是只改 import 其余不动,感受"换模型只改一行"。
练习 2(进阶):找一份公司真实文档(手册、FAQ、规章都行),分别用 LangChain 和 LlamaIndex 各做一个 RAG,问同一个问题,对比答案质量、代码量、调试体验,把结论写成表格。这是你日后选型的第一手依据。
练习 3(挑战):在练习 2 基础上,给 LlamaIndex 的 QueryEngine 加自定义 Prompt(只根据资料回答,不知道就说不知道),给 LangChain 版加 Rerank(langchain_cohere 的 CohereRerank)。体会"默认值好用,深度定制要翻文档"的取舍。
十三、延伸阅读
- LangChain 官方文档(概念、教程、How-to):https://python.langchain.com/docs/introduction/
- LangChain LCEL 指南(必读,理解管道符串联的本质):https://python.langchain.com/docs/concepts/lcel/
- LlamaIndex 官方文档:https://docs.llamaindex.ai/
- LlamaIndex 入门教程(5 行代码入门):https://docs.llamaindex.ai/en/stable/understanding/
- LlamaHub(160 多个数据加载器):https://llamahub.ai/
- LangSmith(可观测平台):https://docs.smith.langchain.com/
- LangChain Integrations 目录:https://integrations.langchain.com/
- LangChain 迁移指南(老 API 迁新 API,处理破坏性变更必看):https://python.langchain.com/docs/versions/migrating_memory/
最后补一句方向:当 Agent 越来越复杂(循环、分支、人在回路、多 Agent 协作),基于 LCEL 的"线性链"会力不从心,你需要真正的"有状态、可循环的状态机",代表是 LangGraph;而如果团队里产品、运营同学也想搭 AI 工作流,Dify 这类低代码平台拖拖拽拽就能把 RAG 或 Agent 跑起来。代码党的深度编排和可视化党的拖拽搭建,配合本文的框架选型,基本覆盖了 AI 工作流编排的主流选择。