字节笔记本
2026年10月9日 · 约 5 分钟读完
别再等闭源管线慢慢写综述了,8B 开源模型一次写完
科学问答最怕两件事。一是闭源综述管线又慢又贵,机构还不能把未发表材料送出去。二是通用 8B 模型会写、会编,却经常把引用写飘:句子读着像那么回事,出处对不上。Allen AI 把 Asta 平台里的 Fast 模式拆出来开源,模型叫 AstaBrief-8B,任务很窄:吃进研究问题和已经检索好的文献片段,一次生成带引用的长报告,不再按章节来回调用。权重在 Hugging Face 的 allenai/AstaBrief_8B,许可证 Apache-2.0。本轮模型卡快照 63 likes、1643 downloads。训练数据 AstaBrief_DPO_Mix 一并公开。配套库 allenai/ai2-scholarqa-lib 是 Apache-2.0,本轮 API 285 星。
训练为什么不走强化学习
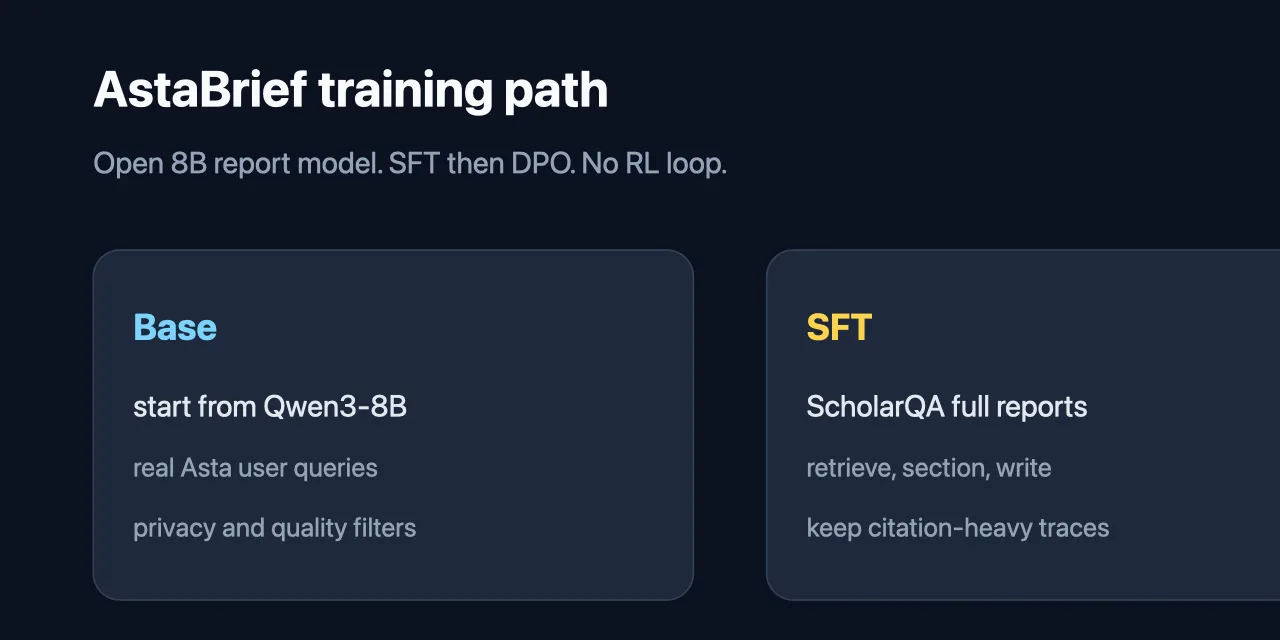
博客写明,团队看过用裁判模型做强化学习的长文路线,最后没用。理由是贵、不稳、难调试。他们把力气花在数据上。查询来自 Asta 真实用户,过滤掉内测、机器人、过短和隐私风险样本。监督微调的目标报告,由 ScholarQA 多步管线生成:检索、分节、再写成全文。DPO 用另一批查询,一对报告里一条来自 ScholarQA(常见后台是 Claude 3.5 或 3.7 Sonnet),另一条来自其它生成器。裁判是 GPT-4.1 和 DeepSeek-R1,必须双裁判一致才入集。博客写裁判与人偏好对齐约 95%,过滤后大约 6000 对。模型卡还提到生成器池里有 o3、o4-mini、GPT-4.1、DeepSeek-V3 和 DeepSeek-R1。
速度上的关键设计是一次写完。Asta 的 Thinking 模式仍走 Claude 后台的多步管线;Fast 模式把整篇报告交给这个 8B。机构可以在自己的机器上跑,未发表材料不必出域。博客提醒:这是给 Asta 报告框架用的零件,不是随口聊天的通用模型。推理请用他们公开的 SFT 提示格式,换模板可能发飘。
官方表上的数字
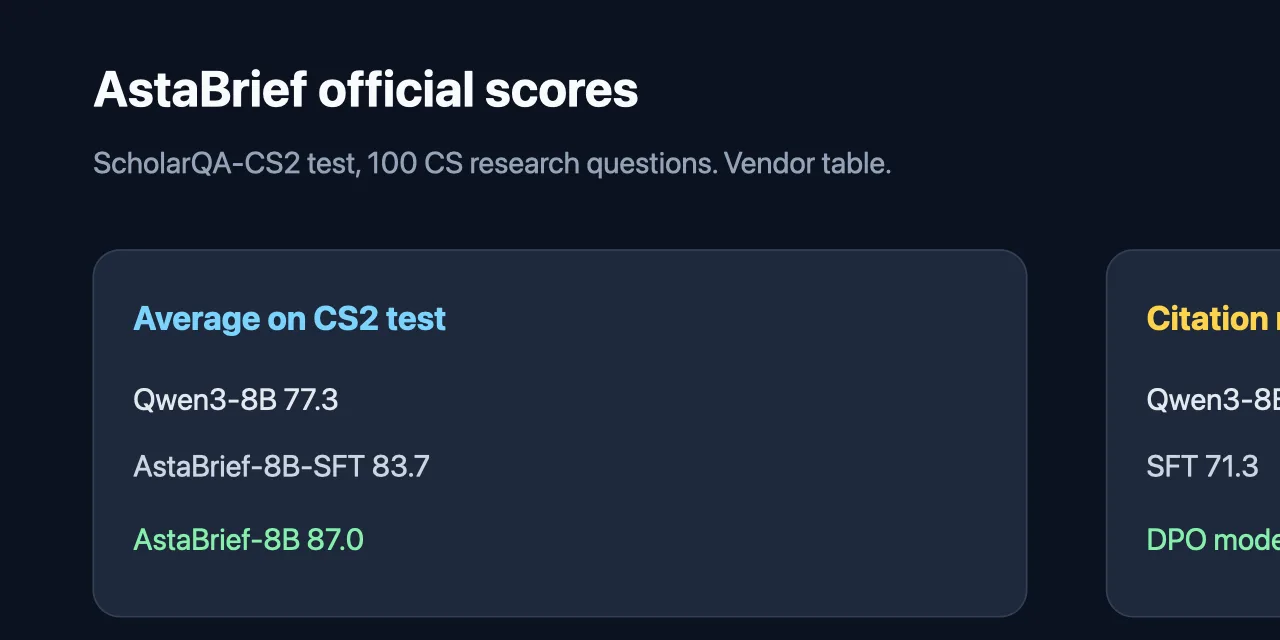
模型卡给了 ScholarQA-CS2 测试集(100 道用户写的计算机科学问题)四维平均:Qwen3-8B 77.3,SFT 检查点 83.7,DPO 后的 AstaBrief-8B 87.0。引用召回从 64.6 升到 78.2,引用精确从 76.2 升到 90.5。和 Asta ScholarQA 管线对打,开发集胜率 55%,测试集 72%。DeepScholarBench 上 AstaBrief 53.50,ScholarQA 60.25,DR-Tulu-8B 56.26,这里开源 8B 并没有赢过完整管线。博客把这些数字写成当时工程路线的验证,不是和今天所有前沿模型的总排名。
线上 Fast 模式的早期使用:374 名试过的用户里,29.1% 第二天还来,人均 3.67 条报告线程。正向反馈 84.2%,Thinking 模式 85.2%。样本稀疏,作者自己说不足以下强结论。博客还写了一次更朴素的过滤实验:比起一堆复杂规则,看合成报告是否坚持给论断配引用,对引用质量更有用。第一次 SFT 提高了文笔,但答案精度和引用仍落后 Claude 管线,DPO 才把差距收窄。
本机怎么调
from transformers import AutoTokenizer
from vllm import LLM, SamplingParams

model_name = "allenai/AstaBrief_8B"
tokenizer = AutoTokenizer.from_pretrained(model_name)
llm = LLM(model=model_name)
messages = [{"role": "user", "content": formatted_sft_prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
outputs = llm(text, SamplingParams(temperature=0.7, top_p=0.95, max_tokens=4096))
formatted_sft_prompt 要用官方提示,把问题和文献片段填进去。博客还释放了从本地 PDF 做报告的示例工作流。本轮数字来自 Hugging Face 博文和模型卡,不是第三方复现。