字节笔记本
2026年10月9日 · 约 4 分钟读完
不微调导航模型,凭什么在陌生场景里找路?
通用服务机器人要同时满足两件事:听得懂各种各样的人话,并且在训练没见过的房间里还能走完。现成做法常把多模态大模型拿去微调,让它直接吐导航动作。代价是行为被导航训练集罩住,换一种说法、换一栋楼,就容易掉。浙江大学 3DV 组和 Causa Robotics 在 arXiv 2610.12126 的 SuperNav 把分工拧过来:模型只管读请求、看场景、做决定;走路交给工具。多模态骨干不做导航向微调。项目页在 zju3dv.github.io/SuperNav,代码仓 zju3dv/SuperNav,本轮快照约 10 星。Hugging Face Daily Papers 当日约 60 票。
冻结模型之后,harness 补什么
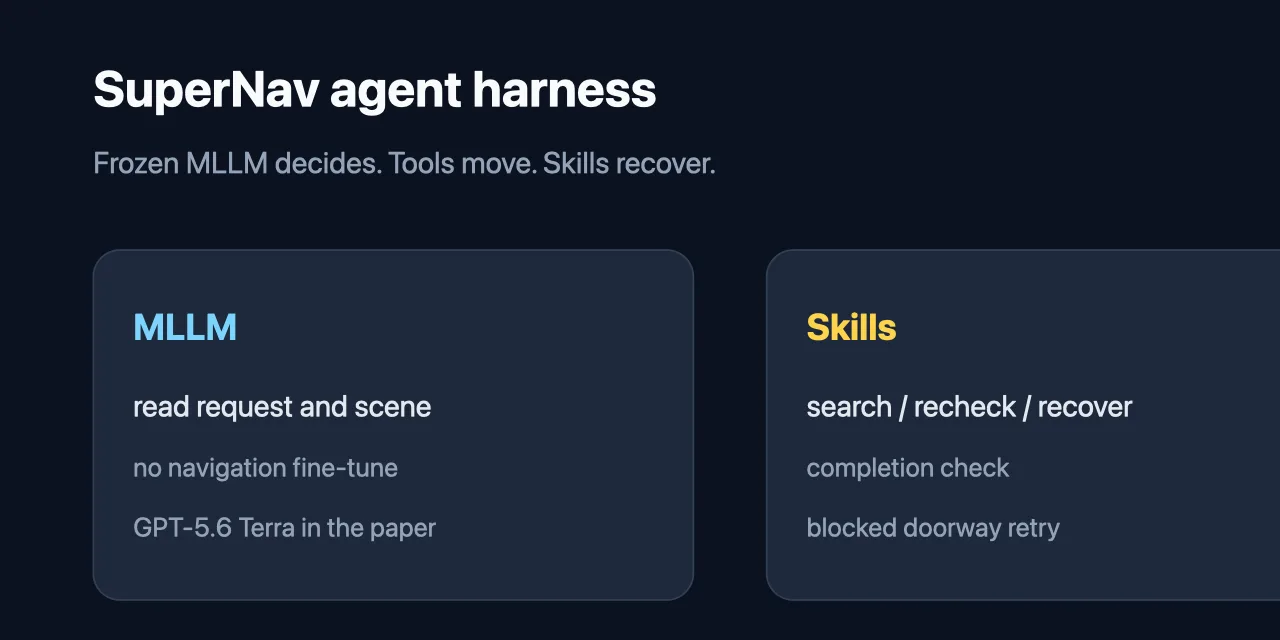
论文把系统写成一个可持续决策的 Agent 环。请求可能是找某个物体、按顺序拜访多个目标,或“找个能休息的地方”这种需求句。模型解释完成条件,harness 负责执行和上下文。三块零件绑在一起:
导航技能是模型可读的说明书,覆盖搜索、候选复核、受阻恢复和完成判定。论文封面图就是技能引导的沙发搜索:候选要再看一遍,门口堵住要折返,完成还要核验。
面向 agent 的工具覆盖初始化、观察、转向、视觉点选导航、目标进度和终止。观察一次返回前、右、后、左四张 RGB,并按机器人朝向打标签。运动接口是统一的视觉点选:模型在某张图上给出归一化坐标,工具在内部走完,再把新的四视图、执行状态和简短诊断交回去。几何执行器 Geo-based Executor 用深度、标定和位姿把像素点落到场景位置再规划;也可以换成 Learned Executor。模型和低层动作解耦,换腿不换脑。
任务进度和上下文管理让多目标、需求驱动的长程不会把“已经确认过的东西”弄丢。消融里,拿掉导航技能对成功率的打击,大于把相机收成只看前方。
官方表上的数字
实验默认决策模型是 GPT-5.6 Terra,执行器是 Geo-based 或 Learned。Habitat-GS 上用 InteriorGS 场景评单物体和有序多物体,需求驱动走改编协议。论文写:单物体成功率 78.00%,需求驱动 59.50%;对应最强基线是 UniNaVid 的 34.00% 和 OmniNav Action Former 的 37.50%。
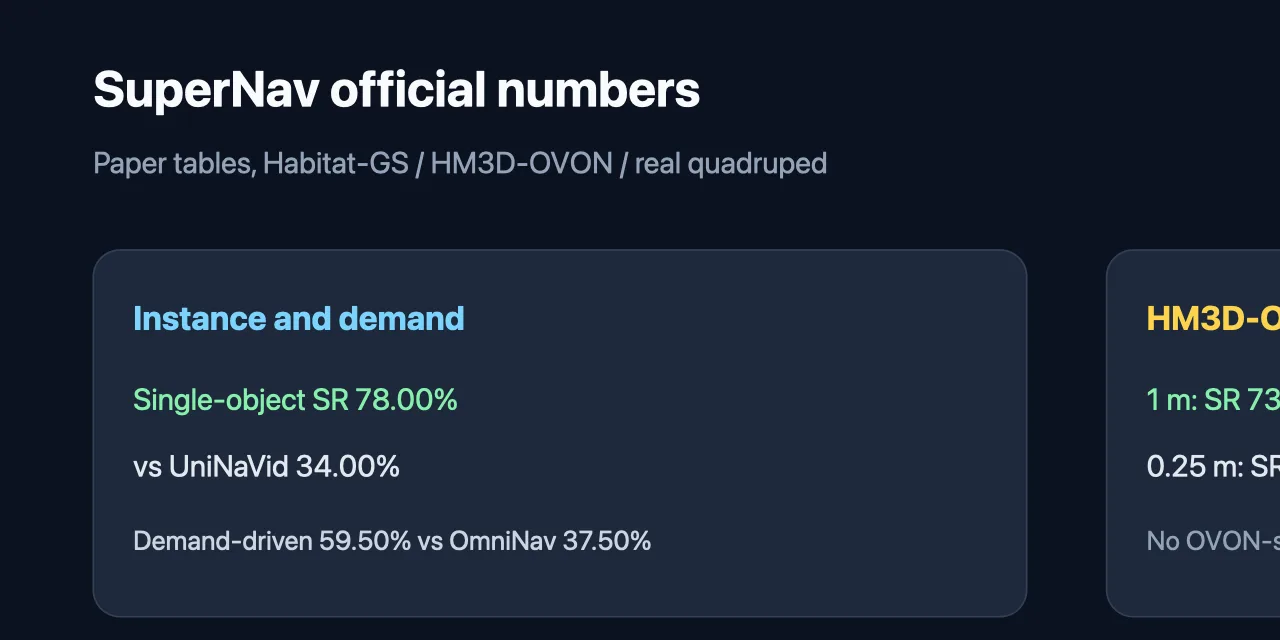
类别级导航在 HM3Dv2 和 HM3D-OVON。120 条 HM3D-OVON val-unseen、1 米阈值下,成功率 73.33%,路径加权成功率 SPL 0.4105;0.25 米阈值下 68.33% / 0.3837。作者强调没有做 OVON 专项训练或适配。对照还包括 NaVid、StreamVLN 等保留原生输入的基线。换决策配置时,论文也试过 GPT-6 Astra medium,harness 保持完整。
真机段落写在 Unitree Go2 上:四目 RGB,激光雷达做几何执行。机器人会在堵住的通道改路、核验目标、在目标之间切换。图例是找篮球、找另一台 Go2,以及先去打印机再去垃圾桶。
它不是什么
SuperNav 不是又一个在导航数据上微过的视觉动作头。它把“理解请求和场景”留在通用多模态模型里,把“怎么迈步”交给可替换执行器。代价也写在局限里:语义判断仍绑在底层模型上,模型看错物体或说错完成条件,技能环救不回来。仓库快照没有列出清晰的许可证文件,接入前先自己核 license。数字全部来自论文表,不是第三方复现。
对做机器人策略或 embodied agent 的人,这篇更像一份 harness 说明书:技能、点选工具、进度管理,比再收集一轮导航微调数据更可迁移。对只做桌面 coding agent 的读者,价值在对照:冻结大模型加领域工具,这条路在房间里也被跑通了一次。