字节笔记本
2026年10月10日 · 约 3 分钟读完
长上下文压缩不该等问句到了再砍
长上下文一压,常见做法是等问句到了再按注意力砍缓存。问句还没来、后面会问什么也不知道时,这份预算很容易摊薄。这篇反过来:文档先预填一段代读文本,让模型自己出六条读者可能问的题,并用原文原句作答;再按键偏离度在每四千词块里钉锚点,扩到整句。方法写成阁楼式预演。论文号 2610.12133,2026-10-08 挂到 arXiv。本轮没有独立项目仓,实验跑在开源压缩套件里。数字以论文表为准,不是本轮复现。
留百分之五,大约能塞进二十份缓存
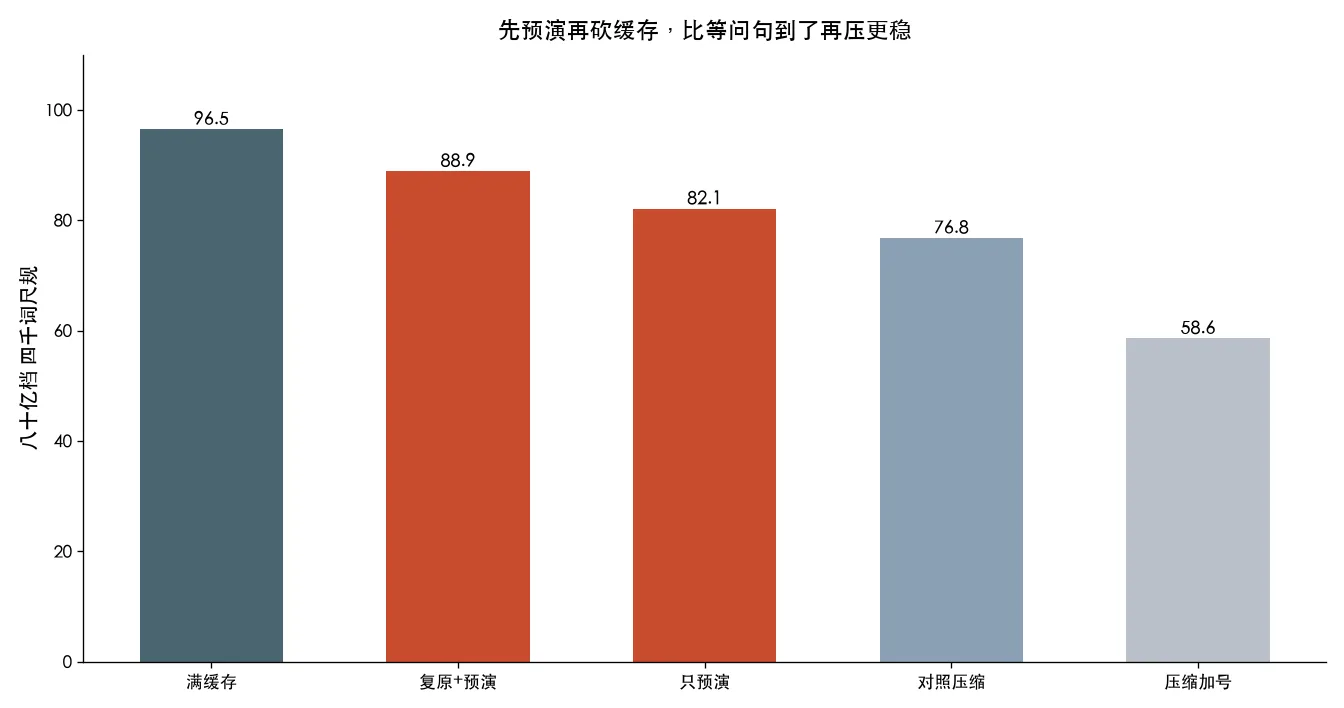
主实验留 5%。作者写成:同样内存里,留百分之五大约能放下二十份缓存;留百分之三十大约只有三倍。八十亿档四千词尺规上,满缓存 96.5,只预演 82.1,对照压缩 76.8,压缩加号 58.6;预演接到复原分数器到 88.9。同一档一万六千词是 75.1。留 3% 时预演 73.4,压缩加号 31.5,差距写成 41.9 个点。四十亿和一百四十亿档四千词分别 76.5 和 87.6。指令八亿档 77.2,满缓存 95.8。
十四项自然长文上,八十亿档满缓存 47.1,预演 40.6,对照 39.1,压缩加号 28.6,复原加预演 42.4。指令八亿档预演 39.3,满缓存 45.1。一页多问的短依赖,预演 36.2 / 18.6,复原加预演 40.9 / 20.7,满缓存 65.7 / 34.2;长依赖复原加预演 26.1 / 9.2,说明预演能站住,却补不回整篇重读。压缩一段文档大约 126.0 秒,接到复原分数器 142.5 秒,对照加号 154.8 秒;写六对问答最多二百五十六个词元,大约 11 秒,只做一次。
问句没到,就先让缓存把自己读一遍
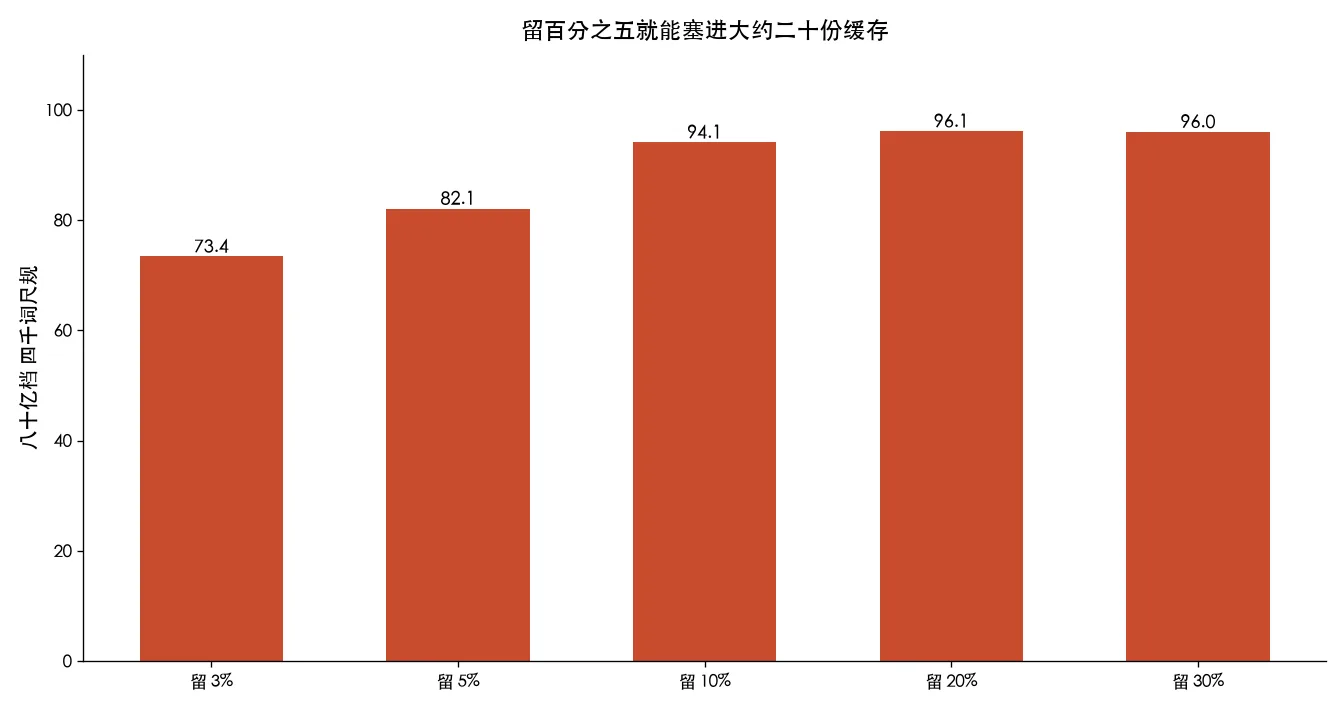
预演长度大约 0.42,对照 0.35,整篇重读是 1.00。每四千词一块,按键偏离度取该留下的位置,再扩到整句,预算跟着句子走,不是固定窗口。作者的判断是:整篇重读会把紧预算摊开,把事实挤出去;先代读、再按块钉锚,才知道该留哪一句。预算扫描上,留 3%、5%、10%、20%、30% 分别 73.4、82.1、94.1、96.1、96.0,过了百分之十就几乎贴满缓存。预演还可以接到别的分数器上:梯度加预演在四千词和一万六千词是 83.7 和 80.6。它不另训,问句到来之前就能压完,后面来多少问都共用这一次预演。
压缩套件本身大约一千二百星,协议 Apache-2.0,页上还没有挂这种预演名字。若你要的是可下载独立插件,这篇还不满足;若你要看问句没到该不该先砍缓存,数字都在 10-08 那一版里。本轮没有把作者花名册写进正文。