
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
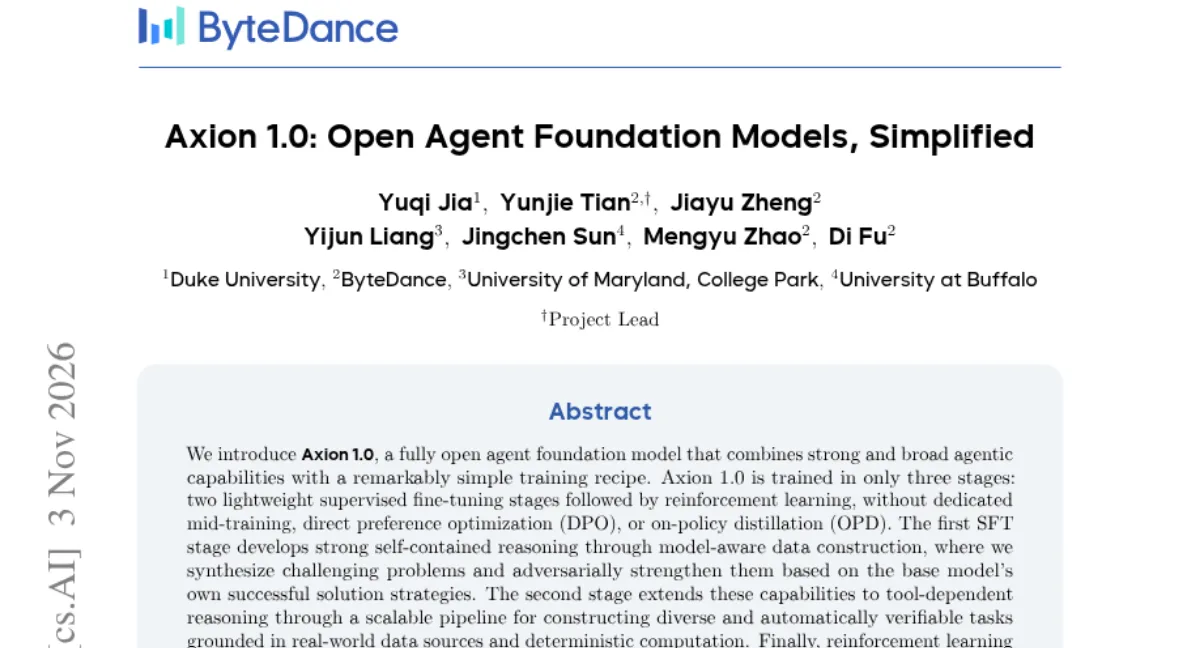
Axion 1.0 证明 agent 模型训练可以砍到三阶段
API中转
¥120
现代 agent 模型的训练流程已经卷成了流水线迷宫:mid-training、多阶段 SFT、DPO、偏好优化、在线策略蒸馏,一个环节都少不了。Axion 1.0(arXiv 2611.03233)问了一个得罪人的问题:这些复杂度里,有多少是真正必要的?答案是:砍到三阶段,两次轻量 SFT 加一轮 GRPO 强化学习,效果不降反升。
开源范围超出预期:不只模型权重,完整的配方全部开放,包括数据构建、生成、过滤、验证、提示词与训练代码。数据管线分两条:自包含推理以公开题目为种子合成难题,基座答对的题用四种变换针对性加强,参考答案要 GPT-5.5 独立求解三次一致才接受;工具依赖推理则基于结构化公开数据,用确定性流程生成,构建时数据库不对模型开放,闭卷能答对的题直接剔除。
成绩按论文口径:122B 版在 FrontierScience Research 拿 66.7%,超过 GPT-5.6 Sol 的 63.3%;35B 版对比同规模的 Agents-A1,HLE 高 4.6 个百分点、SEAL-0 高 5.8、FrontierScience Olympiad 高 7.0。最惊人的是成本:122B 两阶段 SFT 共 7.5 小时、240 GPU 小时。消融也诚实:SFT 贡献了主要增益,RL 再往上顶。
对被 agent 训练流程复杂度劝退的团队,这篇是一剂解毒剂:先把流程砍到最简,再证明每一环的必要性,而不是反过来把所有流行模块都堆上去。跨来源基线比较是「指示性而非严格受控」的,作者自己标注了,读的时候记得带上这副眼镜。
相关文章

分享: