
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
基准压缩的长尾风险:BestRand 把它砍掉一半
API中转
¥120
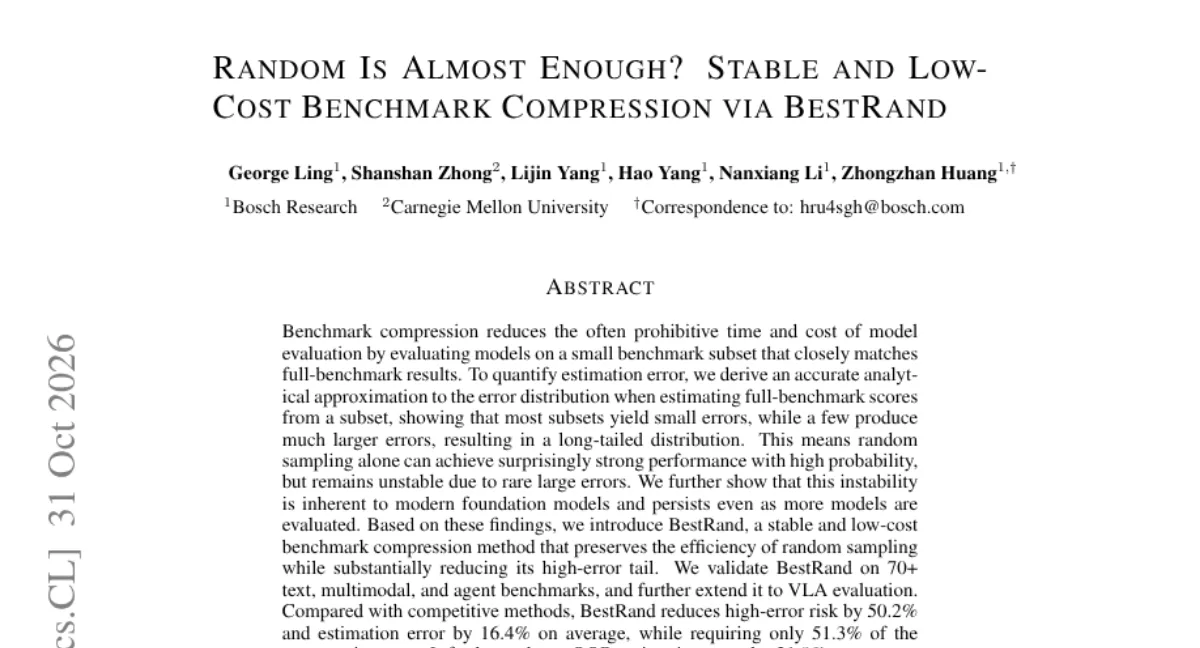
评测太贵,业内通行解法是基准压缩:用一个随机小子集近似全基准。但 CMU 团队的 BestRand(arXiv 2611.00883)指出这种做法有个被忽视的软肋:压缩误差呈长尾分布,大多数子集误差很小,少数子集会出大错,而且这种不稳定性是现代基础模型固有的,评测模型越多也甩不掉。
BestRand 保留随机采样的高效性,同时大幅削减高误差尾部。论文还顺手做了理论贡献:推导出子集估计全基准分数时误差分布的精确解析近似,压缩精度和可靠性从此有公式可预测。方法已扩展到 VLA(视觉语言动作)评测,正好接上机器人评测越来越贵的需求。
数字按论文口径:在 70 多个文本、多模态与 Agent 基准上验证,高误差风险降低 50.2%,平均估计误差降低 16.4%,构建成本只有竞争方法的 51.3%;分布外(分数区间、模型家族、时间偏移三种偏移)估计误差平均降低 21.8%。
这个工作看着冷门,其实踩在行业的一个真实痛点上:模型评测的成本已经高到「每次发版全量跑分」变得不现实,谁能用 5% 的题目稳定估计 100% 的榜单,谁就在省真金白银;而「稳定」比「平均更准」更重要,长尾大误差意味着你的回归测试可能某天突然给出荒谬结论。做模型评测基础设施的团队,这篇的解析近似方法值得一读。两个延伸方向也值得留意:其一,方法已扩展到 VLA(视觉语言动作)评测,机器人领域「每次微调全量重测」的贵账单同样适用;其二,论文附带误差分布的解析近似,意味着可以按目标精度反推需要多大的子集,评测预算从「拍脑袋」变成了「算出来」。代码与数据已开源(George-Ling3/BestRand)。
相关文章

分享: