字节笔记本
2026年10月9日 · 约 7 分钟读完
三步把文本搭成能动手拼的积木
编码 agent 现在很会写脚本,但让它按一句描述搭一套能动手拼的积木,事情就不一样了。零件目录是死的,连接要咬合,重力还不能把墙推倒。斯坦福、马克斯普朗克智能系统研究所和 Inria 的一组作者在 2026-10-08 放出 BrickBench,论文号 2610.12452,科目挂在人工智能、视觉和图形。作者是 Peter Kulits、Yiqing Xu、R. Kenny Jones、Cordelia Schmid、Jiajun Wu。配套环境叫 BrickAgent,MIT 许可,PyPI 包名 brickagent,0.1.0 写在 10-08,项目页在 brickben.ch。本轮仓库页看到 5 星、一次提交,热度在论文和画廊,不在星数。
先分清三套约束
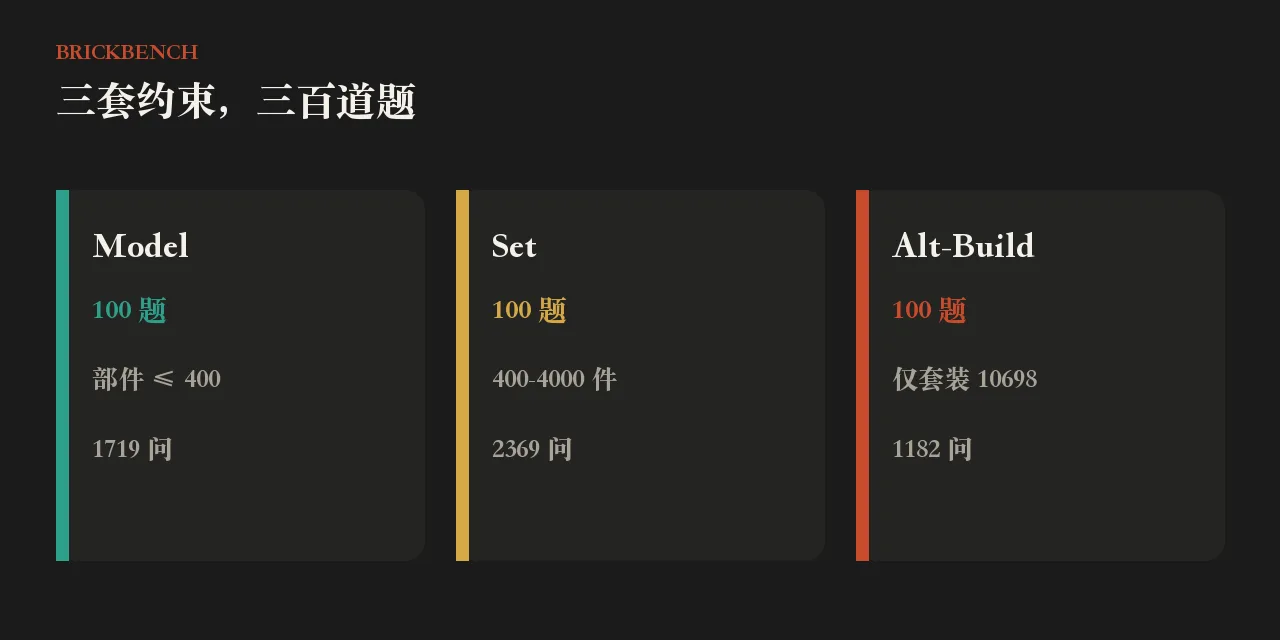
一共 300 道文本题,十个主题各十道,主题对齐 BrickLink Designer Program:中世纪城堡、载具、火车、科幻、器物、建筑、花草、动物、海盗、历史。三种约束不要混着看。
Model:最多 400 件,多为单件主体,附 1719 道是非问。Set:400 到 4000 件,按零售套装体量写,附 2369 问。Alt-Build:只准用零售套装 10698 的 783 件库存,附 1182 问。任务落在 benchmark 目录的 tasks.json,问句做成依赖图,实体、属性和关系分开,前面那题答否,后面的关系题不算过。项目页把着火房间里那条狗拆成一张问句图:先有没有狗,再问是不是棕色、耳朵软不软、帽子什么颜色、爪子有没有搁在桌面上、火是不是顺着窗帘爬。箭头表示依赖,点一下能顺着追。
旧评测 BrickNet 只看到最多 100 件的小物件。把 GPT-5.6 Luna 丢进他们的环境,在 BrickNet 验证集上 PE 0.313、SigLIP 2 为 0.818、VQAScore 0.732,对照真值 0.315 / 0.826 / 0.748,三项都在 0.02 以内。同表里 BrickGPT 是 0.157 / 0.052 / 0.050,BrickNet-14B 是 0.283 / 0.625 / 0.602,中间几档 0.6B 到 8B 也都低于 Luna。作者的判断是:旧题已经被通用 agent 摸到天花板,该换一套更接近零售套装的题。
三步把环境跑起来
第一步装包。文档写的是 pip install brickagent,再执行 python -m bricknet fetch-meshes,凸包碰撞网格大约 1 GB,也可以把数据目录指到自己的路径。渲染还要 Node、Mesa 和 LDraw 零件,缺了只能验结构、看不了八视图。Python 要求写成 3.10 及以上。
第二步用接口搭,而不是手写坐标散文。核心是 Assembly,用 add 和 attach 按位姿或连接器放零件。find、describe、name、connectors、view 用来看现场。check 会在碰撞、连接不合、库存超用或不稳定时直接失败,稳定性格是 PyBullet。环境变量可以按套装卡住零件编号、颜色和数量。写完可以 write(..., check=True) 落成 LDraw 的 mpd。连接走的是 BrickNet 那套插座,不是自由漂浮的方块。
第三步再交给评测脚本,不要自己目测过关。verify.py 会重放 build.py,查件数、碰撞和稳定。通过之后渲染八个视角,用 Gemma 4 31B 按问题图做视觉问答,依赖边必须先成立。提示对齐和外观再做成成对比较,用 Bradley-Terry 拟出 Align ELO、Design ELO 和平均 ELO。提交是每个题号一份不超过 10 MB 的 zip,里面放 build.py 或 model.mpd。本轮没有代跑全榜,也没有改他们的裁判模型。
合法和像人,不是同一件事
作者测了十一家前沿 agent 和两套只适用于 Model 档的数据基线。五家在全部提示上给出合法装配。VQA 分得不狠,Design ELO 分得更开。GPT-6.1 Sol 的 ELO 能跟上 GPT-6 Astra,花费大约是对方的五分之一。Design ELO 和人类对九个参考系统的外观判断,在 36 对里有 34 对同序,Kendall τ 写成 0.89。
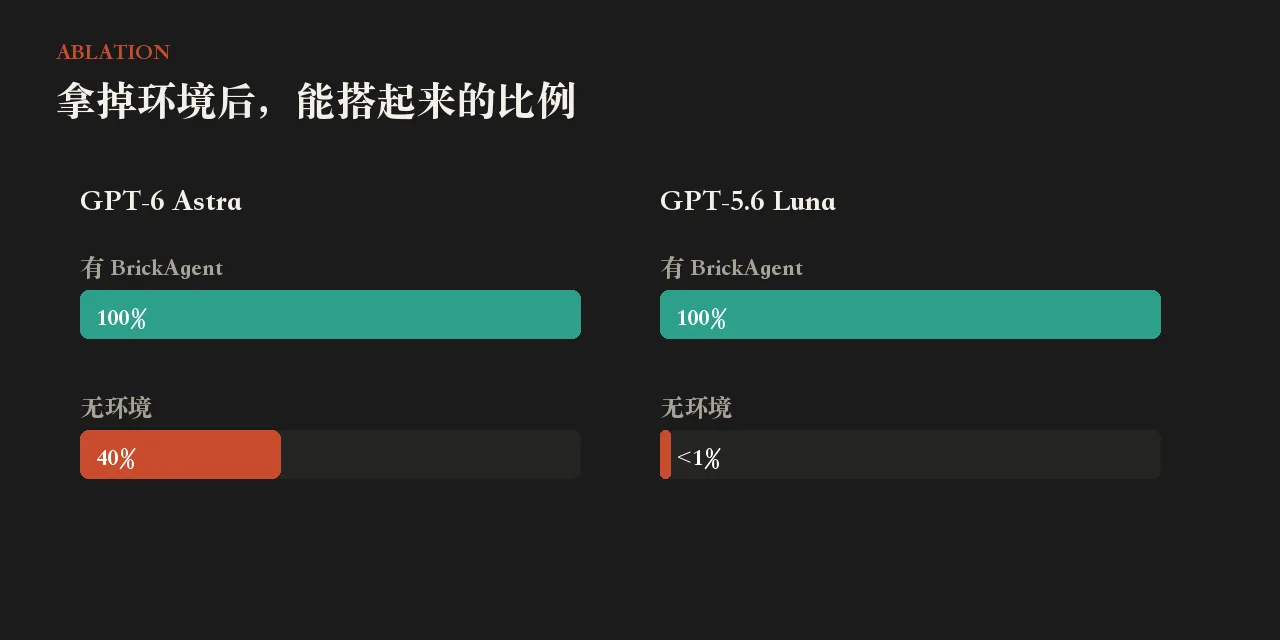
拆掉 BrickAgent、只留 LDraw 和格式说明时,数字很难看。三百题合计,GPT-6 Astra 合法率从 1.00 掉到 0.40,碰撞从 0 升到 7.19,连通块从 2.21 升到 6.12;VQA 0.954 对 0.940,ELO 1297±22 对 1309±24。GPT-5.6 Luna 合法率从 1.00 掉到不到 0.01,碰撞 155.51,连通块 83.00;VQA 0.792 对 0.813,ELO 898±16 对 960±20。作者的原话是:阿斯特拉还能保住四成,Luna 大约三百题里一题。对齐和外观不一定掉,因为不再要求能拼,模型可以画一张拼不起来的图。
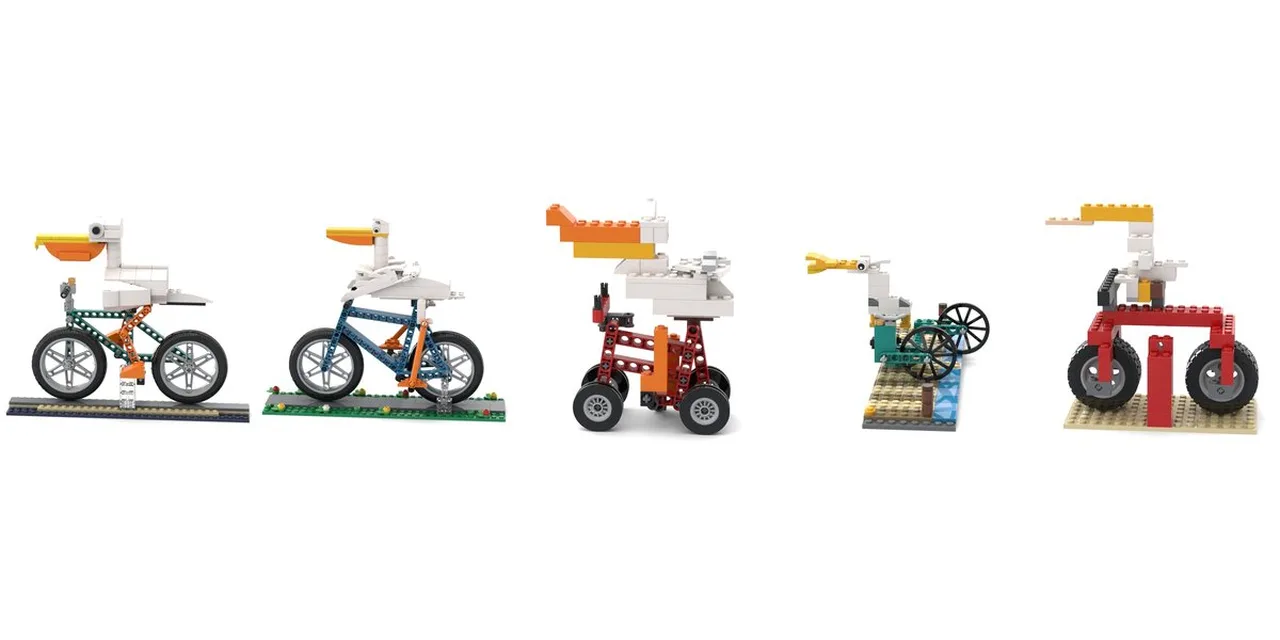
画廊里的例子把差距摊开。Model 档有骑车的鹈鹕、掀盖的垃圾箱、墙上钉红线的邮件角。Set 档有着火房间里端坐的狗、穿墙的巨型玩具火车、餐厅里对着白猫指认的场景。Alt-Build 要在固定库存里挤出海蛇和海盗船、骑士对蜗牛。点开 gallery.brickben.ch 能转一圈看连接,不靠宣传截图。页面还把十一家的搭建并排放,名字包括 Claude Opus 5.5、Claude Opus 5、Qwen 3.8 Flash、Gemini 3.8 Flash、DeepSeek V4.1 Flash、Muse Spark 1.3、GLM 5.3 Flash。完整分表在项目页,交互表本轮不抄未展开的格子。
人类积木图灵测试里,真设计始终被更看好,agent 最多糊弄两成评委。论文摘要写得很干:能核对的物理和语义大多过了,离人的设计还有一段。成本栏按每次装配的标价 token 计美元,排名并不跟价格走。
若要复现,先把网格拉下来,用 check 卡死碰撞和库存,再把八视图和问题图交给同一套脚本。合法只是入场券。零件怎么省、比例怎么收、细节往哪堆,才是这张新榜还空着的位置。