字节笔记本
2026年10月9日 · 约 3 分钟读完
判定不该再让大模型先铺一段理由
路由、验签、拦 agent 下一步,这些事以前常塞给会聊天的大模型。模型先铺一段理由,再吐选项,一串判定叠下去,工作流就慢了。微软 2026-10-09 在 Command Line 博文里放出 Microsoft-Decision-1:后训练自 Qwen3.5-9B,只对固定选项给校准概率,走结构化接口。Foundry 目录已经能点,OpenRouter 写成即将上线。输入百万 token 报价 0.042 美元,输出免费。这些是公告口径,不是本轮复现。
三十六套盲测,官方只报倍数
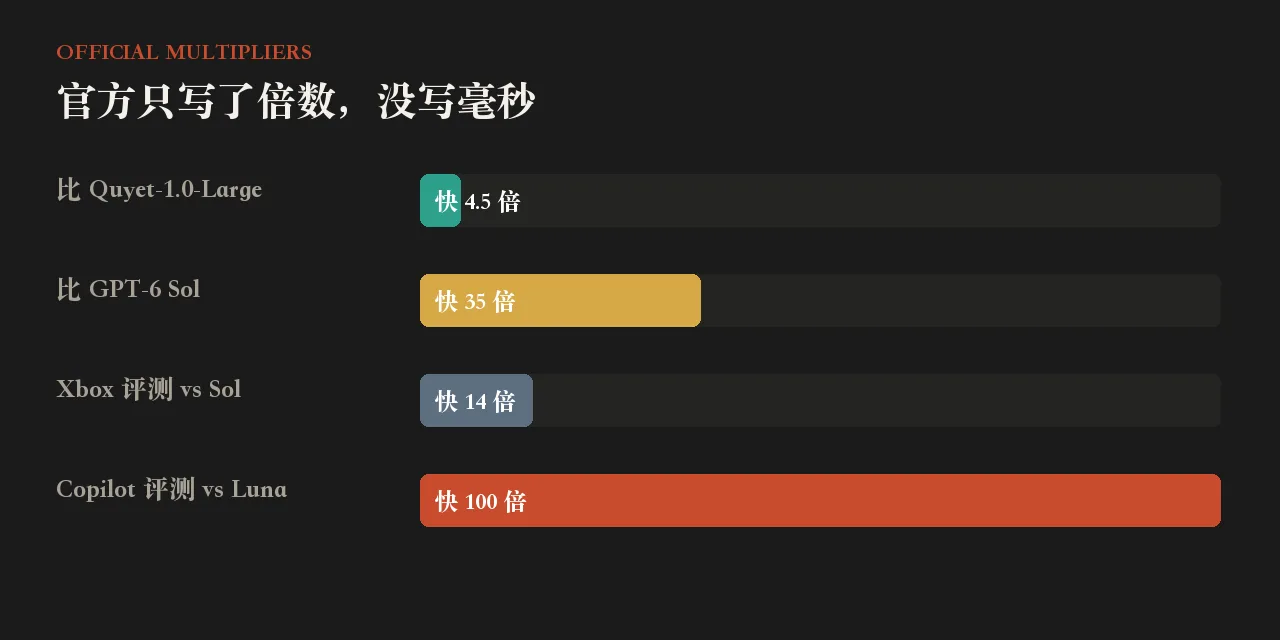
博文说这套对比覆盖近十五万题,训练时没见过。Microsoft-Decision-1 在他们的三十六套里准确率最高,测速也最快:比第二名 Quyet-1.0-Large 快 4.5 倍,比 GPT-6 Sol 快 35 倍。另一处又写 P50 大约是 GPT-6 Sol 的三十五分之一。页面上的交互图会动,本轮只采静态正文,不把未写进段落的毫秒数当成已核事实。
它要解决的不是写长文。博文举了个账:二十步判定,每步多一百毫秒,整条链就多两秒。选项集固定时,接口直接给每个选项的校准概率,覆盖是否题、选择题、打分,以及按量表给模型回复和 agent 动作打分。应用拿置信度决定执行、挂起还是人工看,而不是再解析一段散文。
稳不稳,比准不准更先问
他们用八种扰动改同一条请求,看判定会不会翻。官方数字是平均 1.3% 会变;选项说明改写、顺序对调或打乱时,翻转为零。安全侧写了 5250 条请求、十一套基准,覆盖有害内容、越狱和提示注入,口径是拦住有害、少误伤无害。校准被单独列为产品能力:概率会进接口,九成把握就该在代表性样本上对大约九成。
对照名单点了 Quyet-1.0-Large、Surogate Rune 26B-A4B、GPT-6 Luna Decisions、deck-31B、H2O-Lightning-4B、Strands-Decider 2B。博文说还把 JevBench 上靠前的公开模型拉到另外三十六套里比。这些名字以公告链接为准,本轮没有重跑榜。
内部试用写得很满
Xbox Research 把一万多条问卷、STEAM 和社交反馈归到研究员定好的主题,称质量和 GPT-6 Sol 接近,速度快十四倍,费用低两百倍。Copilot 团队拿它评聊天和 agent 回复,称和 GPT-5.6 Luna 接近,快一百倍。值班检索称比大模型更好更快。Microsoft Discovery 的自适应重规划称一致性是大模型打分的四十六倍,速度三倍,整段重规划接近四倍。这些全是内部自报。
建议场景写成 agent 闸门、模型路由、技能规则、数据标注、AI 评判、意图、事故分级、输入校验、推荐、搜索相关性、内容过滤、代码扫描、安全筛查、界面下一步和科学筛选。底座计划再接到微软自研和 OpenAI 模型上。Hacker News 讨论帖到本轮抓取时 92 分、33 条评论。页面作者字段写成 Lisa Brown Jaloza,正文还出现 CTO 办公室的 Achint Srivastava。
对已经在用判定接口的人,值得看的是延迟和报价,不是又一个会聊天的九十亿参数模型。站点此前写过边缘侧一次前向的判定路线,这篇是同一类需求的云端目录版,数字以微软 10-09 公告为准。