字节笔记本
2026年10月10日 · 约 2 分钟读完
裁判一致率拉满,也不该只信准确率
大模型当裁判时,温度零也会改口,对调顺序还能把难题翻掉。只报准确率,会把这些格当成稳定。这篇论文把一致、翻转、准确合成一项可信度,用来看哪一格真能信。论文号 2610.12083,2026-10-08 挂到 arXiv。本轮仓库页搜不到公开代码,数字以论文表为准,不是本轮复现。
同一格要重复,对调也要算
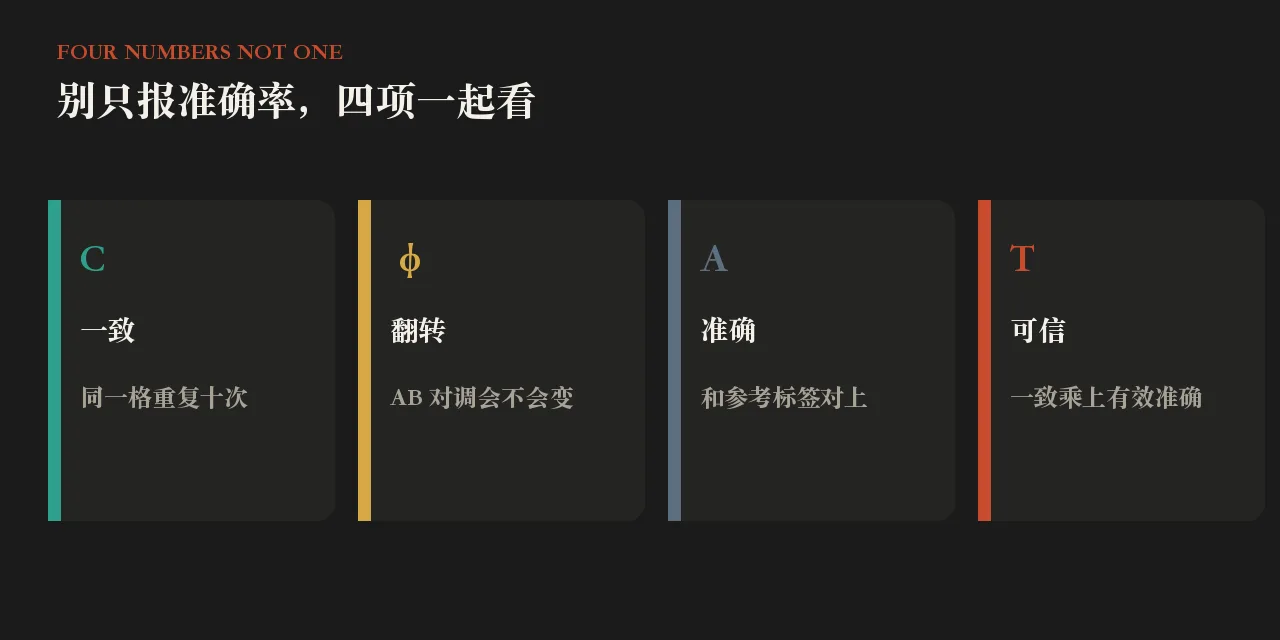
作者测六个裁判、四套题、五种成对格式、两种顺序、十次重复。温度零全测;其中四个非推理模型再加 0.5 和 1.0。另两套范式是分项打分和一条里打多项。每套题一百对。一致率看同一格重复稳不稳,翻转率看 AB 对调变不变,准确率看和参考标签对不对。可信度是一致率乘上有效准确,强制二选一时有效准确再减去翻转率的一半。格式跨度看同一模型在五种格式里最高和最低可信度差多少。
重复相同设置,裁决会变 7% 到 17%。对调顺序,翻转最高到 98%。方差分析里,裁判乘数据集占 28.1%,裁判 27.0%,数据集 26.2%。温度从零到 1.0,平均一致率掉 12.1 个百分点,有效准确几乎不动。接口花费大约两千一百美元。论文只覆盖英文四套题,封闭模型没有对数概率,也不做列表式多模型打分。
一致率拉满,可信度还能只剩两个点
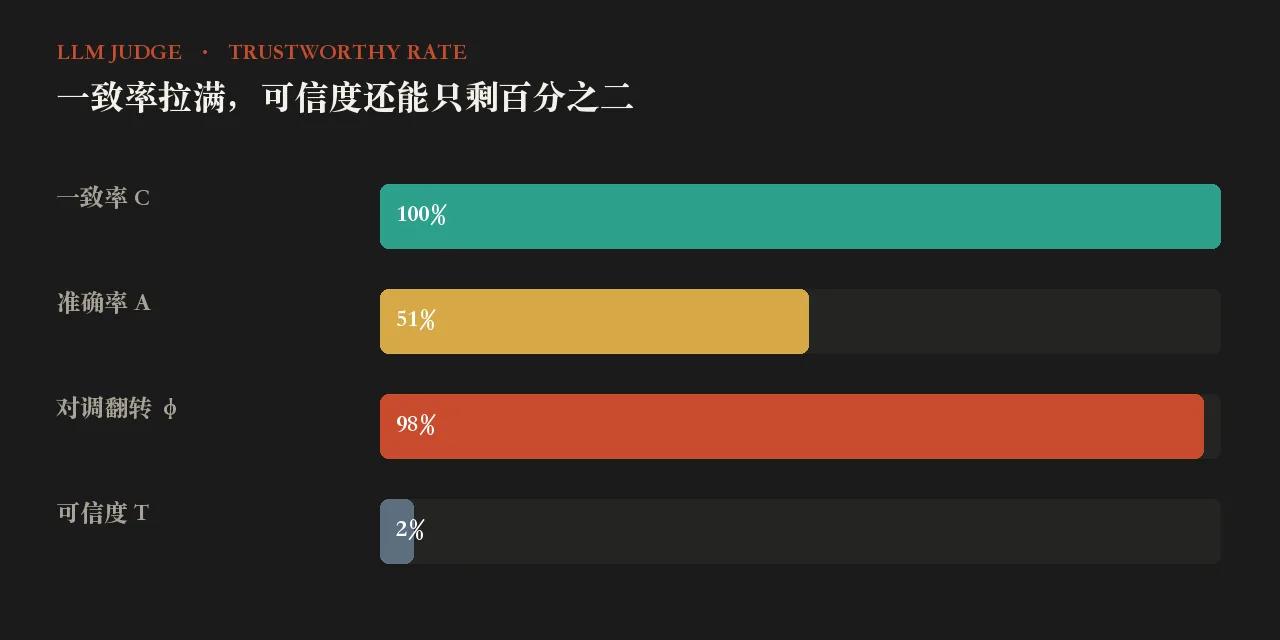
有一格写成:一致率 100%,准确率 51.0%,对调翻转 98.0%,可信度 2.0%。这格是快速判定模型、先给裁决的标记格式、偏难的那套题。另一家推理模型在分项打分范式上,同一套题可信度能到 77.9%。成对格式里,另一家模型在另一套题上可信度 81.0%。作者的结论很硬:按准确率挑裁判会看错,单侧顺序本身就不完整。
格式跨度也差得开。有的模型平均只有 4.8 个百分点,有的平均 24.9。偏难题上,格式跨度均值 22.7 个百分点。分项打分往往把一致率打穿:有的模型从成对直出的 86.0 掉到 34.8。温度拉高后,有的直出格一致率掉到 58.6,可信度只剩 22.2。论文建议每格都报四项,用可信度而不是准确率选裁判。
没有公开仓,就没法按安装步骤复现。若你要的是可下载评测包,这篇还不满足;若你要看一致率拉满为什么仍不能当稳定裁判,数字都在 10-08 那一版里。本轮没有把作者花名册写进正文,也不补未展开的格。