字节笔记本
2026年10月10日 · 约 3 分钟读完
SQL 智能体凭什么要在套件里训
静态把问题映射成一条 SQL,上线却要连查表、看结构、执行、再提交。HarnessSQL 把这套套件当成训练场,而不是测完再补。论文号 2610.12274,2026-10-08 挂到 arXiv。公开仓本轮一星,许可页没写死,论文写成知识共享署名 4.0。数字以论文表为准,不是本轮复现。
先把沙箱和工具钉死
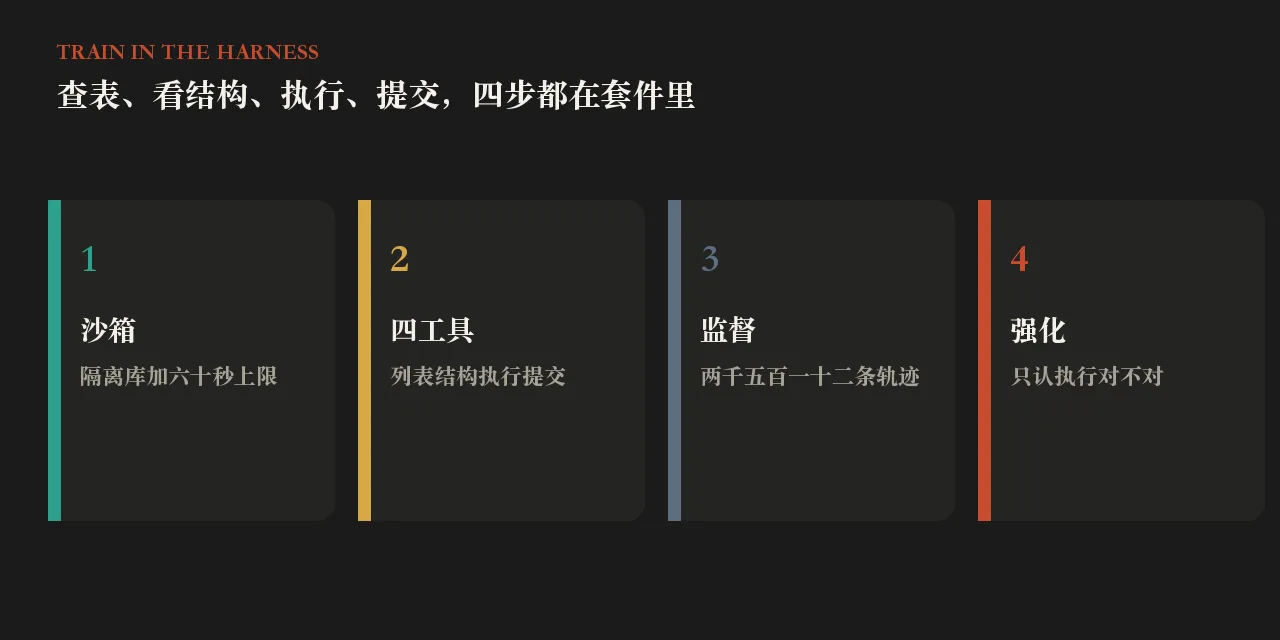
作者把交互式文本转 SQL 写成部分可观察过程。奖励是结果对不对,再乘上协议有没有守住。环境是隔离库、隐藏对照、六十秒子进程上限、只读闸。套件只有四件工具:列表面、看结构、执行、提交。老师先在同一套件里滚出轨迹,再筛出两千五百一十二条、七十九个库,做整段监督,观察字段不进损失。强化学习用执行对错当二元奖励,两千七百条提示加一百条验证。主强化算法不另加熵或散度项。
监督语料均值大约一万一千八百 token,中位十六轮、十七次工具、十三点九一次执行。中间至少失败过一次的轨迹占 77.83%。老师一次命中 71.20%,三次 83.61%。泄露检查写成题目和执行结果零重叠。安装写成 Python 3.10 以上,再进套件目录装前端依赖。强化要另开一套训练仓。生成物和凭据不进仓。
小模型在套件里训,比大编码模型更会走协议
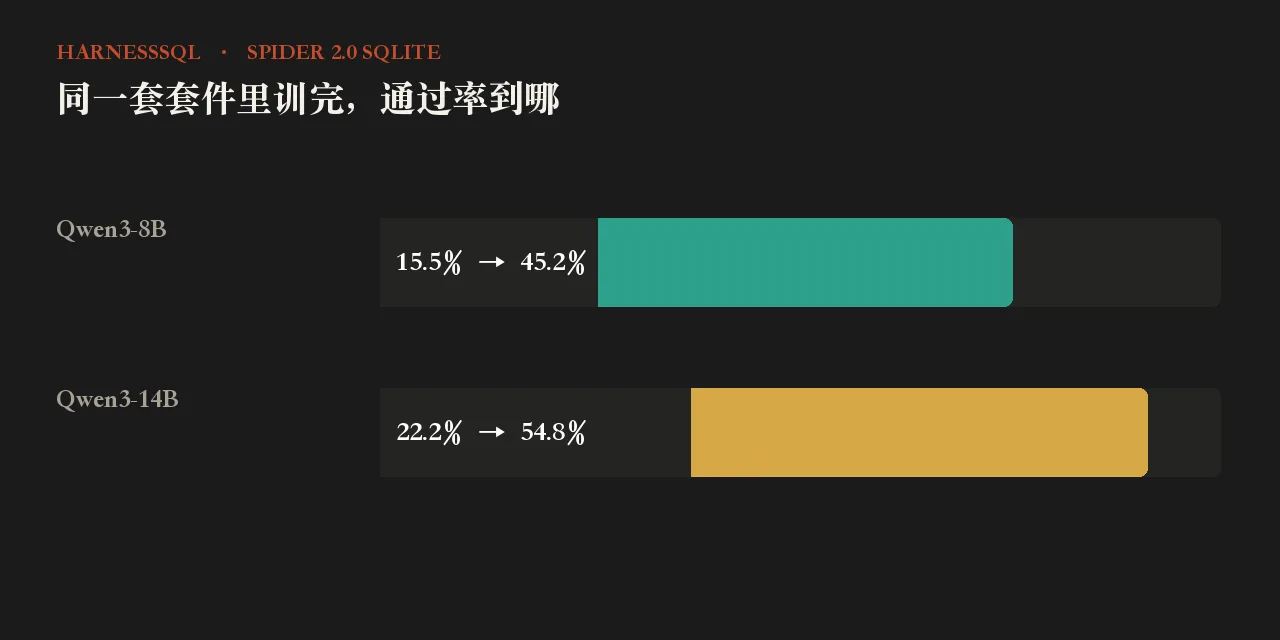
Spider 2.0 的 SQLite 切面上,八亿参数从 15.5% 到 45.2%,十四亿从 22.2% 到 54.8%。只做监督是 30.4% 和 37.8%。直接强化八亿只有 20.0%。监督加强化再抬 14.8 和 17.0 个百分点。域外两套:交互迷你集 9.0% 和 11.3%,在线基准精简集 24.8% 和 28.5%。对照三十二亿编码模型和三十二亿文本转 SQL 模型,在同一原生协议上只有一成六左右。
消融很直白。不训套件、也不用这四件工具,只有 2.2%。换到四件工具但不在套件里训,会掉到 9.6%。套件里训完再测,监督阶段就能到 30.4%。上下文从八千到三万二千,通过率 27.4% 到 45.2%。一千条轨迹的对照里,更强老师配同一套件,能到 23.0%。五百四十次滚动里,非法调用从 67.41% 降到 0.56%,协议违规从 83.15% 降到 11.48%。
论文承认主要是 SQLite。其他方言对小模型更弱,还和长程客户端、句法差搅在一起。公开仓几乎没有星,也没有现成权重。若你要的是可下载检查点,这篇还不满足;若你要看同一套件里训会不会把协议走顺,数字都在 10-08 那一版里。本轮没有把作者花名册写进正文。