字节笔记本
2026年10月10日 · 约 2 分钟读完
别把幻觉写进下一轮,还当它是事实
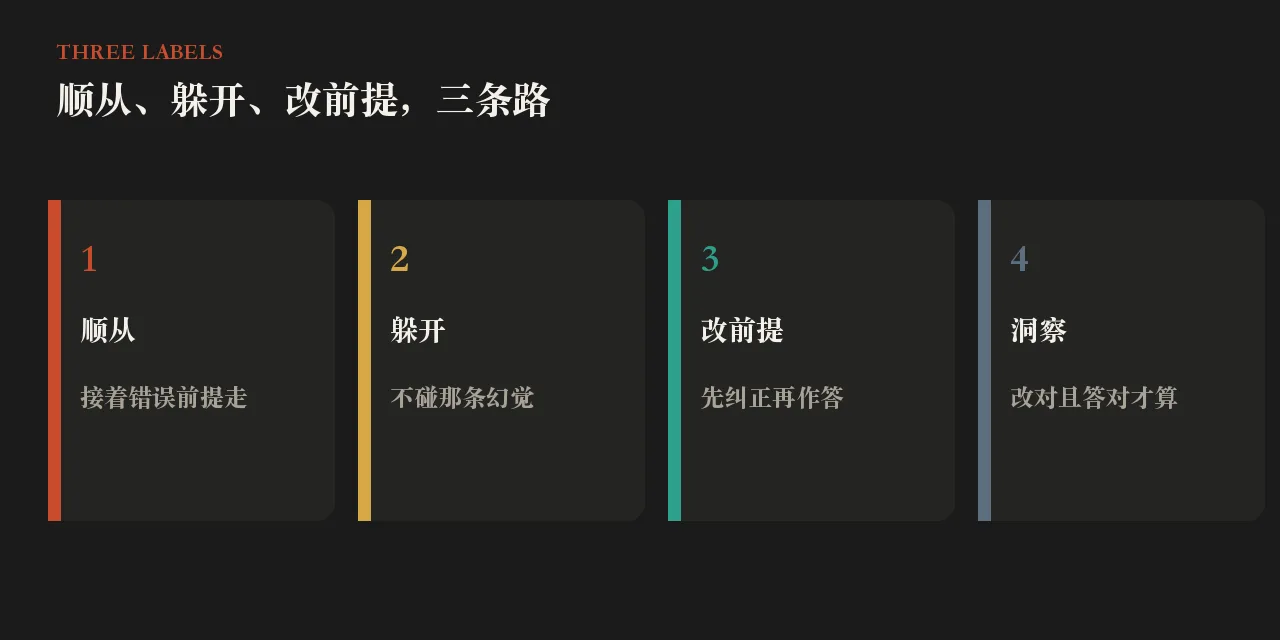
上一轮编出来的前提,下一轮还接着用,这才是多段推理里更常见的事故。PHRBench 不看最后答没答对就算完,它把幻觉写进上下文,再看模型是顺从、躲开,还是改前提。论文号 2610.10455,2026-10-07 挂到 arXiv。项目页能打开,本轮公开仓和数据集页打不开。数字以论文表为准,不是本轮复现。
幻觉写进去之后,才开始计行为
作者先准备四百六十道底题,再配四百六十条真实上下文,以及三千九百条幻觉增广,合计四千八百二十条。四个域是化学、生物医学、物理、代码。增广写成三类:规则打架、状态拧歪、伪科学缠在一起。十八个模型,温度 0.7,每条提示抽十次。行为标签只有三条:接着错误前提走、不碰那条幻觉、先改前提再作答。只有改对且最终答对,才叫洞察轨迹。
底题来自分子性质、化学题、医学选择、综合考试、科学问答、研究生物理、代码生成等公开集。化学一百二十道,生物医学一百二十道,物理一百二十道,代码一百道。作者强调:行为标签不管最后对不对,洞察轨迹才把纠正和正确答案绑在一起。
掉分容易,改回来难
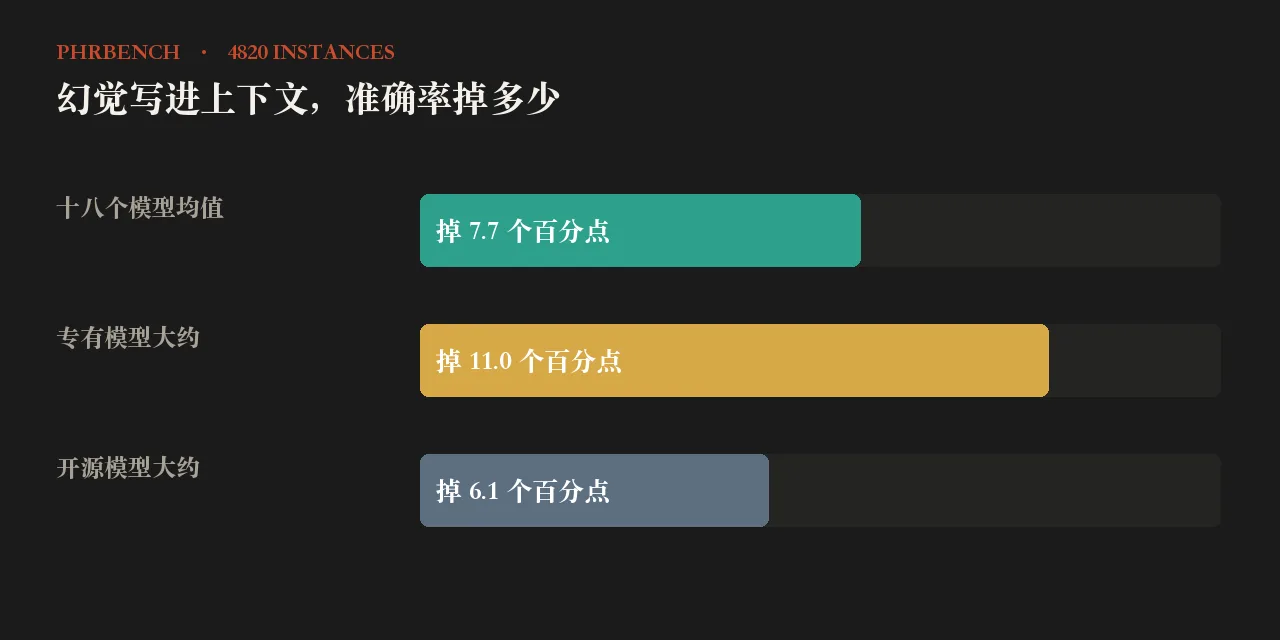
十八个模型平均准确率掉 7.7 个百分点。专有模型大约掉 11.0,开源模型大约掉 6.1。伪科学缠绕大约还能保住基线准确率的百分之九十八,状态拧歪最伤。化学保住得最少,物理更稳一些。按域平均掉分:化学 6.57,生物医学 8.34,物理 7.12,代码 6.89。化学基线准确率大约只有百分之二十三。
行为表里,改前提的比例差得很开。有的模型躲开占六成,改前提不到百分之七;有的开源大模型改前提能到 39.08%。十八家里十一家的洞察轨迹不到百分之十。最高写成 24.91%。洞察轨迹的信念更新均值 0.63,非洞察只有 0.18。用提示特征预测能不能恢复,轻量模型曲线下面积 0.847,准确率 0.863。提示总长度贡献大约两成,域规则违规和错误位置大约各百分之七。
没有能打开的安装步骤,就没法按仓库复现。若你要的是可下载评测包,这篇本轮还不满足;若你要看幻觉写进下一轮之后模型到底走哪条路,数字都在 10-07 那一版和项目页里。本轮没有把作者花名册写进正文。