字节笔记本
2026年10月10日 · 约 2 分钟读完
程序进化不该把每次提案都跑满评
大模型搜程序时,默认把每个提案跑完全评,预算很快烧光。EvoAlloc 把分配器自己也放进进化环:先决定满评、部分评还是丢掉,再用结果改策略。论文号 2610.12086,2026-10-08 挂到 arXiv。本轮仓库页搜不到公开代码,论文写接受后再放。数字以论文表为准,不是本轮复现。
分配器也该自己长
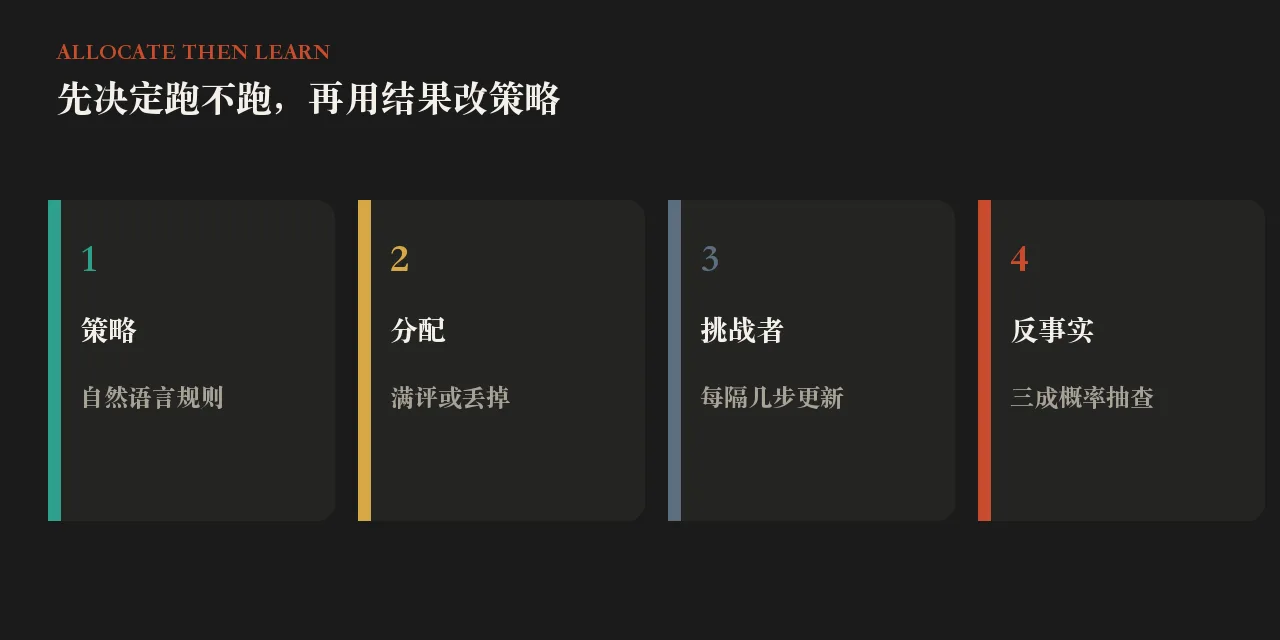
它嵌在现成的程序进化框架里。自然语言策略加蒸馏过的经验,驱动一个编码模型做分配。动作是满评或丢掉;其中一套基准还允许先部分评再决定继续还是停。每积累五次新的满评结果更新经验,每十次更新策略。挑战者要在两次分歧上通过,词典序先看少漏掉多少新最优,再看少跑多少满评。三成概率会把丢掉或停掉的候选再抽去满评,用来补反事实。预热至少要各有一条新最优和一条非新最优。经验槽写成四条在用、四条过期。提案器三家,温度三档,满评预算一套七十五、一套一百五十,五个随机种子。
对照是跑满所有提案、同模型但不进化策略、谱系置信上界,以及十五候选淘汰赛。作者强调:分配器花的 token 要单独记账,不能只报终点分。
少跑很多满评,终点分还能更高
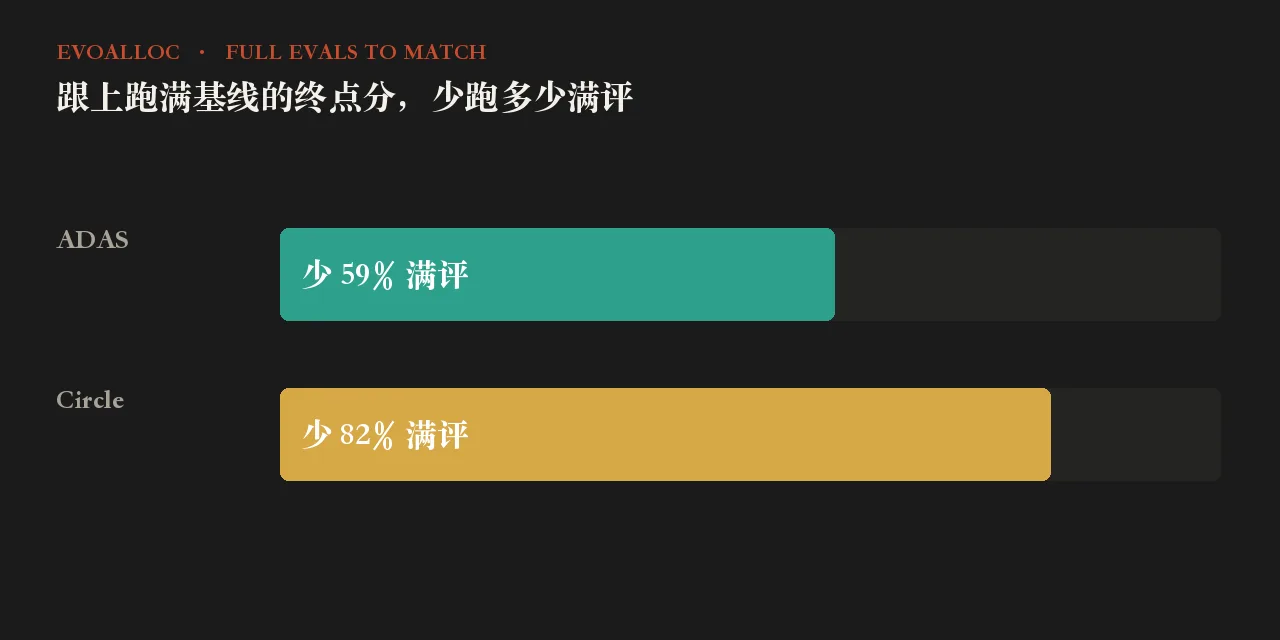
跟上跑满基线的终点分,完整方法少 59% 到 82% 的满评,少 61% 到 89% 的模型 token。同一满评预算下,终点分相对抬 8.7% 到 12.0%。一套基准的终点分从 35.33 到 39.56,另一套从 2.343 到 2.547。第一次摸到基线终点分,一套从六十九次满评降到二十八次,token 从约八千九百八十万降到三千五百三十万;另一套从一百四十八次降到二十六次,token 从约六百一十万降到七十万。
抽查池里,一套一百三十二次探索里有六次摸到新最优,三十三次比父代更好;另一套二百九十六次里二十二次新最优,九十一次更好。反事实概率扫过零到七成,三成这一档到目标最便宜。随机丢掉一半,终点分明显低于完整方法。论文只覆盖两套基准、同一次搜索,生成器和评估器都不一起进化。没有公开仓,就没法按安装步骤复现。若你要的是可下载分配器,这篇还不满足;若你要看少跑满评会不会把终点分一起抬上去,数字都在 10-08 那一版里。本轮没有把作者花名册写进正文。