字节笔记本
2026年10月10日 · 约 3 分钟读完
答对了,凭什么不等于会认不确定
检索到的证据和模型脑子里的旧印象打架时,智能体是改口、认不确定,还是硬撑到最后一轮?现有评测多半只报任务有没有做成。这篇把认识上的谦逊拆成识别、解决、上交三条轨迹,看知识冲突里这三条会不会跟上准确率一起走。论文号 2610.12360,2026-10-08 挂到 arXiv,标注 EMNLP 2026 相机就绪。本轮没有项目仓。数字以论文表为准,不是本轮复现。
四套套件,受控冲突和自然冲突分开看
作者写了四套智能体:编排器加八十亿参的工具编排、一套主流编码套件配中档对话模型、一套开源执行套件配旗舰对话模型,以及九十亿和二百七十亿两档的代理骨架。受控冲突用矛盾问答和维基对打;自然冲突跟在多步执行里,配了 GAIA、MoNaCo、BrowseComp,每组都有无冲突对照。
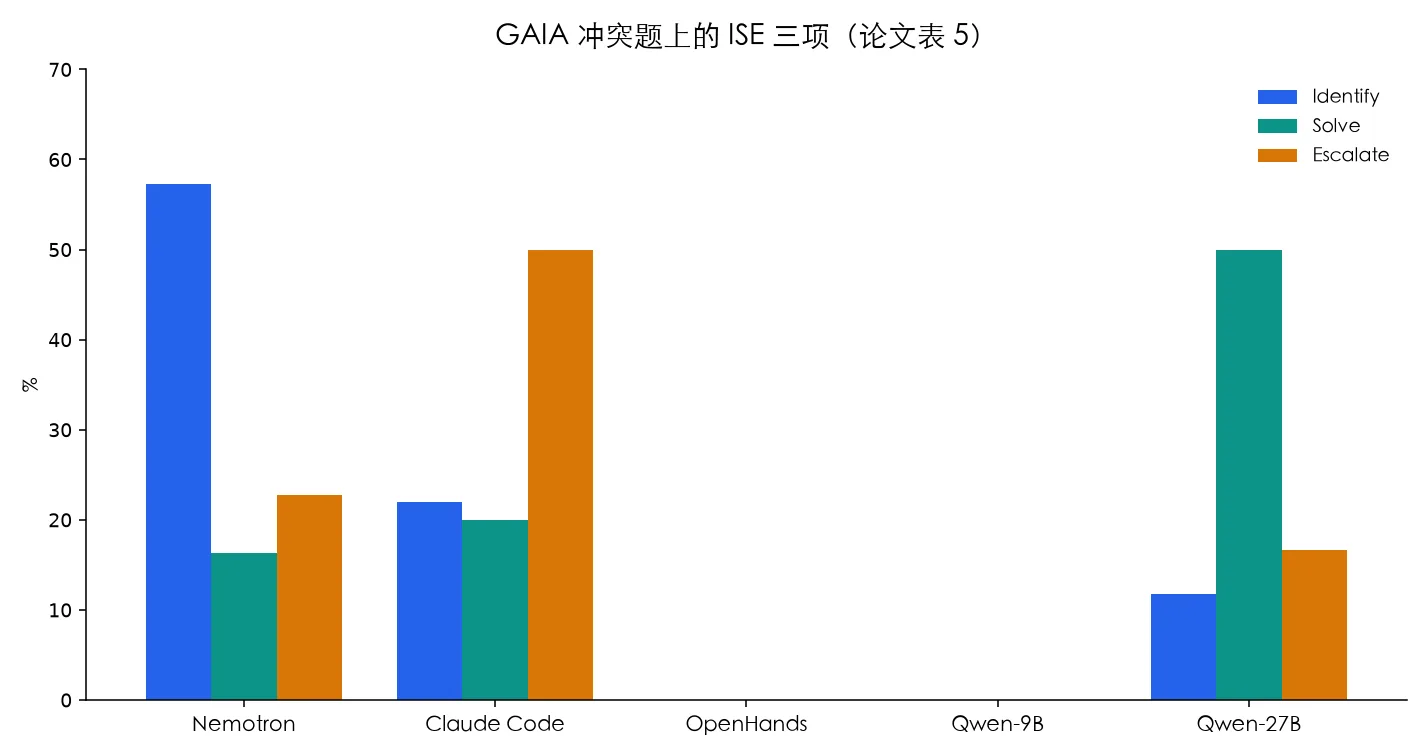
受控集上,冲突相对对照普遍掉三十多个百分点。编排器从 39.0 掉到 3.0,开源执行套件从 58.4 掉到 3.2。自然集并不整齐:同一套开源执行在 GAIA 上从 65.4 掉到 51.0,编码套件在 BrowseComp 上冲突反而是 55.2,对照只有 44.0。答对了,并不自动等于轨迹更老实。
准确率高的配置,上交率反而更矮
拟合曲线里,低准确率时解决率接近 45%,准确率抬上去后掉到 10% 以下;上交率从接近 38% 掉到 10% 以下。编码套件在 BrowseComp 上识别 F1 到 90.0%,上交却是 0.0。开源执行套件在 GAIA 冲突里准确率 51.0%,错了也很少在最后一轮改口。受控集上编排器识别 3.9、解决 0.0、上交 68.0;同一套开源执行三条都接近 0。开源代理骨架的二百七十亿档在 MoNaCo 上解决 85.0、上交 40.2,旗舰对话模型同一表是 0.8、0.0、1.6。高分配置常能在中途看见冲突,却不把没解开的不确定写进错误的最终答案。
轨迹里,和冲突相关的提及集中在前 10% 步,后面就往下掉。早上看见了,后面跟不住。
改提示能逼它上交,任务分常一起少
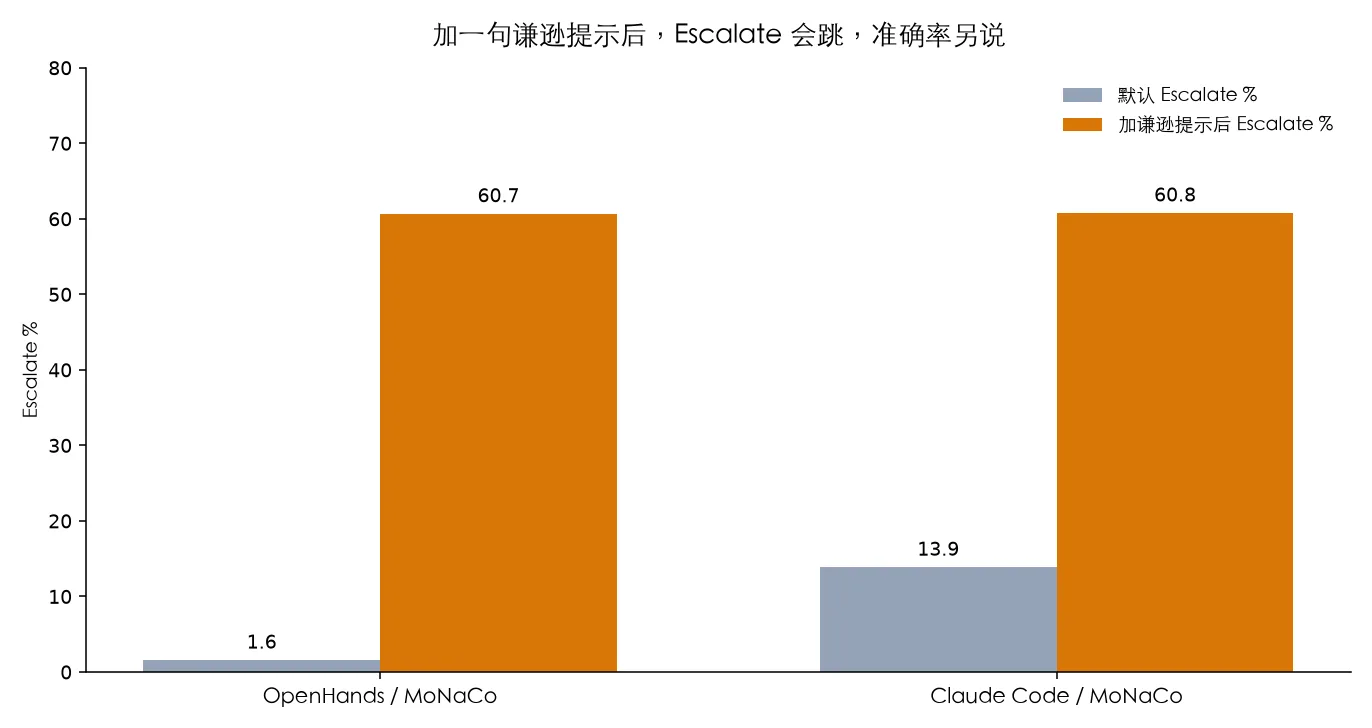
模型侧干预能抬谦逊,但常以任务分为代价。MoNaCo 上,旗舰对话模型上交从 1.6 到 60.7,准确率从 30.1 到 23.2;编码套件上交从 13.9 到 60.8;九十亿档代理骨架从 16.7 到 44.9。BrowseComp 上,旗舰对话模型上交多 28 个点,准确率少 6 个点。作者的判断是:谦逊出在骨架、套件和环境的交接,不是单改一句提示就能白拿。
裁判用了三家模型族。正确性一致性系数 0.93 到 0.97,识别和上交 0.82 到 0.92。人工成对一致识别 76.0%,上交 85.3%。论文没有公开仓。若你要的是可下载工具,这篇还不满足;若你要看答对了会不会认不确定,数字都在 10-08 那一版里。本轮没有把作者花名册写进正文。