字节笔记本
2026年10月10日 · 约 3 分钟读完
长对话记忆不该先建总图
长对话记忆常先砌一张总图,再什么问题都去那张图上抠。问句一偏,图上的边就变成噪音。这篇反过来:先把对话收成事件和轨迹,问句到了再做混合检索和重排,拼一块紧凑的工作记忆;局部图当成一个词,和文本一起喂给模型。方法写成 QGMem。论文号 2610.11920,2026-10-08 挂到 arXiv,十七页七张图,投的是模式分析汇刊。本轮没有项目仓。数字以论文表为准,不是本轮复现。
六套长记忆基准,主骨架是八十亿对话模型
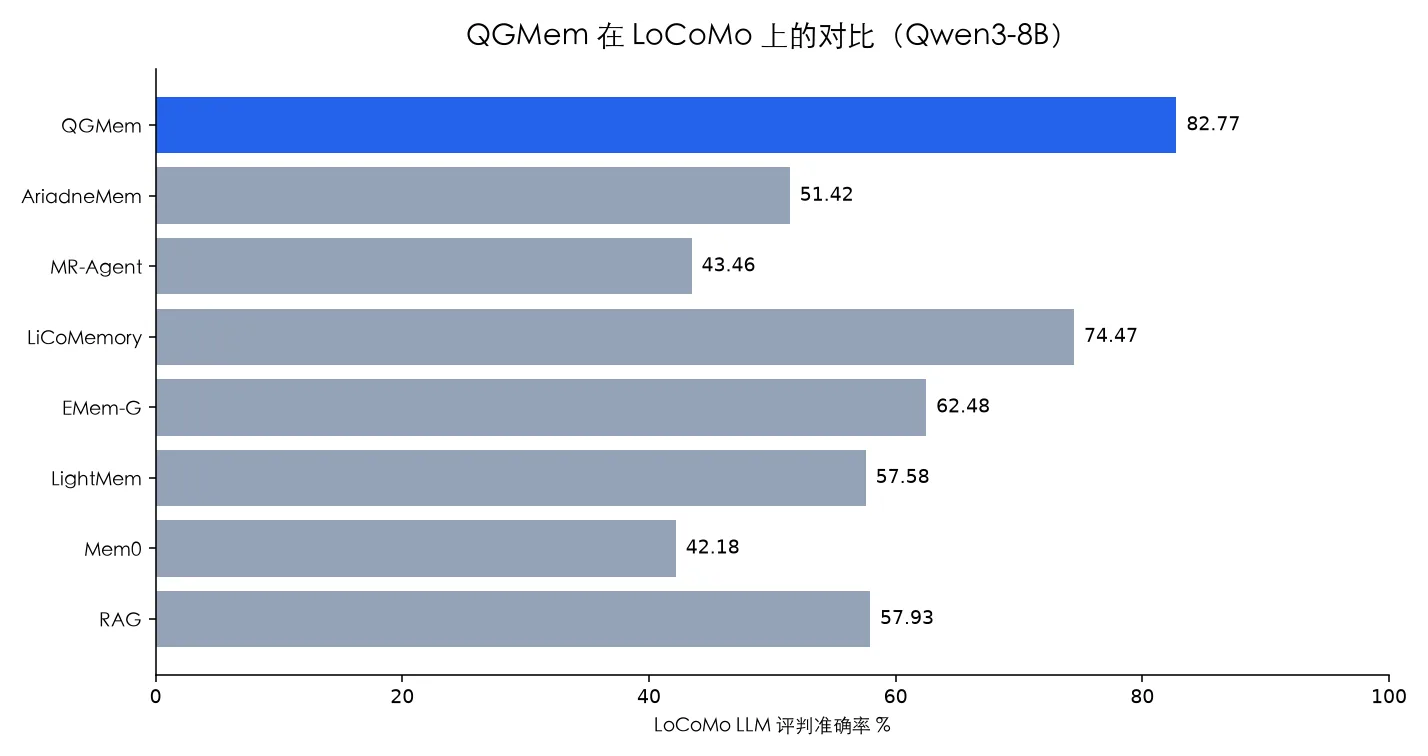
主结果用八十亿对话模型,另外两档是八十亿指令模型和一家小旗舰。LoCoMo 一千五百四十条,裁判分 82.77,加减 0.13;对齐分 56.31,加减 1.08;十回看排序 82.50;取回上下文大约 598 个词元。紧挨着的对照裁判分 74.47,差距 8.30。十回看检索召回 89.08、精度 20.92、够用率 97.11;普通检索排序 68.16,排序多 14.34,精度多 3.00。在线大约 1209 个词元、5.94 秒;离线摊下来 1.09 秒。
长记忆短集五百条,裁判 62.14,对齐 51.31,分别多 5.72 和 2.78。单跳事实四百条裁判 78.10、覆盖 80.58;多跳事实裁判只有 12.50、覆盖 13.34,这篇自己也没写漂亮。超长对话集十万词元 35.31,五十万 38.91,一百万以上仍过 35%,一千万 29.81,比轻量记忆对照多 20.18。三档骨架平均 64.58、56.00、70.11。
先切事件,问到再组局部图
默认取回十条、候选一百、窗口六、重排阈值 0.80。图卷积写了四层,学习率万分之一,训练对话记忆对一千六百三十四条。作者没有把一张全局图当默认工作区,而是让问句决定哪一段事件和哪几条轨迹进上下文。局部图只覆盖这次问句够得着的节点,当成一个词塞进提示,而不是把整张图展开成一长串三元组。
消融里,原子事件比图标记更值钱
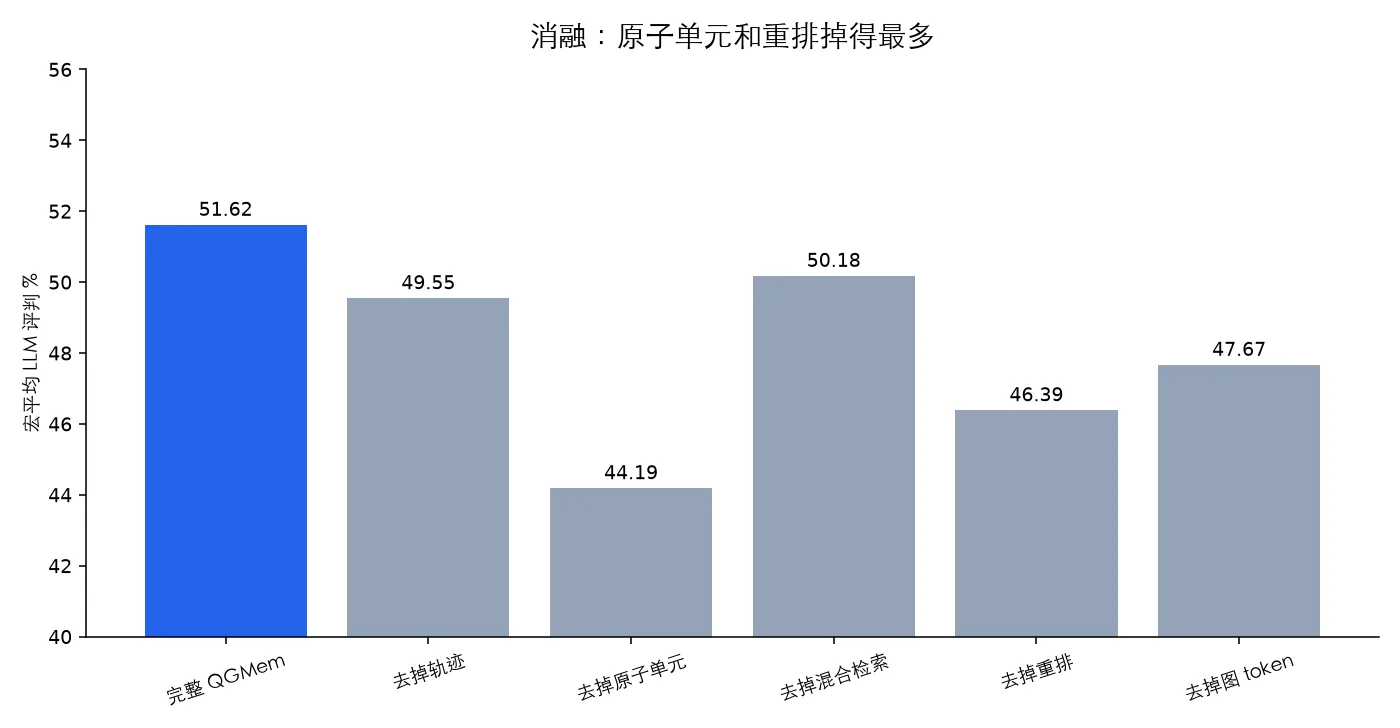
宏观分 51.62。拿掉原子事件掉 7.43,拿掉重排掉 5.23,拿掉图标记掉 3.95,拿掉轨迹掉 2.08,拿掉混合检索掉 1.44。图有用,但先把对话切对、问句到了再挑,比一上来建总图更值钱。多跳事实仍然矮,说明事件图不是万能钥匙。一千万词元还能站住,并不等于多跳已经解开;覆盖只有 13.34 的那一栏,提醒你别把排序分直接当成推理分。
论文页没有代码链接。若你要的是可下载记忆插件,这篇还不满足;若你要看长对话该不该先建总图,数字都在 10-08 那一版里。本轮没有把作者花名册写进正文。