字节笔记本
2026年10月11日 · 约 3 分钟读完
编码智能体的瓶颈,卡在理解不在改行
编码智能体的瓶颈,卡在理解不在改行
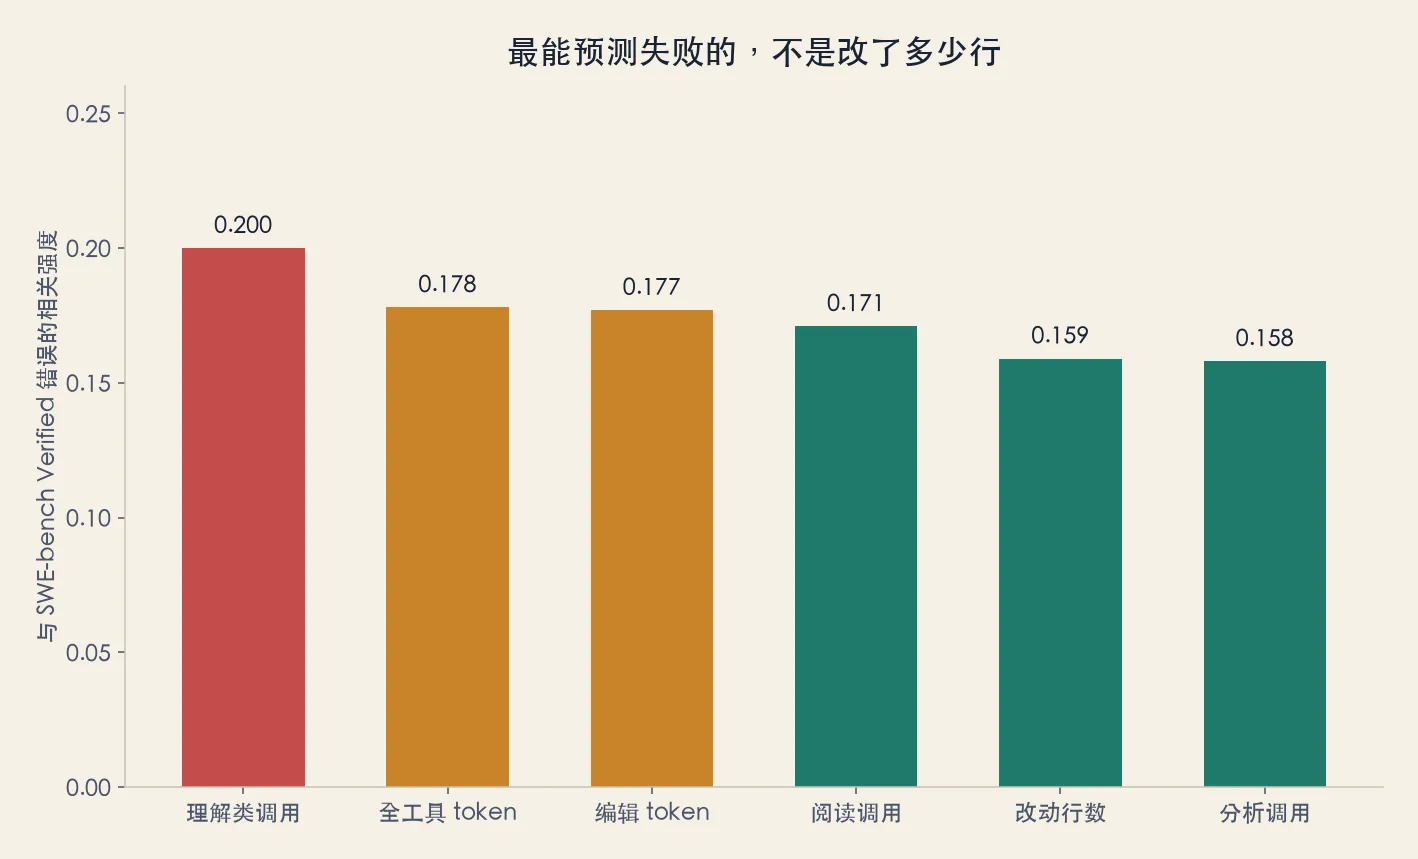
给智能体打分,常看改动行数和最终补丁。一项来自微软研究院与马里兰大学团队的合成评测把这条直觉拆开:6840 道按调用图生成的代码任务上,模型自己越大越吃力,智能体靠工具几乎全对;可最预测真实基准失败的变量,是理解类工具调用次数,不是编辑行数。代码理解才是瓶颈,评测设计也该顺着这一点来。
论文编号 2610.10610,标注为进行中预印本。框架叫 CABRA:把程序建成调用图,再套五种重构式编辑,难度沿四个轴放大,包括函数遍历、函数搜索、运行时推导和指令遵循。规模取六档,从 5 到 200,每格 20 张图。八家模型加六套编码智能体各跑一遍,光最终一轮就花了约 2.5 万美元。代码 MIT 开在微软名下,数据集按署名 4.0 放在开放平台上,一个月下载两万多次。
工具一接上,难度轴就换了
不带工具的模型,任务规模一上去准确率就掉。接上工具的智能体在遍历、搜索、运行时推导三个轴上几乎满分,靠的是检索、静态分析和直接执行。只有指令遵循这根轴例外:规模到 200 时智能体也开始滑,唯一个顶住的例外是 Opus 档。更有意思的是错位:小模型套上工具后,在大任务上反超了不带工具的更强模型。工具把理解外包出去,名次就重排了。
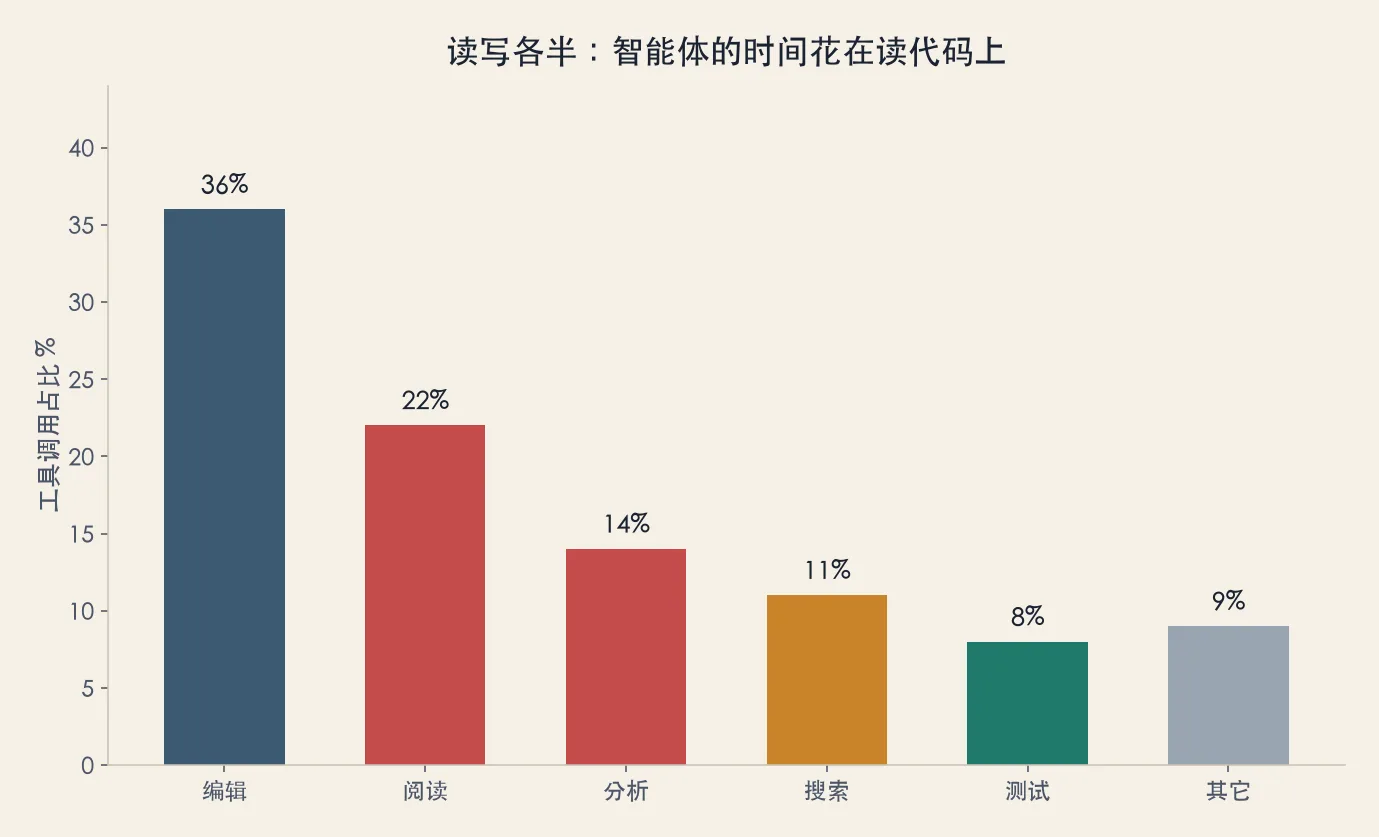
工具账单也说明问题。六套智能体的调用里,编辑只占 36%,阅读 22%、分析 14%、搜索 11%,加起来理解侧过半;会话开头四分之一里,读和分析占 48% 和 40%,首次编辑之前更是冲到 69% 和 56%。回到真实基准 SWE-bench Verified 上做相关分析,理解类调用次数与错误的相关最强,约负 0.200;编辑 token 约 0.177,改动行数只有 0.159。作者的原话是:智能体花力气理解代码,而不只是编辑。
合并任务把理解逼到极限
框架还加了一道等价抽取题:把两个类里的共享逻辑合并,同时保住若干处差异。类越长,智能体准确率越掉,理解类调用暴增而编辑量不变;大多数失败出在定位差异。保行为的比例倒是过九成,坏就坏在找不齐。不少不带工具的模型在这道题上始终不过五成。作者把这条轴写成将来放难度的地方:理解能力是可放大的难度源,比堆编辑行数更能分开高下。
观点很直接。给编码智能体做评测或挑工具,先看它读代码的调用结构,再看编辑输出。合成题应把理解成本做成显式难度轴,报告里也应同时给理解调用与改动行数。只报补丁行数,等于把智能体真正花钱花时间的那一段藏起来了。复现可从微软名下的仓库和开放数据集进,注意这是进行中预印本,数字以最终版为准。