字节笔记本
2026年10月11日 · 约 3 分钟读完
小米公开了全套 RL 配方,凭什么还扣着权重?
小米公开了全套 RL 配方,凭什么还扣着权重?
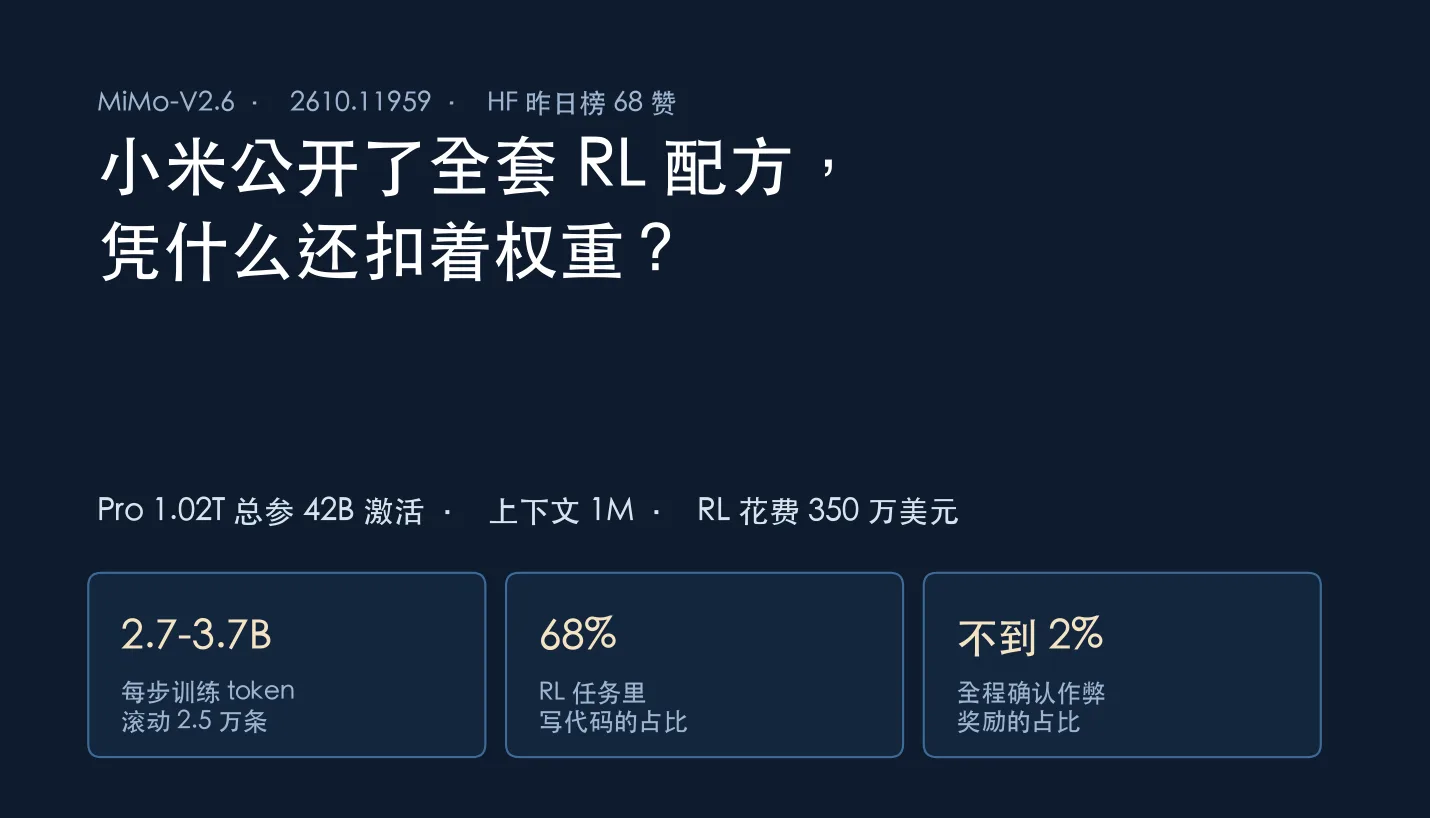
模型报告常见两种写法:只放分数,或者连权重一起放。小米的 MiMo-V2.6 走了第三条路:把强化学习后训练的账单、任务配比、防作弊机制和训练日志全部公开,训练环境与框架一并开源,唯独两家旗舰的权重没放。昨日榜单上它涨到 68 赞还在升。配方都给了,凭什么还扣着权重,值得拆开看。
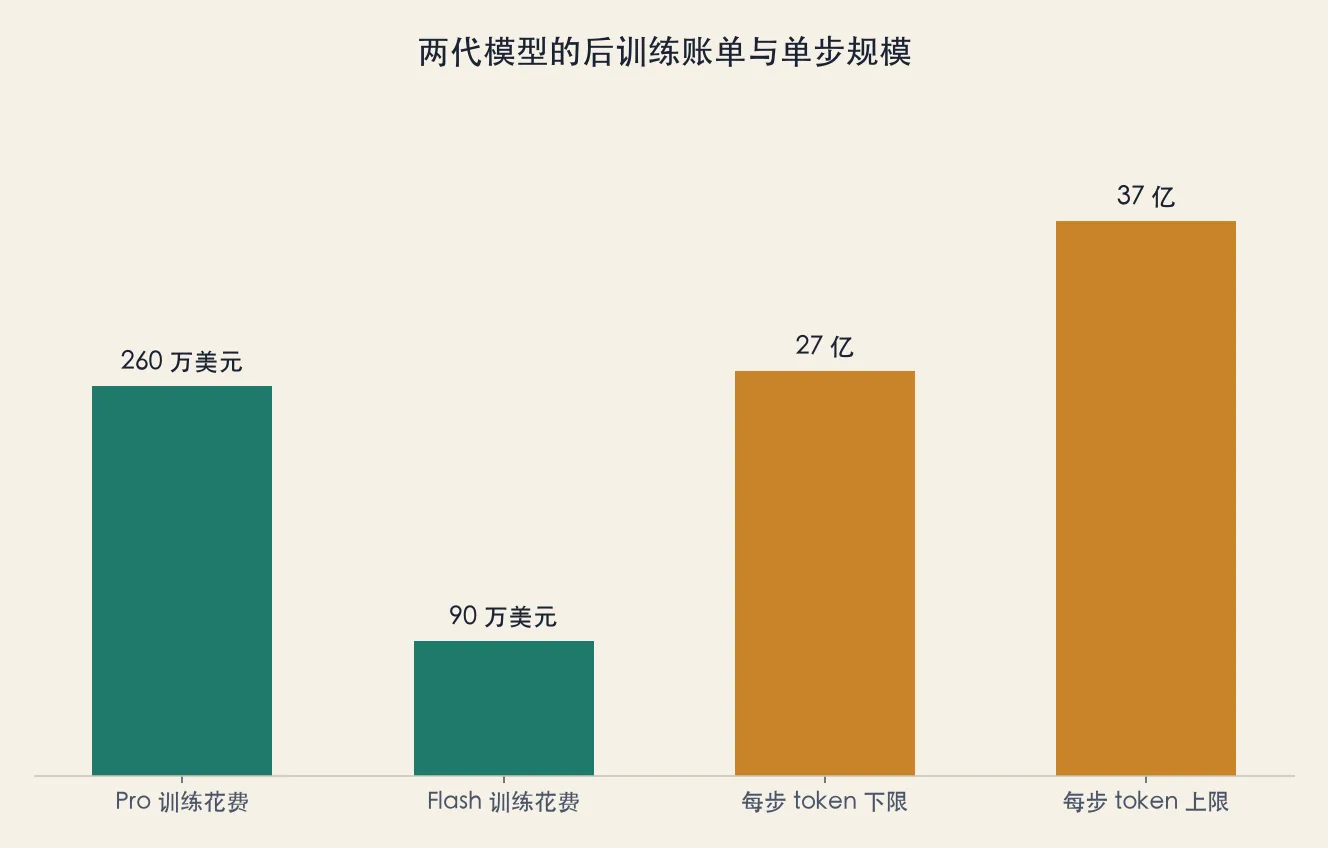
论文编号 2610.11959,作者团队来自小米。两代旗舰都是混合专家:Pro 总参 1.02 万亿、激活 420 亿,384 个专家选 8 个;Flash 总参 3100 亿、激活 150 亿。预训练规模 Flash 48 万亿 token,其中多模态占 22 万亿;上下文从 32K 练到 256K,中期训练再到 1M。后训练的账单写在明处:Pro 花了 260 万美元,Flash 花了 90 万美元。
一步 2.5 万条序列,账单花在哪一环
这套异步训练每步吃 1568 个提示、每组 16 条,一次滚动约 2.5 万条序列,训练 token 在 27 亿到 37 亿之间,单条序列约 11 万到 15 万 token。任务配比上写代码占 68%,工具使用 12%,界面审美 13%,网络安全 4%。账单结构也给了:Pro 那份里滚动占 43.8%,训练占 43.5%,裁判占 12.7%。
防作弊写得最实。环境先清理:断网、截断提交历史;再派一个专职的作弊审查模型做对抗筛查;离线再审计轨迹;确认作弊的奖励直接清零。全程确认作弊的占比压在 2% 以内。另一个工程细节是路由冻结:不冻结时专家负载塌方,变异系数从 0.78 飙到 2.0,冷专家从 0.5% 涨到 22%,冻结后才稳住。
分数追平旗舰,增量写在跨套件上
成绩单里,DeepSWE 是 71.9 对 67.9,终端基准 2.1 是 89.9 对 87.6,系统操作基准 82.0 对 80.8,网络攻防基准 94.0 对 95.1。作者把多个智能体基准与 Claude Opus 5、GPT-5.6 Sol 放在同一档讨论。更值得注意的是增量曲线:DeepSWE 平均三次通过率,Pro 从 58.4 涨到 72.6,Flash 从 48.7 涨到 65.7;换了没见过的运行框架,平均通过率从约五成涨到 66%。
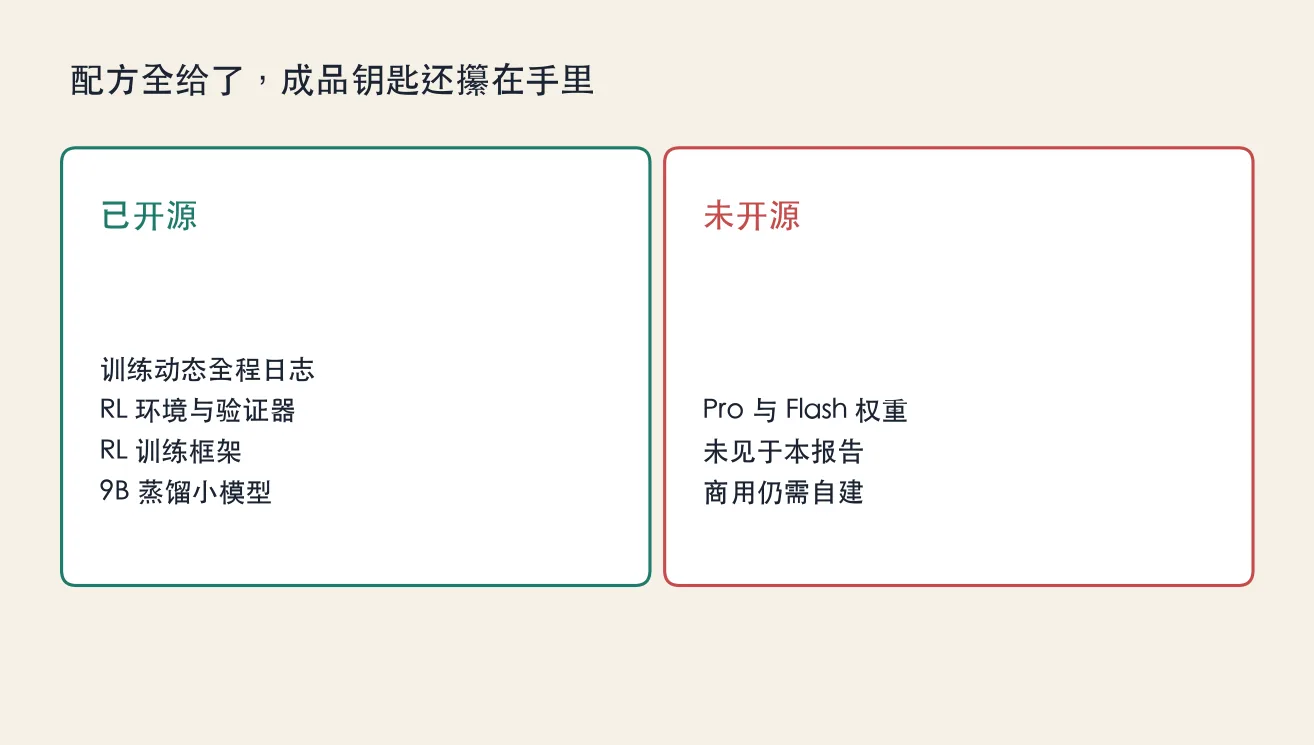
开源范围是这份报告最像宣言的部分:训练动态全程可查,RL 环境带验证器,端到端训练框架加一个可拼装的迷你运行面,另有一个 9B 蒸馏小模型。权重不在其列。作者的自改进框架需要环境、框架与日志配合复现,这三样都齐了;想直接用成品的人,拿到的只有蒸馏小模型。复现应从训练日志进,逐项对着任务配比和防作弊清单核。配方公开与权重保留并不矛盾,它把复现门槛压到研究级,把产品优势留在权重里。要问凭什么,这就是答案。