字节笔记本
2026年10月9日 · 约 4 分钟读完
编码 agent 跑偏时,凭什么不该用固定巡检?
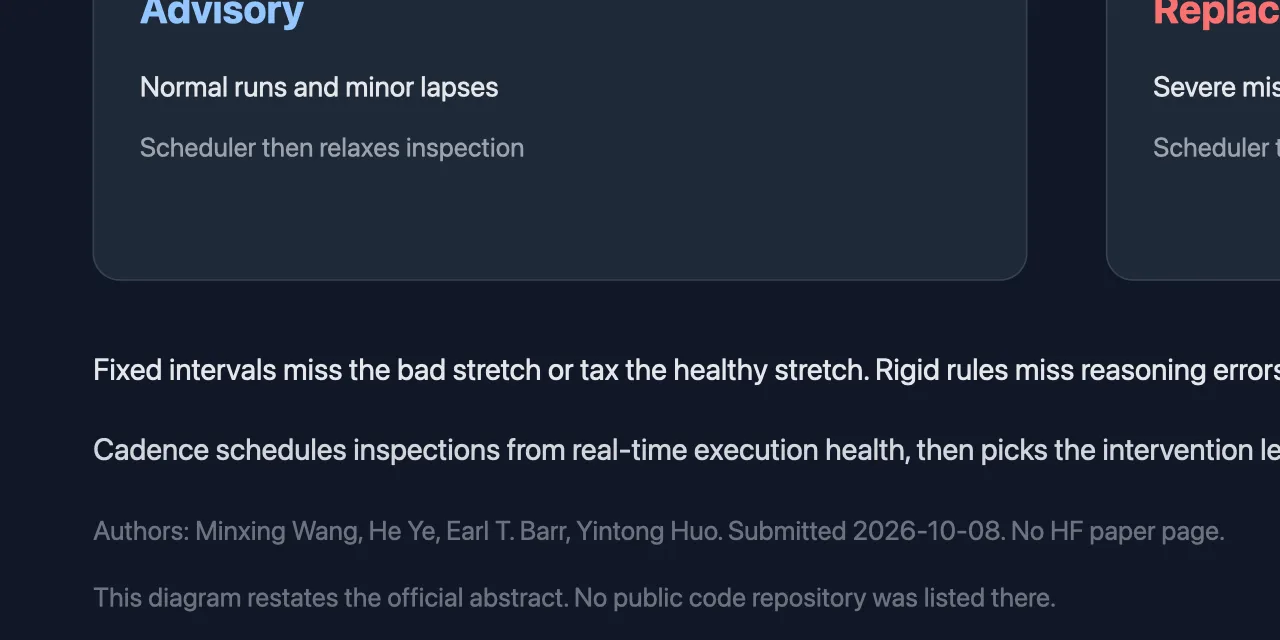
编码 agent 跑偏时,旁边那只监视器常常只会按固定节拍喊停。节拍太疏,严重跑偏已经走远;节拍太密,正常轨迹也被反复打断。启发式规则能抓住几种固定失误,却抓不住更绕的推理错误。Cadence: Strategic Guidance for Coding Agents 把监视改成按健康度调度:先看当前执行好不好,再决定查得勤不勤、干预到哪一层。
论文 2026-10-08 挂到 arXiv,编号 2610.12269v1,作者是 Minxing Wang、He Ye、Earl T. Barr、Yintong Huo。摘要里没有代码仓。本轮 Hugging Face 论文页仍是 404,事实以 export.arxiv.org 返回的摘要为准。
两层干预,调度器跟着走
Cadence 有两块。干预模块按轻重给指导:正常执行和小失误走咨询层(advisory),严重跑偏走替换层(replacement)。调度器再根据刚用的那一层调检查频率:替换之后收紧,咨询之后放松。作者把现有监视器的问题写成两头:固定间隔会错过严重失误,又会在健康执行上多花钱;刚性启发式抓不住复杂推理错误。
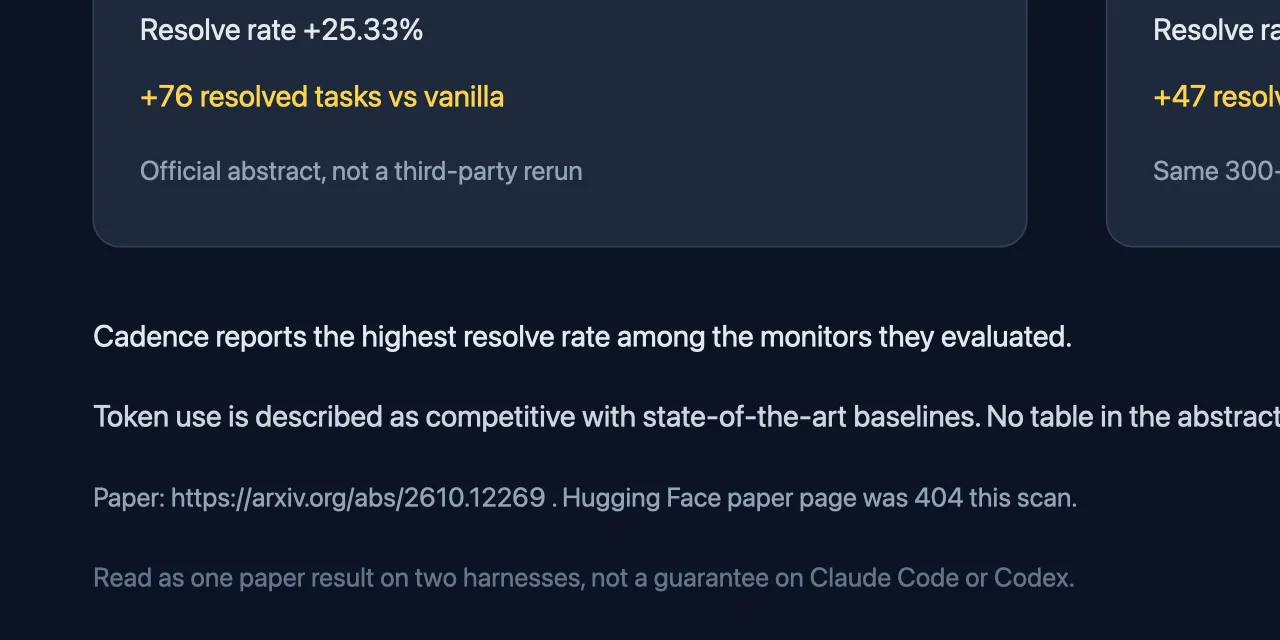
评测写在 SWE-bench Lite 的 300 道题上,覆盖两条不同 agent:mini-swe-agent 和 Moatless。摘要说 Cadence 在他们评过的监视器里 resolve rate 最高。相对原版 agent,mini-swe-agent 提高 25.33%,多解决 76 题;Moatless 提高 15.67%,多解决 47 题。token 用量写成和现有最强基线有竞争力,摘要没有再给一张对照表。
这些百分比是官方摘要数字,不是本轮复现。文章也不把它们外推成 Claude Code 或 Codex 上的保证。两条 agent 只是论文选中的评测床。摘要还写 token 用量和现有最强基线有竞争力,但没有把各监视器的花费逐项列出来。本轮能写进正文的,仍是那两组相对提升,以及 300 道 SWE-bench Lite。
和站内其它监视稿怎么分开读
站内已经写过不少给 agent 加一层外挂的工具。Cadence 的切口更窄:不管可视化,不管沙箱,只管什么时候看轨迹、看到什么程度。没有公开仓库,就谈不上安装步骤、许可证和复现脚本。若下轮作者放出代码,再核许可和评测入口。
固定巡检省事,却把“查得够不够勤”和“这一步该不该改写”绑死在同一根节拍上。Cadence 把这两件事拆开:先判断健康度,再决定是给建议还是直接替换,并让下一次检查跟着上一层走。替换之后收紧,咨询之后放松,听起来像运维里的自适应告警,只是对象换成了编码 agent 的轨迹。
同日 cs.SE 新稿里还有 TestPrism:300 个测试任务、3000 个候选实现,主指标 Joint Success Function 只要 28.00%,单参考答案成功率却有 59.67%。那是测测试质量,不是测运行时监视,本轮不并进这篇。读 Cadence 只需记住三组数:300 题、mini-swe-agent 的 25.33% / 76 题、Moatless 的 15.67% / 47 题。其余都还在摘要里,没有代码可核对。HF 论文页这轮仍是 404,不要把 Hugging Face 当第二出处。