字节笔记本
2026年10月9日 · 约 11 分钟读完
别再给每个模型各写一套 SDK 了,让网关吃 100 多家
每个模型一套 SDK、一套鉴权和一套报错,coding agent 还没开工,网关先裂开。LiteLLM 把这件事收成 OpenAI 形状的统一接口,既能当 Python 库,也能自己架一层网关。仓库 BerriAI/litellm 本轮核到 60494 星、12174 个 fork。GitHub 许可证字段是 NOASSERTION,打开 LICENSE 后能看清:enterprise/ 目录另有协议,其余按 MIT。
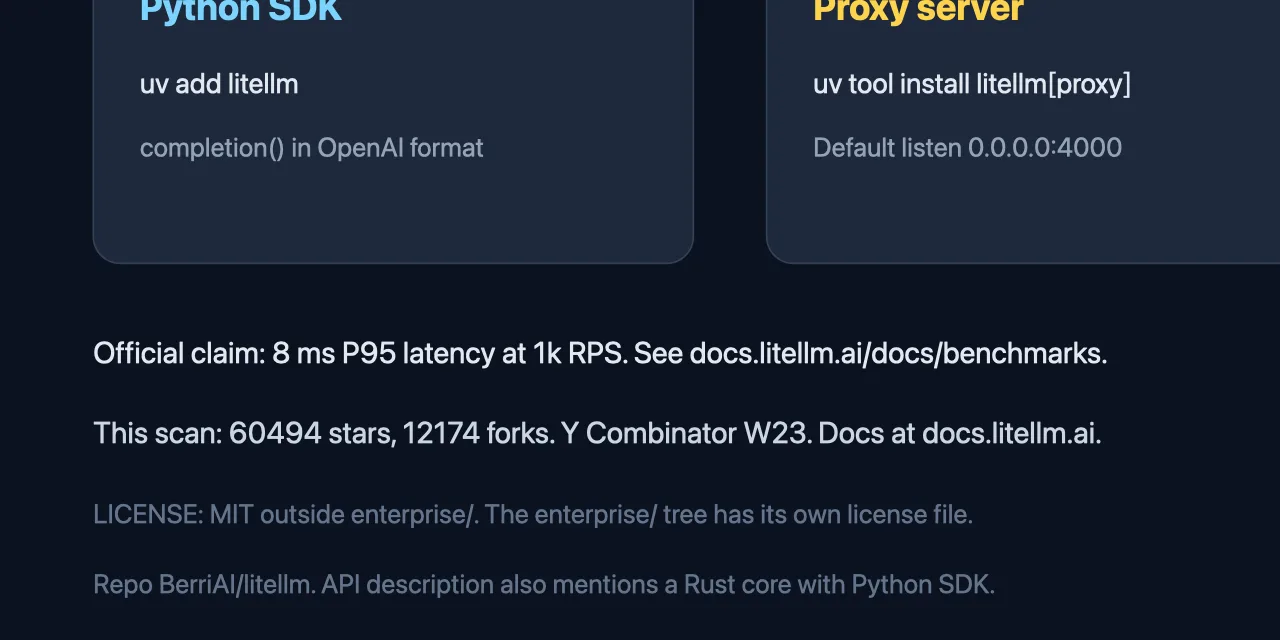
官方把自己写成开源 AI Gateway,覆盖 100 多家供应商,自托管,按 OpenAI 格式调用。文档站是 docs.litellm.ai。首页还写了官方延迟口径:1k RPS 时 P95 约 8 毫秒,出处是 benchmarks。这是仓库自己的数字,不是本轮复现。
先当库,再当网关
SDK 安装是 uv add litellm。同一套 completion() 可以打 openai/gpt-4o,也可以打 anthropic/claude-sonnet-4-20250514,环境变量各自放密钥。仓库另有一个 litellm-core 发行版:同样的 import litellm,但不带可选依赖、CLI 和仪表盘。两个包文件重叠,一个环境里只能装一个。核心发行版要自己编,构建脚本要 Git、uv 和 Rust 工具链。
网关侧是 uv tool install 'litellm[proxy]',再 litellm --model gpt-4o。客户端继续用官方 OpenAI SDK,只改 base_url 到 http://0.0.0.0:4000。虚拟密钥、花费追踪、护栏、负载均衡和管理后台,README 写成开箱能力。Y Combinator W23 的徽章也在仓库页上。
import openai

client = openai.OpenAI(api_key="anything", base_url="http://0.0.0.0:4000")
response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "Hello!"}],
)from litellm import completion
import os
os.environ["OPENAI_API_KEY"] = "your-openai-key"
os.environ["ANTHROPIC_API_KEY"] = "your-anthropic-key"
response = completion(
model="anthropic/claude-sonnet-4-20250514",
messages=[{"role": "user", "content": "Hello!"}],
)agent 和 MCP 也从同一扇门进出
仓库现在不只转聊天接口。A2A 一段写了 LangGraph、Vertex AI Agent Engine、Azure AI Foundry、Bedrock AgentCore、Pydantic AI。代理上可以挂 agent,再用 A2A SDK 打 /a2a/<name>。MCP 一段能把工具收成 OpenAI 格式,既可在 SDK 里 experimental_mcp_client.load_mcp_tools,也可在网关的 /chat/completions 里声明 type: mcp。Cursor 可以把 MCP 服务器指到 http://localhost:4000/mcp/,请求头用 x-litellm-api-key。
更贴近编码工具的是 harness 入口。文档示例用 litellm.agent,Harness 枚举里有 CLAUDE_CODE、CODEX、OPENCODE、DEEPAGENTS。模型写成 litellm_proxy/claude-sonnet-4-5 时,agent 的每次模型调用都走网关,并打上 harness,claude_code 这类标签。本机还要装对应 CLI(claude、codex 或 opencode);Deep Agents 则要 deepagents 和 langchain-litellm。环境变量是 LITELLM_PROXY_API_BASE 和 LITELLM_PROXY_API_KEY。去掉 litellm_proxy/ 前缀则直连供应商,不再走网关记账。
import litellm
from litellm import Harness, sandbox

result = litellm.agent(
    Harness.CLAUDE_CODE,
    "Find why tests/test_router.py is flaky and fix it.",
    sandbox=sandbox.local("./repo"),
    model="litellm_proxy/claude-sonnet-4-5",
)
print(result.text, result.cost, [f.path for f in result.files])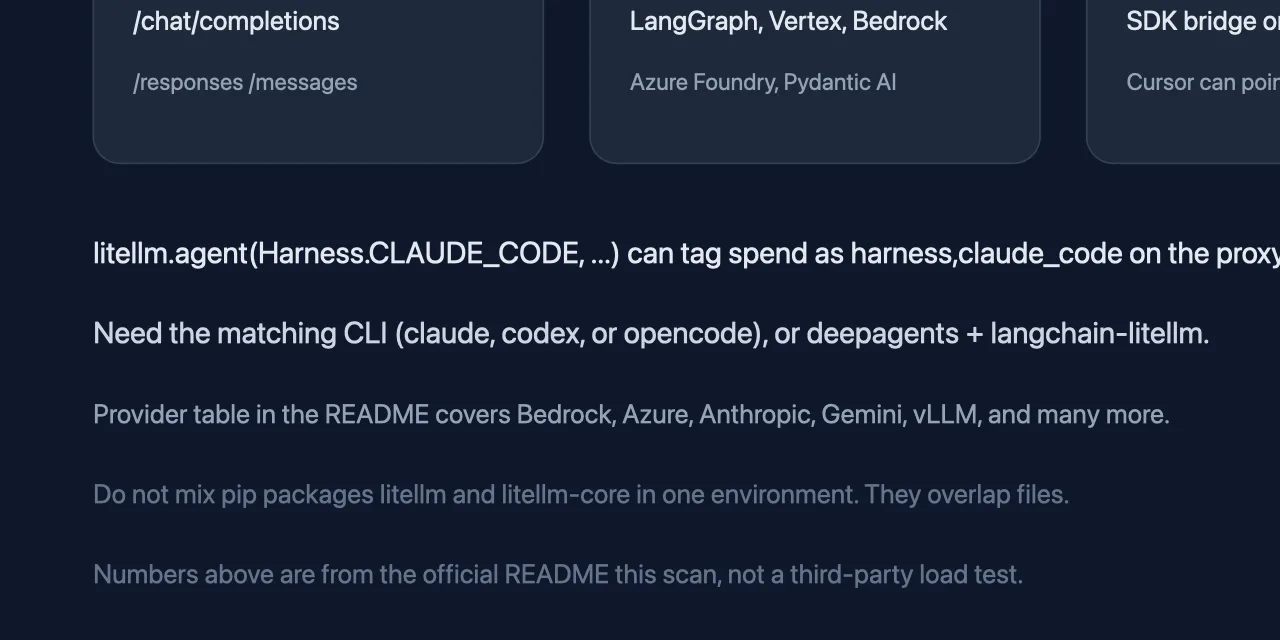
供应商表很长,企业档要分开看
供应商表覆盖聊天、消息、响应、嵌入、图像、语音、审核、批处理和 rerank。聊天接口勾了 Anthropic、Azure、Bedrock、Gemini、Groq、vLLM、GitHub Copilot 等;嵌入、图像、语音、批处理和 rerank 按供应商各有缺口。README 也写了 /embeddings、/images、/audio、/batches、/rerank、/a2a、/messages。企业托管代理和付费档在 litellm.ai/enterprise,和开源 MIT 部分要分开看。仓库页还挂了 Stripe、Google ADK、Greptile、OpenHands、Netflix、OpenAI Agents SDK 等 adopter 标识,本轮没有逐家核实他们怎么用。
库和网关解决的是同一类摩擦,只是边界不同。单人脚本用库就够:模型名换前缀,密钥换环境变量。团队一旦要把 Claude、Gemini、Bedrock 和自建 vLLM 收成一张账单、一套额度、一个后台,才值得把代理架起来。代理不是又一个 SDK,是把供应商差异挡在 4000 端口后面。
文档另有 Docker 入门页,教怎么先配虚拟密钥再打第一枪。本轮没有把代理真正拉起来,安装命令和端口以 README 为准。A2A 文档要求按 agent 设 protocolVersion 为 1.0 或 0.3,客户端依赖 a2a-sdk>=1.1.0。MCP 一段还提醒:上游若广告动态客户端注册却回 401 或 403,就要改成预注册的 client_id,必要时再加 client_secret。看见授权页不等于登录和工具调用已经通了。harness 返回值带 text、cost 和改过的文件路径,沙箱示例是 sandbox.local("./repo")。
本轮没有去官方基准页核对 8 毫秒是在哪台机器上测的。写进文章的硬数字,仍以 60494 星、12174 fork、100 多家供应商、1k RPS / 8ms P95,以及 LICENSE 的 MIT 加 enterprise 例外为准。日榜这轮还能看到这个仓库,周榜没有它。
什么时候上库,什么时候上代理
若只是本机换模型,先装 SDK。同一套 completion() 换前缀就能打 OpenAI 和 Anthropic,密钥放环境变量,不必先架 4000 端口。若要把 Claude Code、Codex、OpenCode 或 Deep Agents 的每一次调用都打进同一套额度,再上代理和 harness。代理吃的是 OpenAI 客户端,本地 CLI 仍要自己装;网关只负责把模型调用收口。
两套发行版不要叠在一个环境里。litellm 带代理、CLI 和可选依赖;litellm-core 只保留同一套 import litellm。README 写得很硬:核心发行版构建完必须装到干净环境,不要和完整包叠在一起。构建还要 Git、uv 和 Rust 工具链,发布集成还没完成时,只能从当前检出自己打轮子。
Cursor 走 MCP 时,配置里的地址是 http://localhost:4000/mcp/,请求头是 x-litellm-api-key。A2A 客户端示例把代理写成 http://localhost:4000/a2a/my-agent,鉴权用 master key 或虚拟密钥。这些都是仓库自己的接线,不是第三方封装。企业托管和付费档另有站点,不要和开源 MIT 部分混成“整仓都能商用”。
MCP 网关侧的调用也写进了 README:/v1/chat/completions 里把工具声明成 type: mcp,server_url 写成 litellm_proxy/mcp/github 这类标签,再配 require_approval。SDK 侧则是先起 ClientSession,再 experimental_mcp_client.load_mcp_tools,把工具收成 OpenAI 格式后交给 acompletion。两条路都还标着实验接口,本轮没有在本机打通一次真实的 GitHub MCP。
文档站还把端点收成一张总表:/chat/completions、/responses、/embeddings、/images、/audio、/batches、/rerank、/a2a、/messages。不是每家供应商都勾满。Infinity 和 Jina 这类只在嵌入列打钩,Fal AI 偏向图像,Deepgram 偏向转写。选模型前先对这张表,不要默认“网关在就能出图或出声”。