字节笔记本
2026年10月9日 · 约 10 分钟读完
边缘判定不吐字,凭什么 3B 能压过 35B 专家
边缘侧要的是判定,不是又一段生成。Liquid AI 在 2026-10-07 的博客 Multimodal open d1 decision models for the edge 把开源权重的决策模型写成:一次前向给出是/否、选项或分数,零个生成 token。主模型 LiquidAI/d1-3b 卡片写 3.12B 参数、BF16 大约 6.25 GB,基座 LiquidAI/LFM2.5-VL-3B,许可证 lfm1.0。本轮卡片 7302 次下载、224 likes,创建 2026-10-05,最近改 2026-10-07。HF 路径大小写并存,博客示例写成 LiquidAI/d1-3B,卡片页是 d1-3b,加载时按官方示例走,不要自己改名。
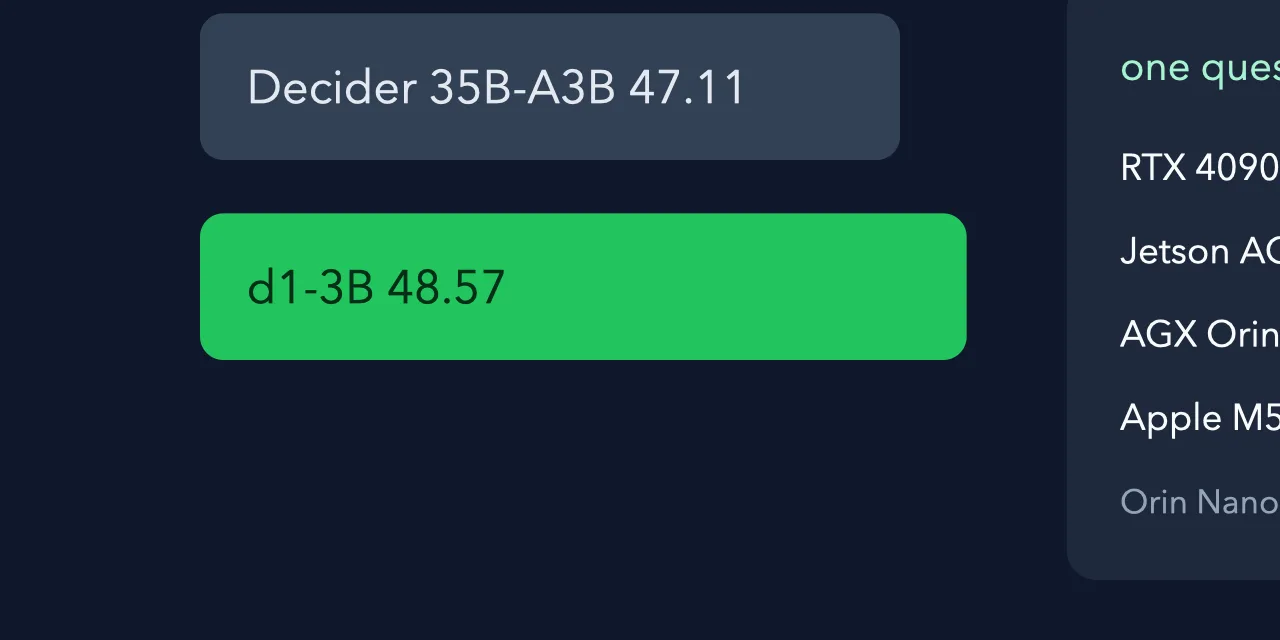
Decision Index 0.2.1 上,d1-3B 拿 48.57,博客写成 10B 以下最好,并写出超过所有列出的 4B/9B,以及 Decider 35B-A3B 的 47.11。七个公开集均值 82.9。实验款 LiquidAI/d1-omni-600M 587M 参数,基座 LFM2.5-Encoder-350M,同许可证,本轮 9473 次下载、90 likes,创建 2026-10-05,最近改 2026-10-07;七集均值 78.4,指数只有 15.95,另有 Fast Decisions 76.9。博客写它是早期研究版,还在改,也没有速度表。视觉和音频公开分榜没报:Decision Index v0.3 的视觉分是私有的,音频决策基准还没立住。d1-3B 吃文本加图;omni 吃文本加图,或文本加音频,卡片写两者不能同时带。
一次前向凭什么够用
卡片把任务写成:状态可以是文本、JSON 或图,问题按 Decision Index 的 noul / choice / score 填。模型不聊天,不吐续写。32k 上下文,视觉编码器写 SigLIP2。博客示例用 transformers>=5.14,trust_remote_code=True,调用 system_one 或 system_one_batch。图可以单独进状态。演示空间是 LiquidAI/system-one-arcade。本轮没有本机复现。基座链写成:d1-3B 从解码器型 LFM2.5-VL-3B 来,后者再从 LFM2.5-2.6B-Base 来;omni 从双向编码器 LFM2.5-Encoder-350M 来,再加视觉和音频编码器。博客引用写成 2026 年 Liquid AI 博文,没有单独开源训练仓。
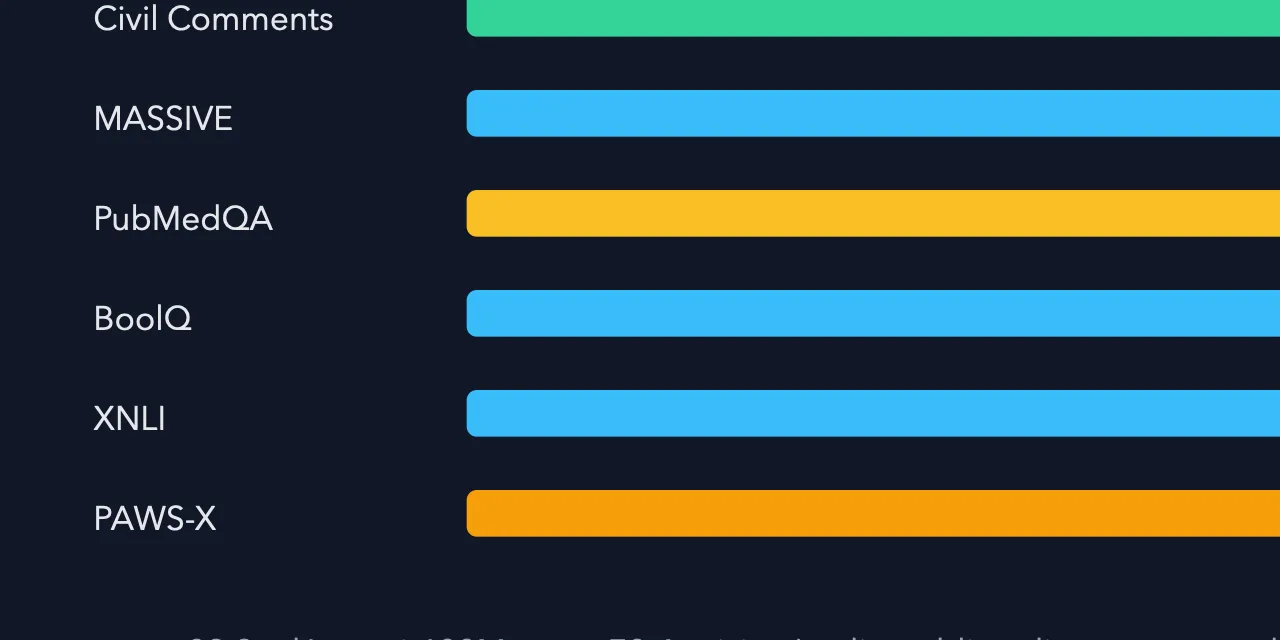
七个公开集(博客表,d1-3B / omni / Decider 2B / Decider 4B):SQuAD 2.0 83.3 / 74.0 / 67.7 / 76.0;Civil Comments 93.3 / 95.8 / 93.6 / 92.8;MASSIVE 意图 86.9 / 86.1 / 81.1 / 88.3;PubMedQA 68.3 / 61.3 / 65.7 / 63.3;BoolQ 86.3 / 77.7 / 87.3 / 89.0;XNLI 85.6 / 74.7 / 85.0 / 88.6;PAWS-X 76.4 / 79.5 / 59.5 / 69.8。均值 82.9 / 78.4 / 77.1 / 81.1。omni 在 Civil Comments 和 PAWS-X 上高于 3B,但指数只有 15.95,不要把七集均值和指数当成同一把尺。卡片另写 11 个视觉基准均值 74.1,基座 73.9;内部基准均值 77.1;DecisionBench 71.8;SQuAD 卡片写成 85.3、Civil Comments 93.0,和博客七集表不完全同一口径,引用时要写清来源。这些是官方数字,不是本轮复现。
时延只给了 d1-3B。单问 / 三问 / 3.4k token 状态 / 384 像素图 / 每秒打包状态:Apple M5 Pro 30 / 41 / 640 / 62 / 78;Jetson AGX Thor 16 / 20 / 220 / 35 / 262;AGX Orin 64GB 26 / 35 / 560 / 83 / 110;Orin Nano 50 / 73 / 1640 / 202 / 38;RTX 4090 8 / 21 / 102 / 17 / 475;AMD MI325X 9 / 14 / 44 / 18 / 1106。三问大约是单问的 1.3 倍。卡片把 4090 单问 8 ms 写成编译后的数。数字绑在官方表上的设备和编译设置,不要外推成任意手机。omni 没有速度表,不要拿 3B 的毫秒去估 600M。
本机怎么接到零 token 出口
卡片写兼容 vLLM / SGLang / Docker 做服务。最小路径是 Transformers。问题字典要按指数 schema 来,类型写错就不是这篇评测里的数。博客示例图用的是 COCO 验证集一张猫,那只是调用演示,不是评测集。本轮不把那张外链图搬进正文。
pip install "transformers>=5.14" torch torchvision pillowfrom transformers import AutoModel
model = AutoModel.from_pretrained(
"LiquidAI/d1-3B", trust_remote_code=True
)
print(model.system_one(text, questions_dict))
print(model.system_one(None, questions_dict, images=[photo]))
print(model.system_one_batch([...]))d1-omni-600M 同样走 system_one。卡片写图和 16 kHz 音频可以进状态,但不能同时带。指数分 15.95 说明它还不是主榜选手,当研究入口即可。两份权重都写 lfm1.0,不是 MIT / Apache,商用前先读许可证,不要默认能进产品。卡片把 d1-3B 写成微调自 LFM2.5-VL-3B,不是从零训的 3B 聊天模型。下载数本轮 3B 七千出头、omni 九千出头,热度在权重站,不在 GitHub 日榜。
站内写过决策模型生态和 llama.cpp 的决策端点,那是接口层。这篇只谈 Liquid 放出的两份开源权重和官方表。mini-AGI 是消费卡上按字节持续学习,和一次前向判定不是同一条路,不要并成一篇。JEV-27B-VL 那篇谈的是看关卡做决策,体量不在 3B。读这篇先核对四件事:出口是不是零 token;48.57 是不是绑在 Decision Index 0.2.1 和 10B 以下;许可证是不是 lfm1.0;omni 600M 是不是仍标早期研究、没有速度表。HF Daily Papers 今日仍被 AgentGarten、TokenRouter 压着,那两篇站内已有,不并进。DreamTrue、OuroWorld、ME-World 同日也有仓,星数都在个位数到三十出头,本轮不拿来垫。CoTrace 论文写 Qwen3.5-9B 从 78 做到 88、在线强化学习到 90,但没有公开仓,也不并进这篇。Falcon ASR、Open TTS Leaderboard、Holo4 仍在队列里,分别是语音识别、TTS 评测和计算机使用模型,和零 token 判定不是一条产品线。读权重先看 lfm1.0,再看 Decision Index 版本号,最后看 omni 是不是还标着早期研究。博客没有单独开源训练代码仓,复现只能从 Hugging Face 拉权重再走 Transformers。卡片把服务写成 vLLM、SGLang、Docker 都能接,本轮没有核这三条服务端的版本号,不要把兼容写成已经在本机跑通。In-context Robot Learning 配套仓 simple-icl 本轮只有 9 星,也不并进。once 命令行缓存只有 62 星,更不该拿来垫决策模型这篇。PHRBench 看的是幻觉之后怎么继续推理,CoTrace 看的是终端 agent 的数据配方,两篇都是论文向,和边缘侧一次前向判定可以并排,不要并成一篇。读完先自己跑一张图加三条 noul/choice/score,看出口是不是真的零 token,再决定要不要把 lfm1.0 读进法务流程。本轮打开的是 2026-10-07 的博文和两张模型卡,数字以这两处为准,不把社区转述写进正文。