字节笔记本
2026年10月9日 · 约 4 分钟读完
企业 agent 栽在自家流程时,这样补训练题
企业里的 agent 不是不会用通用工具,而是栽在自家系统、自家规则和自家数据状态上。一条失败轨迹能说明问题,可训练要的是一批新任务:能在环境里跑完,像真人会提的需求,还得有靠得住的验收。ServiceNow CoreAI 在 Hugging Face 博客写了 AutoSynthData,用目标模型的失败和更强教师的成功,决定下一轮该补哪块能力。发布日期写在页面元数据里:2026-10-02。
这篇没有单独开源流水线仓库。能核到的落地物是数据集 ServiceNow-AI/EnterpriseOps-Gym,以及文中点名的三个模型:目标 google/gemma-4-26B-A4B-it,Hybrid 教师 Qwen/Qwen3.8-27B,ITSM 教师 deepseek-ai/DeepSeek-V4.1-Flash。
先写成可执行任务,再决定要不要进训练集
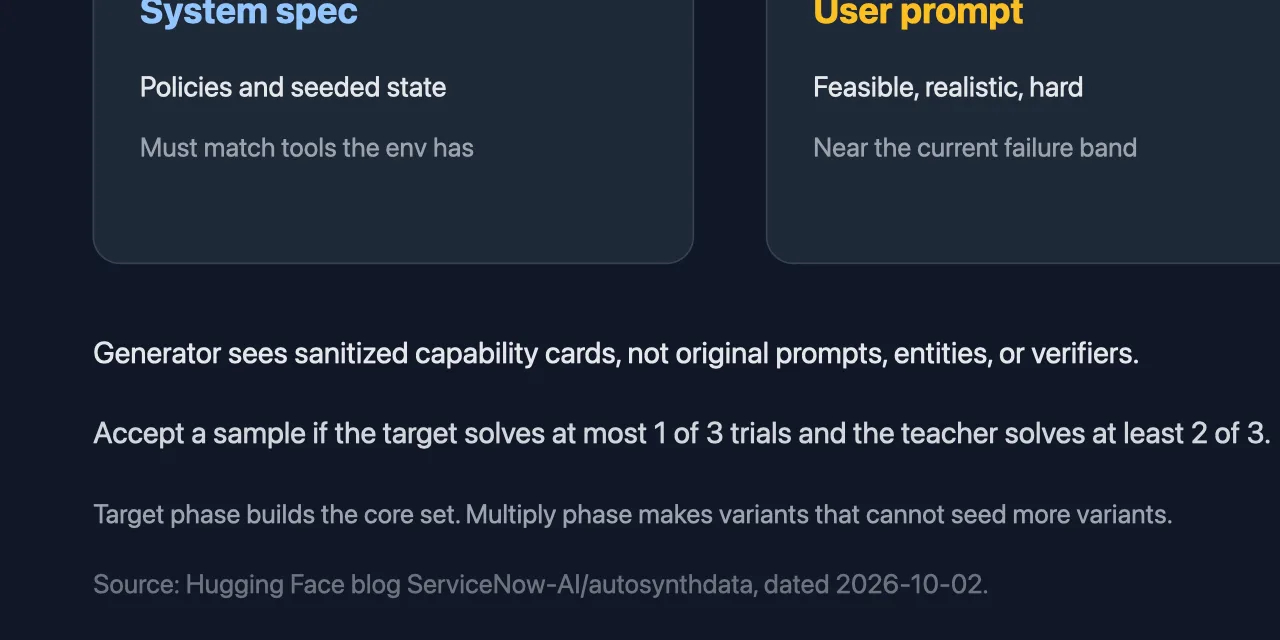
官方把任务写成三元组:系统规格、用户提示、验收器。系统规格管指令、策略,以及必要的初始状态,比如种子数据库或知识文章。提示要同时满足三件事:环境里至少有一条合法轨迹(可行性);像这个环境里的人会问的话(真实性);还得打在当前模型的薄弱带上(难度)。已经稳定做对的题,训练信号很薄。
验收器也有三条:和提示、规格、任务状态一致;错误轨迹必须被拒;合法解法都该过,不能只认一条参考路径。松了会奖励错行为,紧了会惩罚对的走法。
生成器看不到原始评测题的提示、实体、轨迹和验收细节。它只拿到洗过的能力说明卡,再造新提示、新状态和新解法。目标阶段并行产核心样本,每条都过验证、执行、解题评估和修复。扩展阶段只从已收下的目标样本再变体,变体不能再当种子,避免一代代漂。
样本门槛写得很硬:目标模型三试至多过 1 次,更强解题器三试至少过 2 次。还有正例门(参考轨迹执行后,验收必须认)和负例门(改坏结果后,验收必须拒)。过不了的先交给批评器修,修完重新过门,重试次数有上限。
两个域上的 SFT 数字,先当官方实验读
Hybrid 域:目标 Gemma-4-26B-A4B-it,教师 Qwen3.8-27B。流水线在大约 18 小时里生成 2000 条合成训练样本,微调后最好的检查点是 epoch 5。合成 SFT 把平均 Pass@1 提高 7.2 个百分点,相对提升 35%,验收成功率从 63.01% 升到 68.55%,并补上 Gemma 和参考模型之间原 Pass@1 差距的 59%。
ITSM 域:目标仍是 Gemma-4-26B-A4B-it,教师换成 DeepSeek-V4.1-Flash。生成 1994 条,花了 66 小时。文中解释,时间更长主要因为教师更大,而且这次跑在后续吞吐量优化之前。ITSM 上平均 Pass@1 从 18.77% 升到 27.18%。
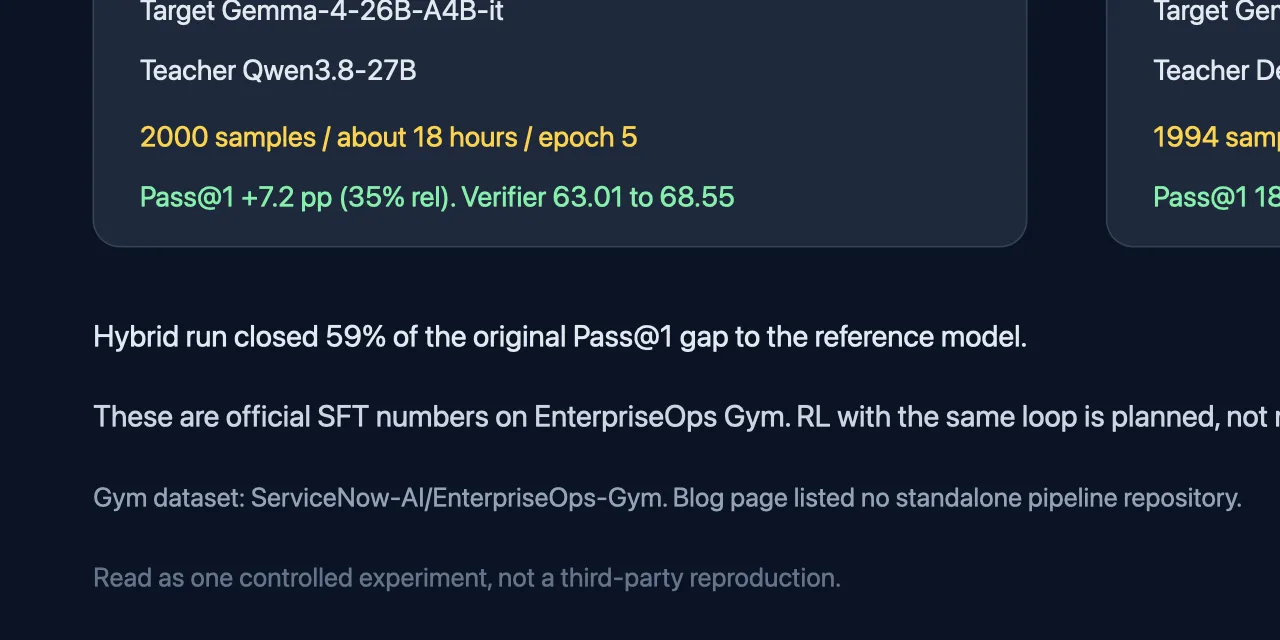
这些数字都来自官方博客,不是第三方复现。实验只报了 SFT。同一套“先找能力边界、再生成、再训练”的圈,作者说也可以拿去试强化学习,但还没交出 RL 数字。
质量不只卡单条。批次层还会看覆盖、多样性,以及有没有把预算砸在低产出模式上。控制器会少产已经堆满的区域,多产缺口;某一类候选反复差,就改生成策略。读的时候记住边界:提升发生在 EnterpriseOps Gym 的 Hybrid 和 ITSM 两个受控环境里,生成器没有吃到原评测题原文。